文章目录文章开头0%
据 Nieman Lab 与 PPC Land 报道,Meta 近期修订了商业条款(Meta Commercial Terms),预计于 10 月 30 日正式生效。新版条款在第 1 节加入一段自动化软件授权:凡出于商业目的使用 Meta 产品的企业,皆授权 Meta 派遣网络爬虫(Web Crawler)进入其产品或服务关联的外部网站,抓取数据并用于“训练”旗下产品与模型。
这项条款采用默示同意制,且深度绑定了 Facebook 粉丝主页、Instagram 商业账户与广告管理工具(Ads Manager)。企业只要在 10 月 30 日后继续登录投放广告或维护社交媒体,按 Meta 条款即视为同意授权,合同中并未提供单独退出爬虫授权的选项。
10 月 30 日生效的新条款改了什么?
对比 2024 年 3 月 6 日生效的旧版条款,过去第 1 节仅规范企业“主动上传、发布或分享至 Meta 平台”的素材(content you share, post or upload on or in connection with the Commercial Products),要求企业确保 Meta 拥有在平台内展示与分发这些素材的权利。然而在 10 月 30 日生效的新版条款中,第 1 节标题从“授权(Licences)”改为“你提供给 Meta 的授权与权利(Licences and rights you provide Meta)”,授权标的直接延伸至站外的独立域名。
根据新版条款原文,企业授权 Meta(或代表 Meta 的任何实体)使用网络抓取工具、机器人、蜘蛛、爬虫与用户代理程序(web scrapers, bots, spiders, crawlers, user agents),并建立“测试凭证(test credentials)”,定期访问、索引、缓存、分析、收集与爬取“与你的产品或服务相关”或“通过使用 Meta 产品而提供”的域名与网址。条款载明,Meta 得使用这些域名中的任何内容(any content),来提供、开发、改进、研究、训练(train)及维护 Meta 旗下产品与服务。
合同边界的根本转移:过去平台商业合同的管辖范围,停留在企业“主动上传至平台内部”的图文素材;新版条款则将合同效力延伸到企业自有的独立域名,将相关站外内容纳入 Meta 可能主张的模型训练与产品研发授权范围。
在适用对象方面,新版条款扩大了“商业用途”的认定范围。除了传统的投放广告、销售商品、开发应用程序与管理粉丝主页外,明确列入“发送营销信息”、“创建或使用产品目录”,以及“使用任何商业产品,例如 Ads Manager 或 Meta Business Suite”。第 7 节则规定,只要在收到更新通知后继续出于商业目的访问或使用 Meta 产品,即代表同意受新条款约束。若企业不同意授权,唯一的途径是全面停用所有 Meta 商业工具。
Meta 官方说法与合同文字的落差
针对外界质疑新条款等同于让 Meta 免费爬取新闻媒体与品牌内容网站,Meta 发言人 Andy Stone 于 10 月 16 日在 X 上回应称报道“不实”。他表示 Meta 使用网络爬虫的方式并未改变,网站拥有者依然可以通过 robots.txt 标示偏好;此次更新的目的是确保 Meta 在平台内进行广告与内容推荐时,能从第三方网站抓取准确的待售商品信息,而非为了抓取新闻网站。Meta 公关部门回复 Nieman Lab 时也补充,相关爬虫条文过去分散在生成式 AI 广告等不同条款中,本次只是将其整合至同一处。
对照 Meta 的产品布局,官方解释确实呼应了近期的电商整合需求。Meta 于 9 月 29 日将旗下 AI 智能体 Muse 扩展至小型企业,让其访问广告账户与 15 项商业工具(延伸阅读:Meta Muse 是什么?Amazon 为何封锁 Meta 的 AI 智能体?);随后又计划在广告系统中引入站内商品实时浏览功能。无论是动态广告推荐还是 AI 智能体代客比价,都高度依赖实时且准确的站外商品规格与库存数据。
然而,发言人的公开说明描述的是 Meta“目前的商业意图”,商业条款写下的则是“Meta 要求企业接受的授权范围”。三位应 Nieman Lab 之邀审阅条款的法律专家指出,按条款文字,Meta 可能据此主张已取得爬取新闻与原创内容、并用于训练 AI 的合同授权。条款并未将爬取标的限制在“待售商品页面”或“产品目录”,而是涵盖与产品或服务相关网址上的“任何内容”,且白纸黑字包含了“训练”一词。康奈尔大学法学院教授 James Grimmelmann 直言,对以新闻报道为核心产品的媒体,或拥有大量专栏文章与研究报告的品牌网站而言,整座网站都落在“与产品或服务相关”的定义中。
| 比较维度 | 官方对外说法(Andy Stone / 公关) | 新版商业条款原文(10/30 生效) | 实质法律与运营意涵 |
|---|---|---|---|
| 爬取目的 | 抓取第三方待售商品信息,用于广告推荐与商品展示 | 提供、开发、改进、研究、训练(train)与维护 Meta 产品与服务 | 条文明确纳入 AI 模型训练授权,范围超越广告导购索引 |
| 涵盖范围 | 强调“不是为了爬取新闻网站” | 与产品或服务相关之域名中的任何内容(any content) | 新闻媒体或品牌专栏皆属于“与产品或服务相关”的标的 |
| 技术拦截 | 网站运营者仍可通过 robots.txt 管理爬虫偏好 | 全文未提 robots.txt,无任何技术排除保障 | Meta 可能主张合同授权优先;是否成立仍有解释与适用争议 |
| 访问权限 | 未正面回应是否会绕过付费墙 | 得建立测试凭证(test credentials)进行访问与爬取 | 引发以自动化账户访问注册墙(Registration Wall)后内容的疑虑 |
条款中允许建立“测试凭证”以访问域名的文字,更引发法律界对注册墙与会员专区的疑虑。Grimmelmann 指出,这在技术上等于授权 Meta 以自动化方式注册账户,借此绕过网站的注册限制。条款未对测试凭证的使用边界做出限缩,Meta 也拒绝回应 Nieman Lab 关于该凭证是否会用于绕过付费墙或付费内容的询问。
当商业合同遇上 robots.txt,技术拦截还有效吗?
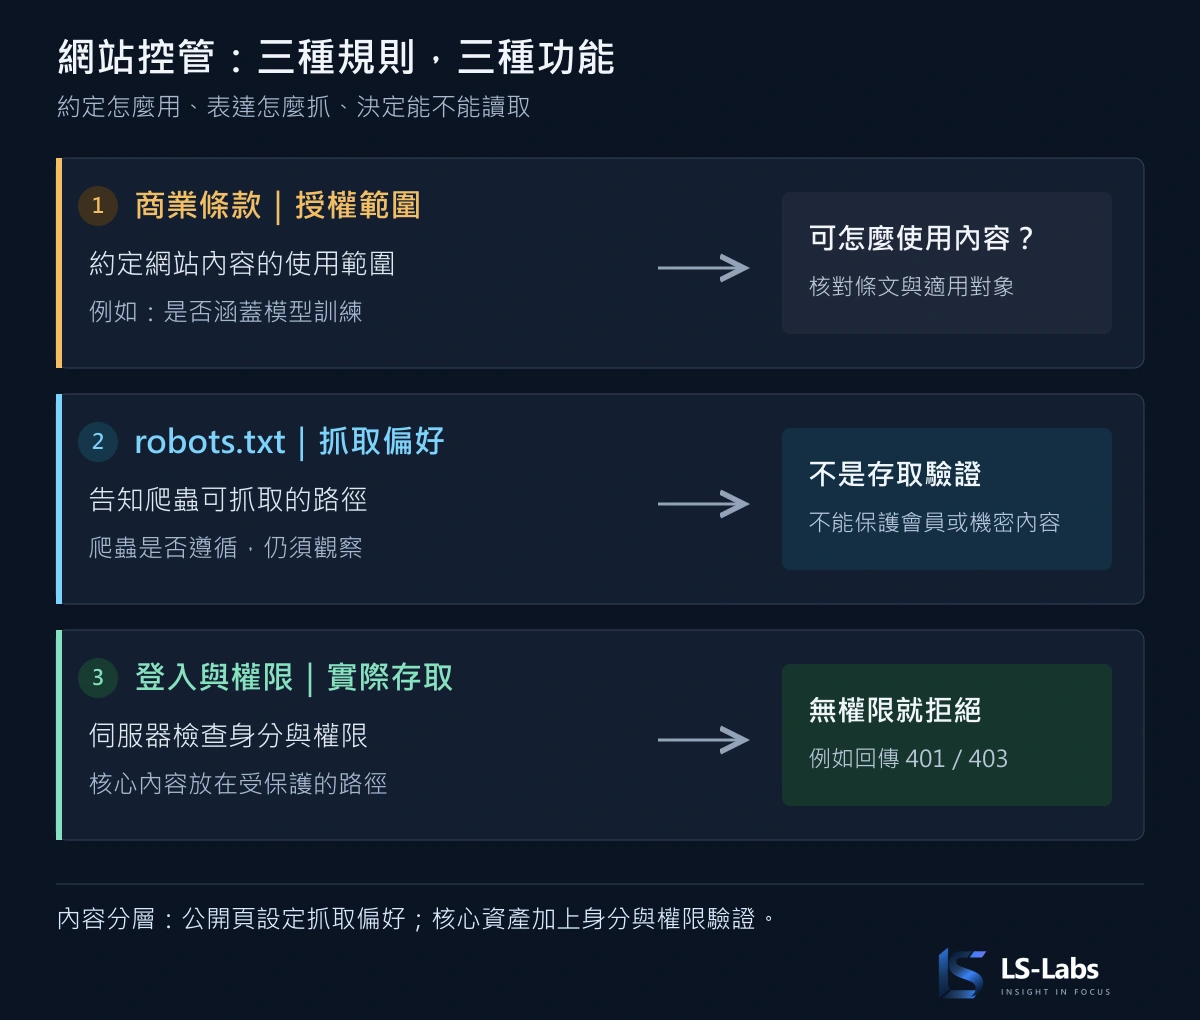
这起争议对网站技术与运营团队的核心冲击,在于“技术规范”与“商业合同”的位阶冲突。LS-Labs 在〈robots.txt 要不要屏蔽 AI?〉中曾分析过,各大 AI 开发商通常将爬虫拆分为训练用与检索用,让网站通过 robots.txt 表达意愿。然而 robots.txt 遵循 RFC 9309 规范,本质上是供爬虫遵循的公开抓取规范,不是访问授权或安全控制机制;商业条款则是企业与平台签署的双边合同。
尽管 Andy Stone 强调网站仍可配置 robots.txt,但新版商业条款全文只字未提 robots.txt,既未将其列为排除条件,也未约定技术指令具备优先效力。受访法律学者提醒,若未来引发数据爬取争议,Meta 的法务团队完全可以主张:企业已在商业条款中授权抓取,网站单方面的 robots.txt 指令不应推翻该授权。这是受访专家指出的法律风险,并非已有法院确认的效力排序。
威斯康星大学法学教授 Benjamin Sobel 从反垄断法的“搭售(tying)”框架剖析了这项条款。当大型社交平台与广告后台已成为企业运营不可或缺的数字基础设施,Meta 将“商业工具使用权”与“全站 AI 训练爬取权”绑定,实质上消除了企业的协商空间。这与 Google 过去将传统搜索索引与 Google AI Overviews(AIO)绑定的逻辑相似;不同之处在于,Google 随后开放了独立退出选项,Meta 的新条款则维持“全盘接受否则停用”的单向条件。
品牌与内容网站的实务检查
面对即将生效的条款,不同商业模式的网站面临截然不同的利害关系。对于以实体商品销售为主的电商与 D2C 品牌而言,让 Meta 爬虫实时抓取产品规格、售价与库存,确实有助于动态广告与 AI 导购的投放效果。但对于依赖原创内容、行业调查、深度研究报告或付费会员机制的出版商与专业品牌,全站内容被无偿纳入大模型训练语料,将直接冲击资产价值。
在无法全面退出 Meta 商业生态系统的前提下,网站团队应从三个具体层面建立防护措施:
1. 服务器端硬性访问控制:不把安全寄托于 robots.txt
条款明确提及建立测试凭证与访问关联域名。对于内部未公开测试环境、会员付费专区或机密数据库,绝不能仅依靠 robots.txt 的 Disallow 规则。爬虫只要知晓路径即可直接发出请求。必须在服务器端与网络层(例如 CDN 服务的防火墙)强制部署身份验证机制(例如 OAuth 2.0、JWT 验证或 Cloudflare Zero Trust),确保未授权访问一律返回 401 或 403 状态码。
2. 盘点日志并分流爬虫:区分广告审核与模型训练
Meta 官方爬虫文档列出不同职责的 User-Agent(请求中用来识别软件的名称)。网站应主动监控服务器访问日志(Access Logs),针对爬虫行为进行分流管控:
meta-externalads:用于改善广告及其他商业相关产品和服务。封锁前应确认对广告与着陆页(Landing Page)的影响。meta-externalagent:用于大语言模型训练与通用数据收集的爬虫。meta-webindexer:用于 Meta AI 实时搜索索引的检索爬虫。facebookexternalhit:抓取分享链接的内容、标题与图片以生成预览;执行安全或诚信检查时可能跳过 robots.txt。meta-externalfetcher:应用户要求抓取个别链接,并支持代理 AI 功能;官方说明其可能跳过 robots.txt 规则。
即使合同效力存在争议,在 robots.txt 中针对 meta-externalagent 明确配置禁止规则,仍能明确表达拒绝偏好;搭配保存设置版本与访问日志,才有助于后续核对爬虫是否遵循。
3. 内容资产分层架构:区分公开引流与核心资产
当平台方借助服务条款将数据授权扩展至全网公开网页,文字资产的防御必须回归架构设计:
- 公开引流层:品牌快讯、官方规格、新闻通讯与通用问答,维持开放以争取在 AI 搜索与智能体推荐中的可见性。
- 核心资产层:高密度研究白皮书、独家统计数据集、付费专题或专利技术文献,改用会员登录、服务器端权限验证或受保护的 API 提供,避免在未获授权与分成的情况下遭到批量爬取。
使用平台,不该连站外内容都得让渡
Meta 已坐拥逾 30 亿人的使用规模。按其 2026 年第 2 季度财报,旗下产品 6 月的平均日活跃用户数达 36 亿,而 Facebook 与 Instagram 的公开帖子也早已是训练 AI 模型的数据来源。Meta 虽然同时强调亲友间的私人消息不在训练范围内,除非有人主动将消息分享给 AI,但这条界线针对的是个人对话,并没有排除站外企业网站的内容授权。
在我看来,这次更新延续了 Meta 一贯把外部数据视为自身商业资产的思维。它凭借庞大的平台规模,已经坐享海量公开帖子带来的训练资源,如今又通过商业条款,把数据获取范围延伸到企业自己的网站。企业花预算投放广告、投入人力运营社交媒体,原本是付费向平台购买流量与曝光,现在连从未上传到 Meta 的官网内容也得一并纳入授权,这样的交换并不公平。
Meta 若认为这些站外内容对训练 AI 与改善推荐系统有价值,就应提供独立的授权机制与拒绝选项,让内容提供者有议价空间,而不是把爬虫与训练授权绑进商业工具的使用权里。把企业对平台的依赖当成获取更多数据的筹码,是我无法认同的商业做法。
这份在 10 月 30 日生效的条款,也改写了企业与社交平台之间的关系。过去品牌把官网视为自己能完全控制的数字资产,社交媒体与广告只是引流的工具,就算不想让 AI 抓取网站内容,也能通过 robots.txt 向遵循规范的爬虫表达拒绝。现在 Meta 改从商业合同下手,按条款文字,只要企业还需要靠粉丝主页触达受众、靠广告系统导流,就得接受相关的爬取授权。当拒绝授权的代价是放弃整个营销渠道,未来网站运营者要面对的就不再只是怎么写好一行拦截指令,而是在高度依赖少数平台流量的现实下,企业还能为自己的内容资产保留多少主导权,这正是 AI 时代非常值得去思考的问题。