文章目录文章开头0%
引言
如今,AI 已经成为人们写作与研究的日常工具。从搜索资料、整理大纲到修改文章,许多人为了提升效率,都习惯让 AI 参与其中。
但当“用 AI 写作”和“用 AI 找资料”这两件事逐渐成为趋势时,一个值得注意的问题随之浮现:原本未经查证的说法,可能在反复引用与转述的过程中,逐渐变成看似有多个来源支持的事实。
举个例子,假设今天有位研究员发表了一篇文章,宣称“网站加入 FAQ 常见问题区块,就能让 AI 搜索引用率提高 40%”。然而,这个数字并未经过实验验证,只是这位研究员根据少数观察提出的推测。
文章发布后,某天有位博主在撰写 SEO 教程文章时,使用 AI 辅助搜索相关资料,恰好 AI 引用了这篇文章的数据,并放进了回答当中。这位博主得到 AI 的回答后,没有进一步查证,便将“FAQ 能提高 40% 的 AI 引用率”写进自己的 SEO 教程文章。
随着其他网站陆续引用、改写,原本只有一篇文章提及的数字,开始出现在不同的网站上。
当未来有用户询问相同问题时,AI 可能找到五篇、十篇都提到“40%”的文章,最终给出一个其实没有任何实证依据的数据。这些内容看似来自不同来源,却可能都源自那位研究员最初的推测。
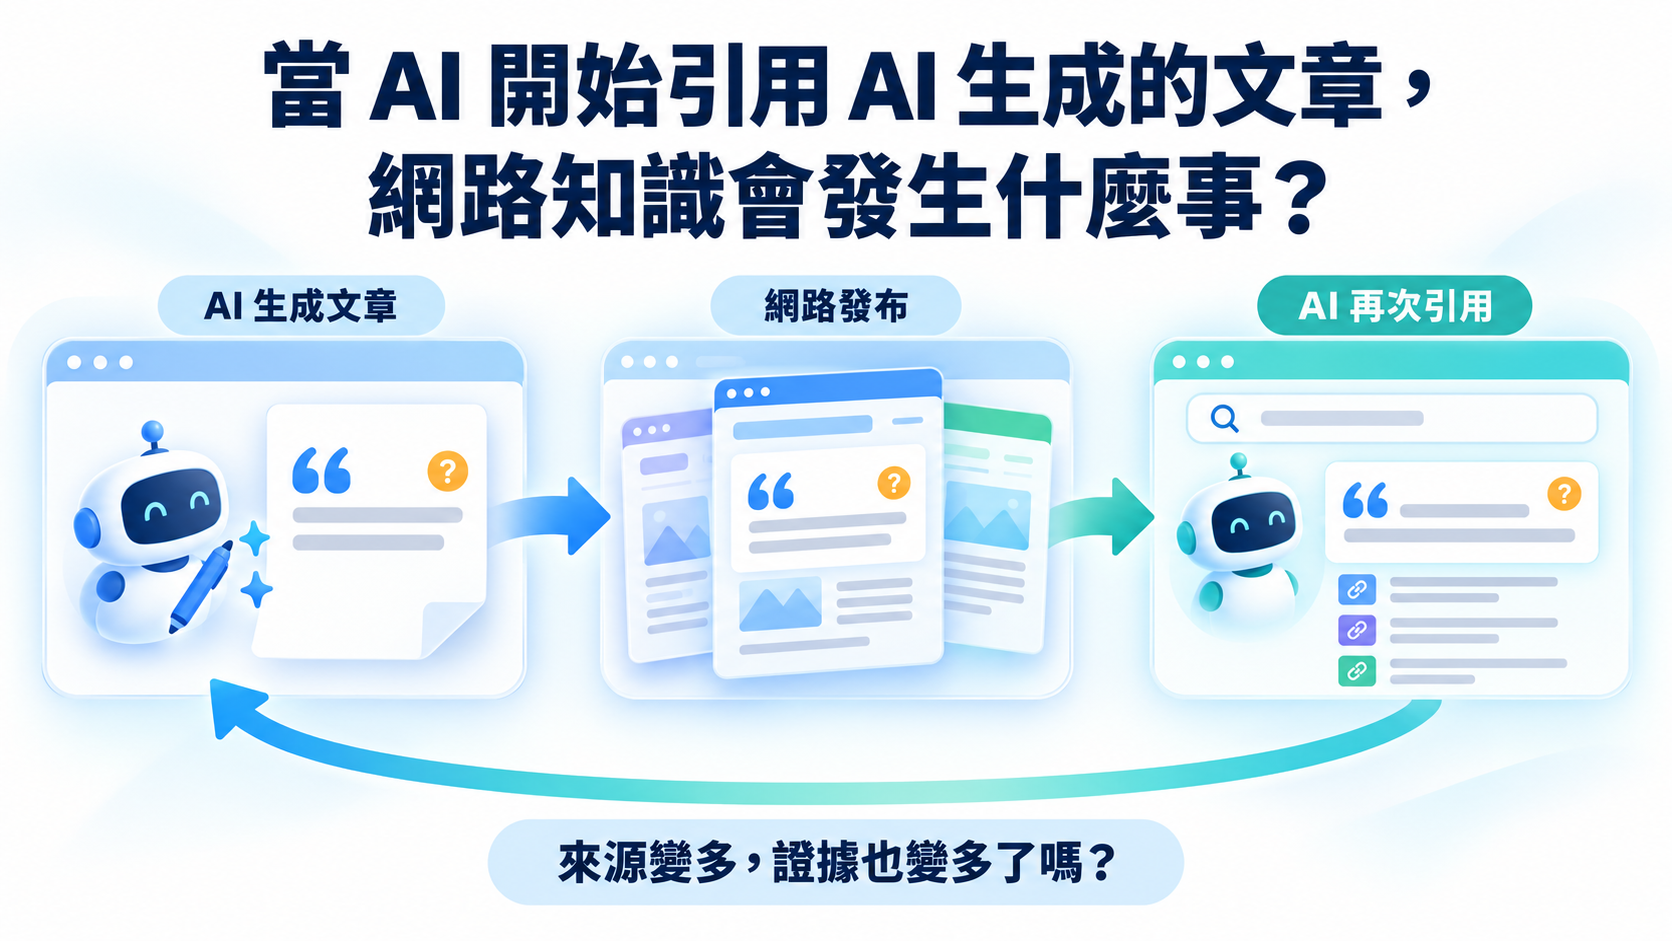
更值得注意的是,当 AI 再次引用这些新文章,而其他创作者又根据 AI 的回答产出更多内容时,相同的信息便可能不断回到搜索结果中,形成反复引用与再生产的循环。
上述这个例子并非完全虚构。过去网上其实真的流传着“做好 FAQ 可以让 AI 可见度提升 40%”的说法。LS-Labs 实际追溯了一下源头,发现最开始是普林斯顿大学等机构研究团队提出的一篇 GEO 概念论文(Aggarwal et al., 2024),其中确实提到做好 GEO,可以让 AI 可见度提升 40%。
但这个 40%,是研究团队在自建的 10,000 题测试集上,加入引文、统计数据、引用来源等改写手法后,可见度的最大提升幅度;在实际上线的 Perplexity 上,最高约为 37%。
而且这项研究测试的手法中,实际上也没有去添加 FAQ 区块。另一方面,Ahrefs 在 2026 年 5 月跟踪了 1,885 个新增结构化数据(JSON-LD)的网页,并与 4,000 个对照页面比较,发现 AI 引用并没有明显提升(Linehan & Guan, 2026)。不过,这些页面在加入结构化数据前就已经被 AI 大量引用,因此这项研究无法回答“结构化数据对尚未被引用的页面是否有帮助”。
换句话说,“40%”这个数字正是本文描述的那种扩散方式,一个在有限条件下的实验,被视作一种常态的营销手法,逐渐成为一种被默认的事实。
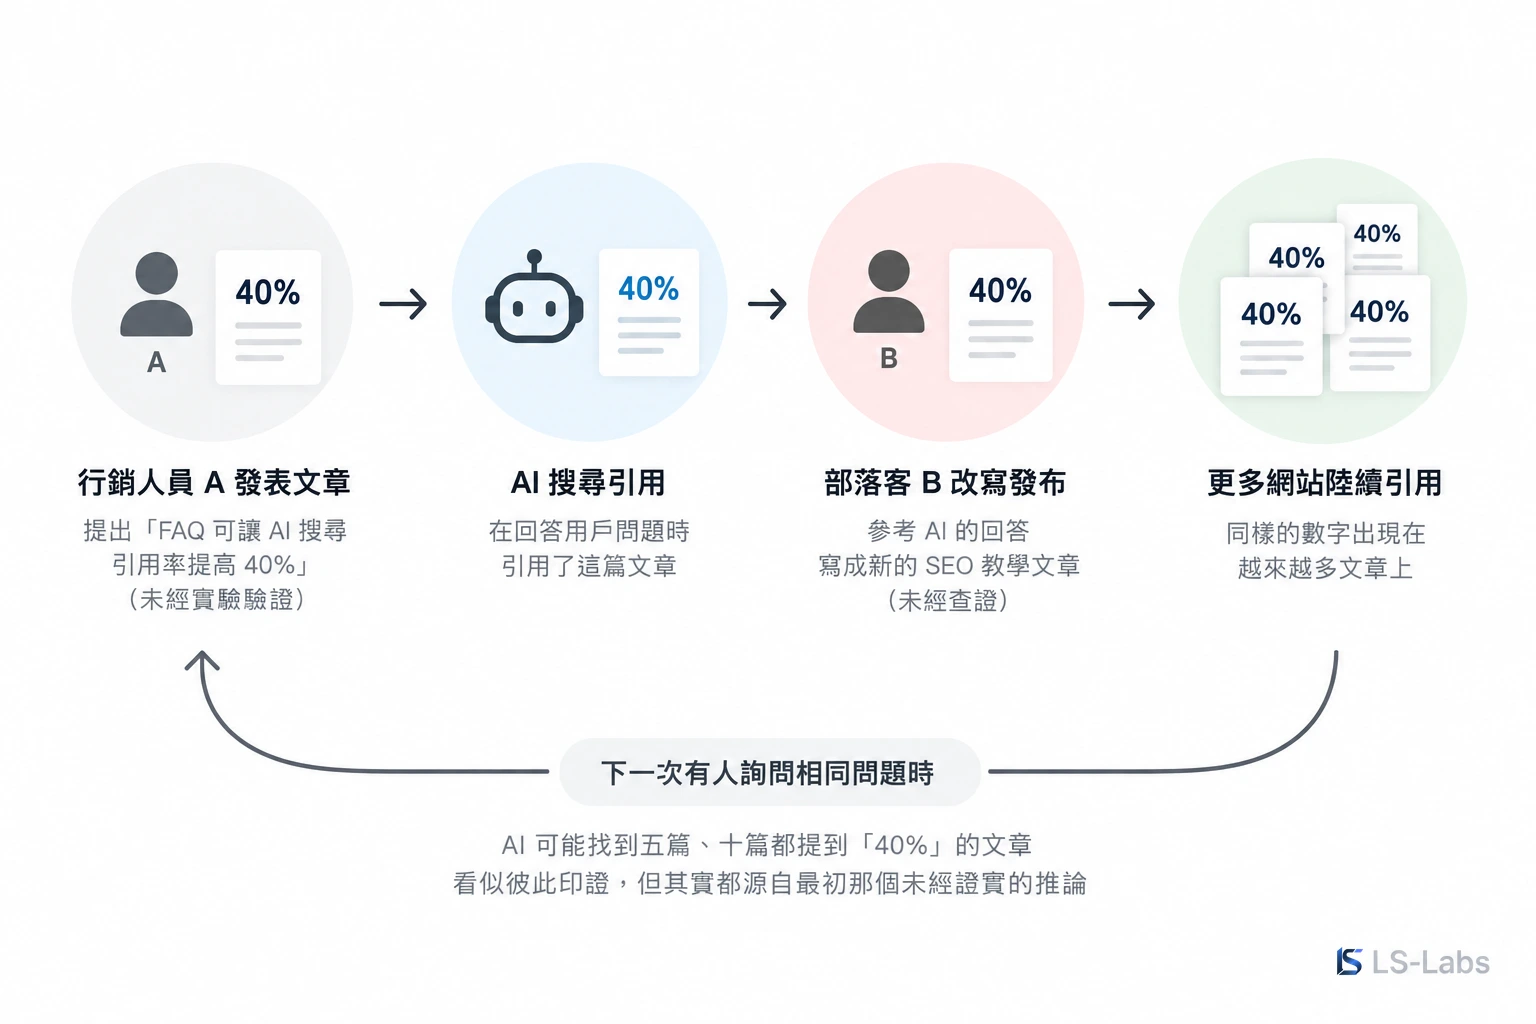
这种自我强化的循环一旦成形,缺乏证据的说法就会因为频繁曝光,而被当成一种事实。但无论被转述多少次,最初那个数字依然没有经过验证。这些看似彼此印证的文章,本质上只是在重复同一个人的猜测。
而这个循环的第一步,也就是 AI 搜索是否真的会引用 AI 生成的内容,正是本篇导读的论文想要研究的问题。
研究发现:每六个引用来源,就有一个可能出自 AI
上述这个循环最大的问题就在于,当网上越来越多内容由 AI 写成,AI 搜索引用的来源,难道还能保证出自人手、经过查证吗?
2026 年 5 月,西北大学(Northwestern University)的 Mowafak Allaham 与 Nicholas Diakopoulos 发表了一篇预印本〈Synthetic Sources?: Auditing Generative Search Engine Citations for Evidence of AI-Generated Sources〉,本文意译为〈AI 搜索引用的来源里,有多少本身就是 AI 生成的?〉(Allaham & Diakopoulos, 2026)。
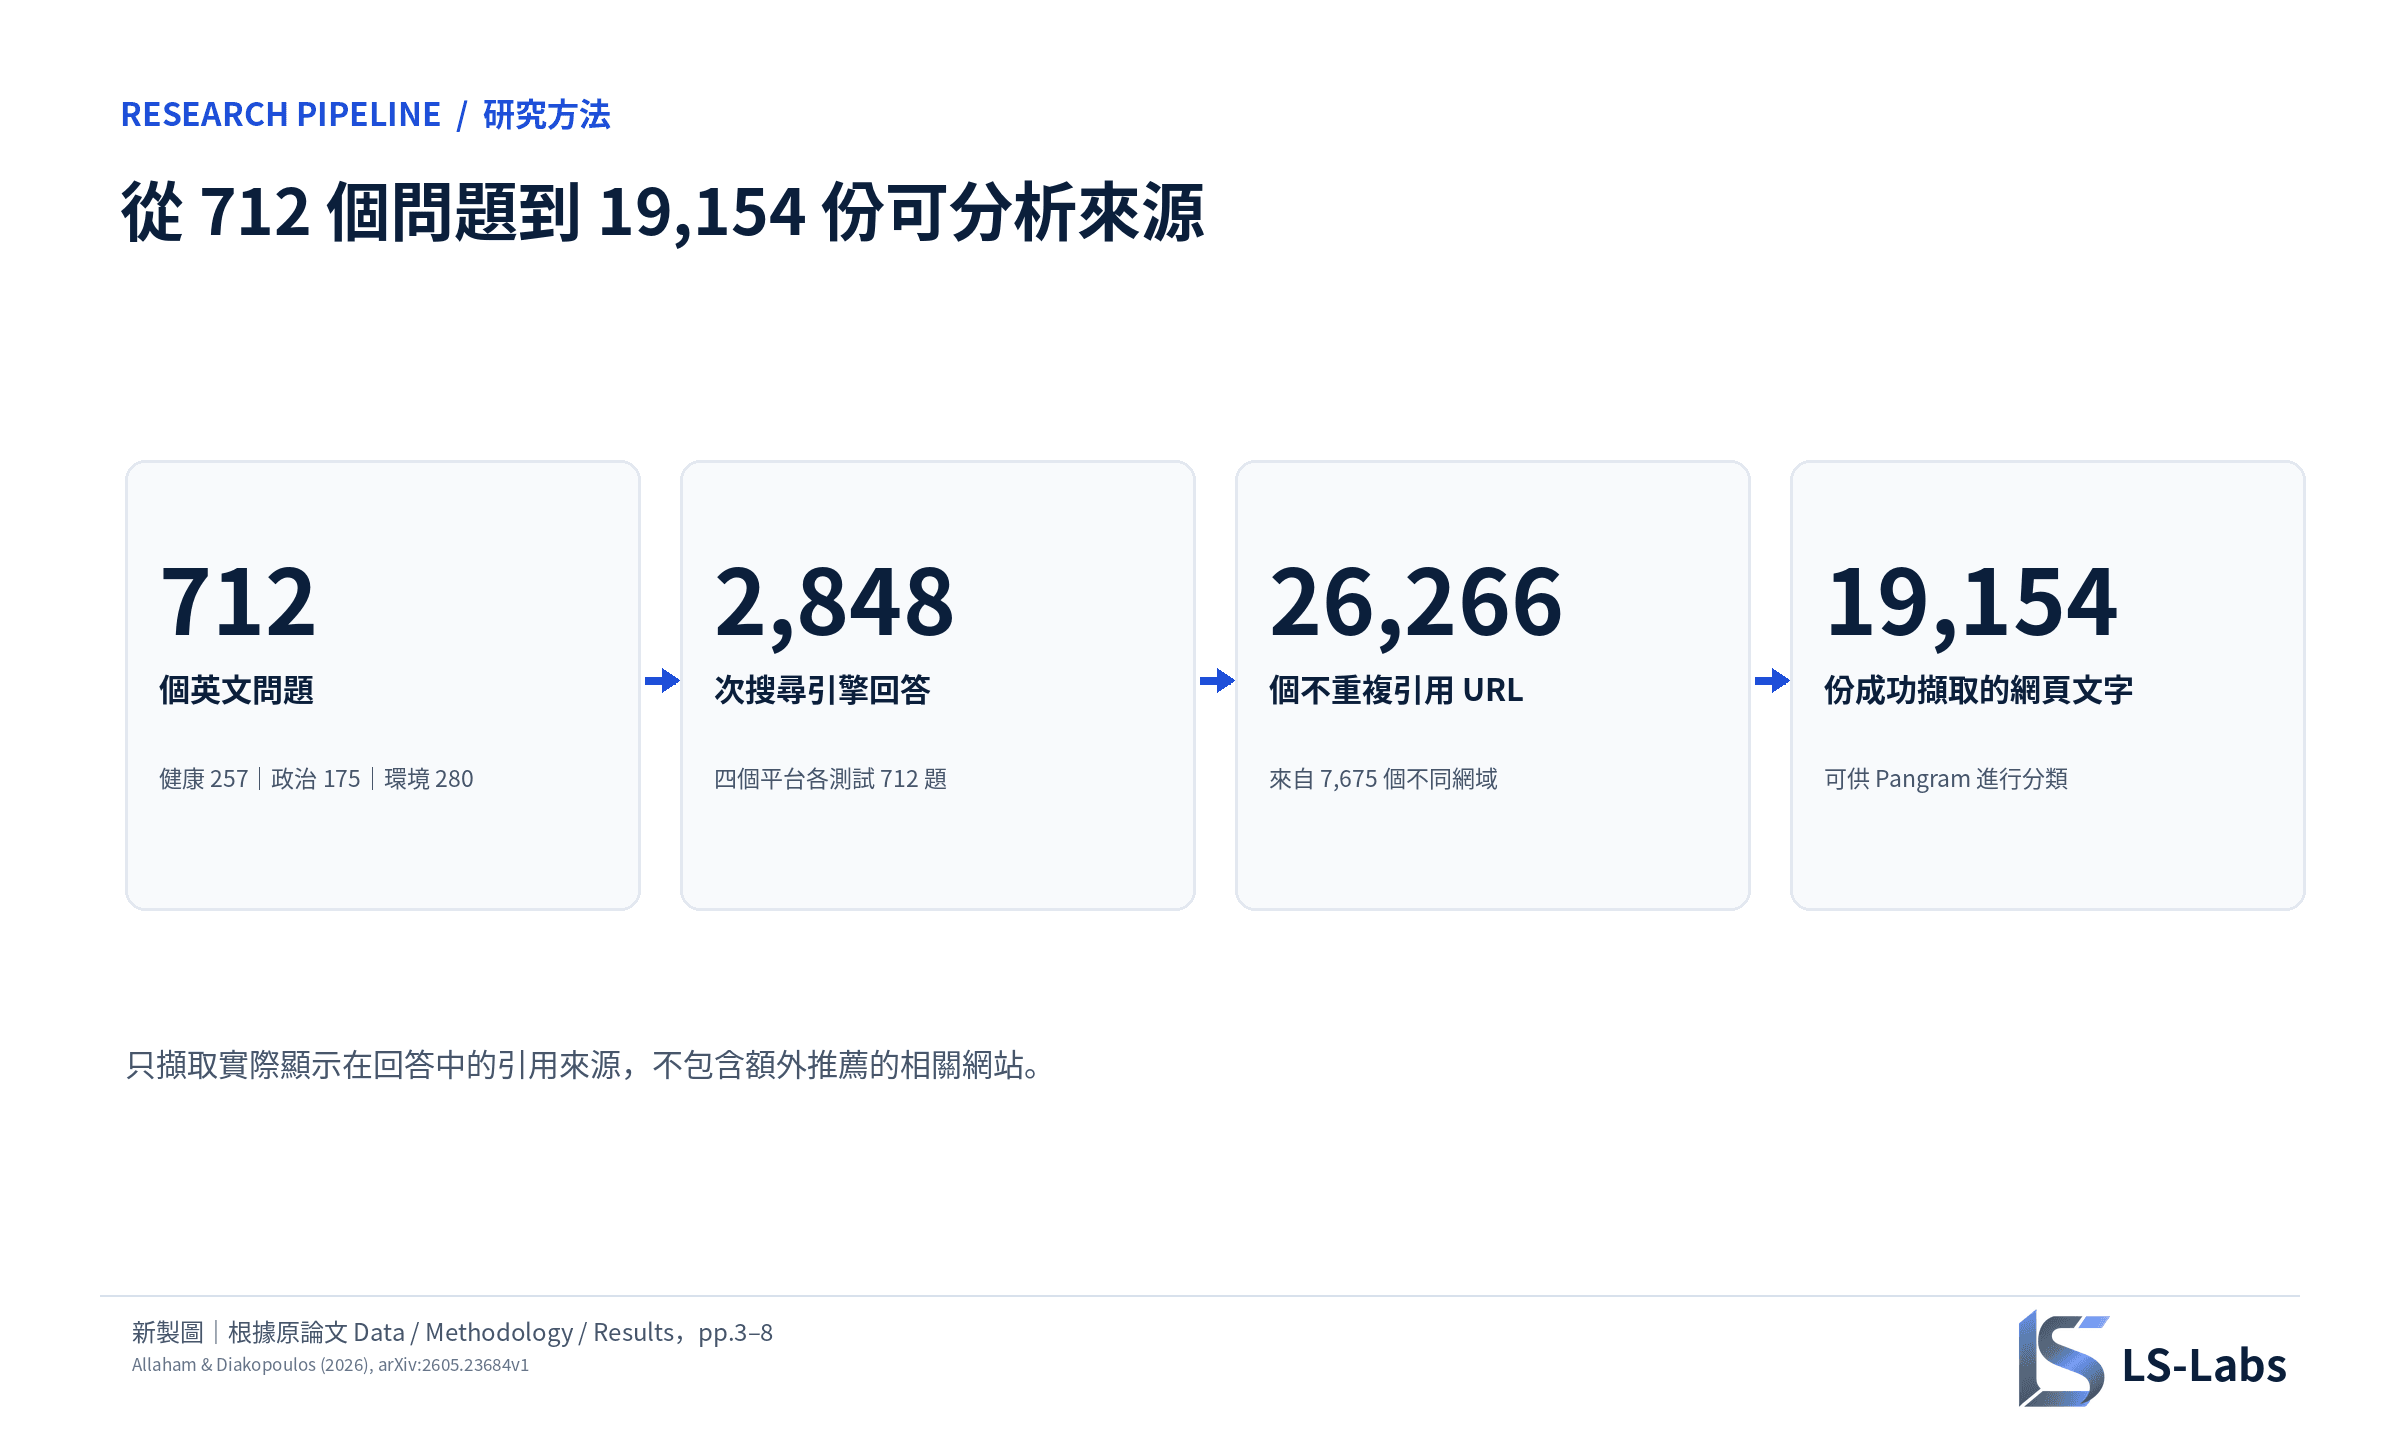
研究团队从两个公开数据集(Search Arena 与 Climate Q&A)的真实用户提问中,挑出 712 个与美国相关、涵盖政治、健康与环境议题的英文问题,并用程序模拟真人操作,逐一输入 ChatGPT、Copilot、Gemini 与 Perplexity 的网页界面。他们共收集到 26,266 个被引用的网址,其中 19,154 个页面成功抓取文字,再交由 AI 文本检测工具 Pangram 判读。
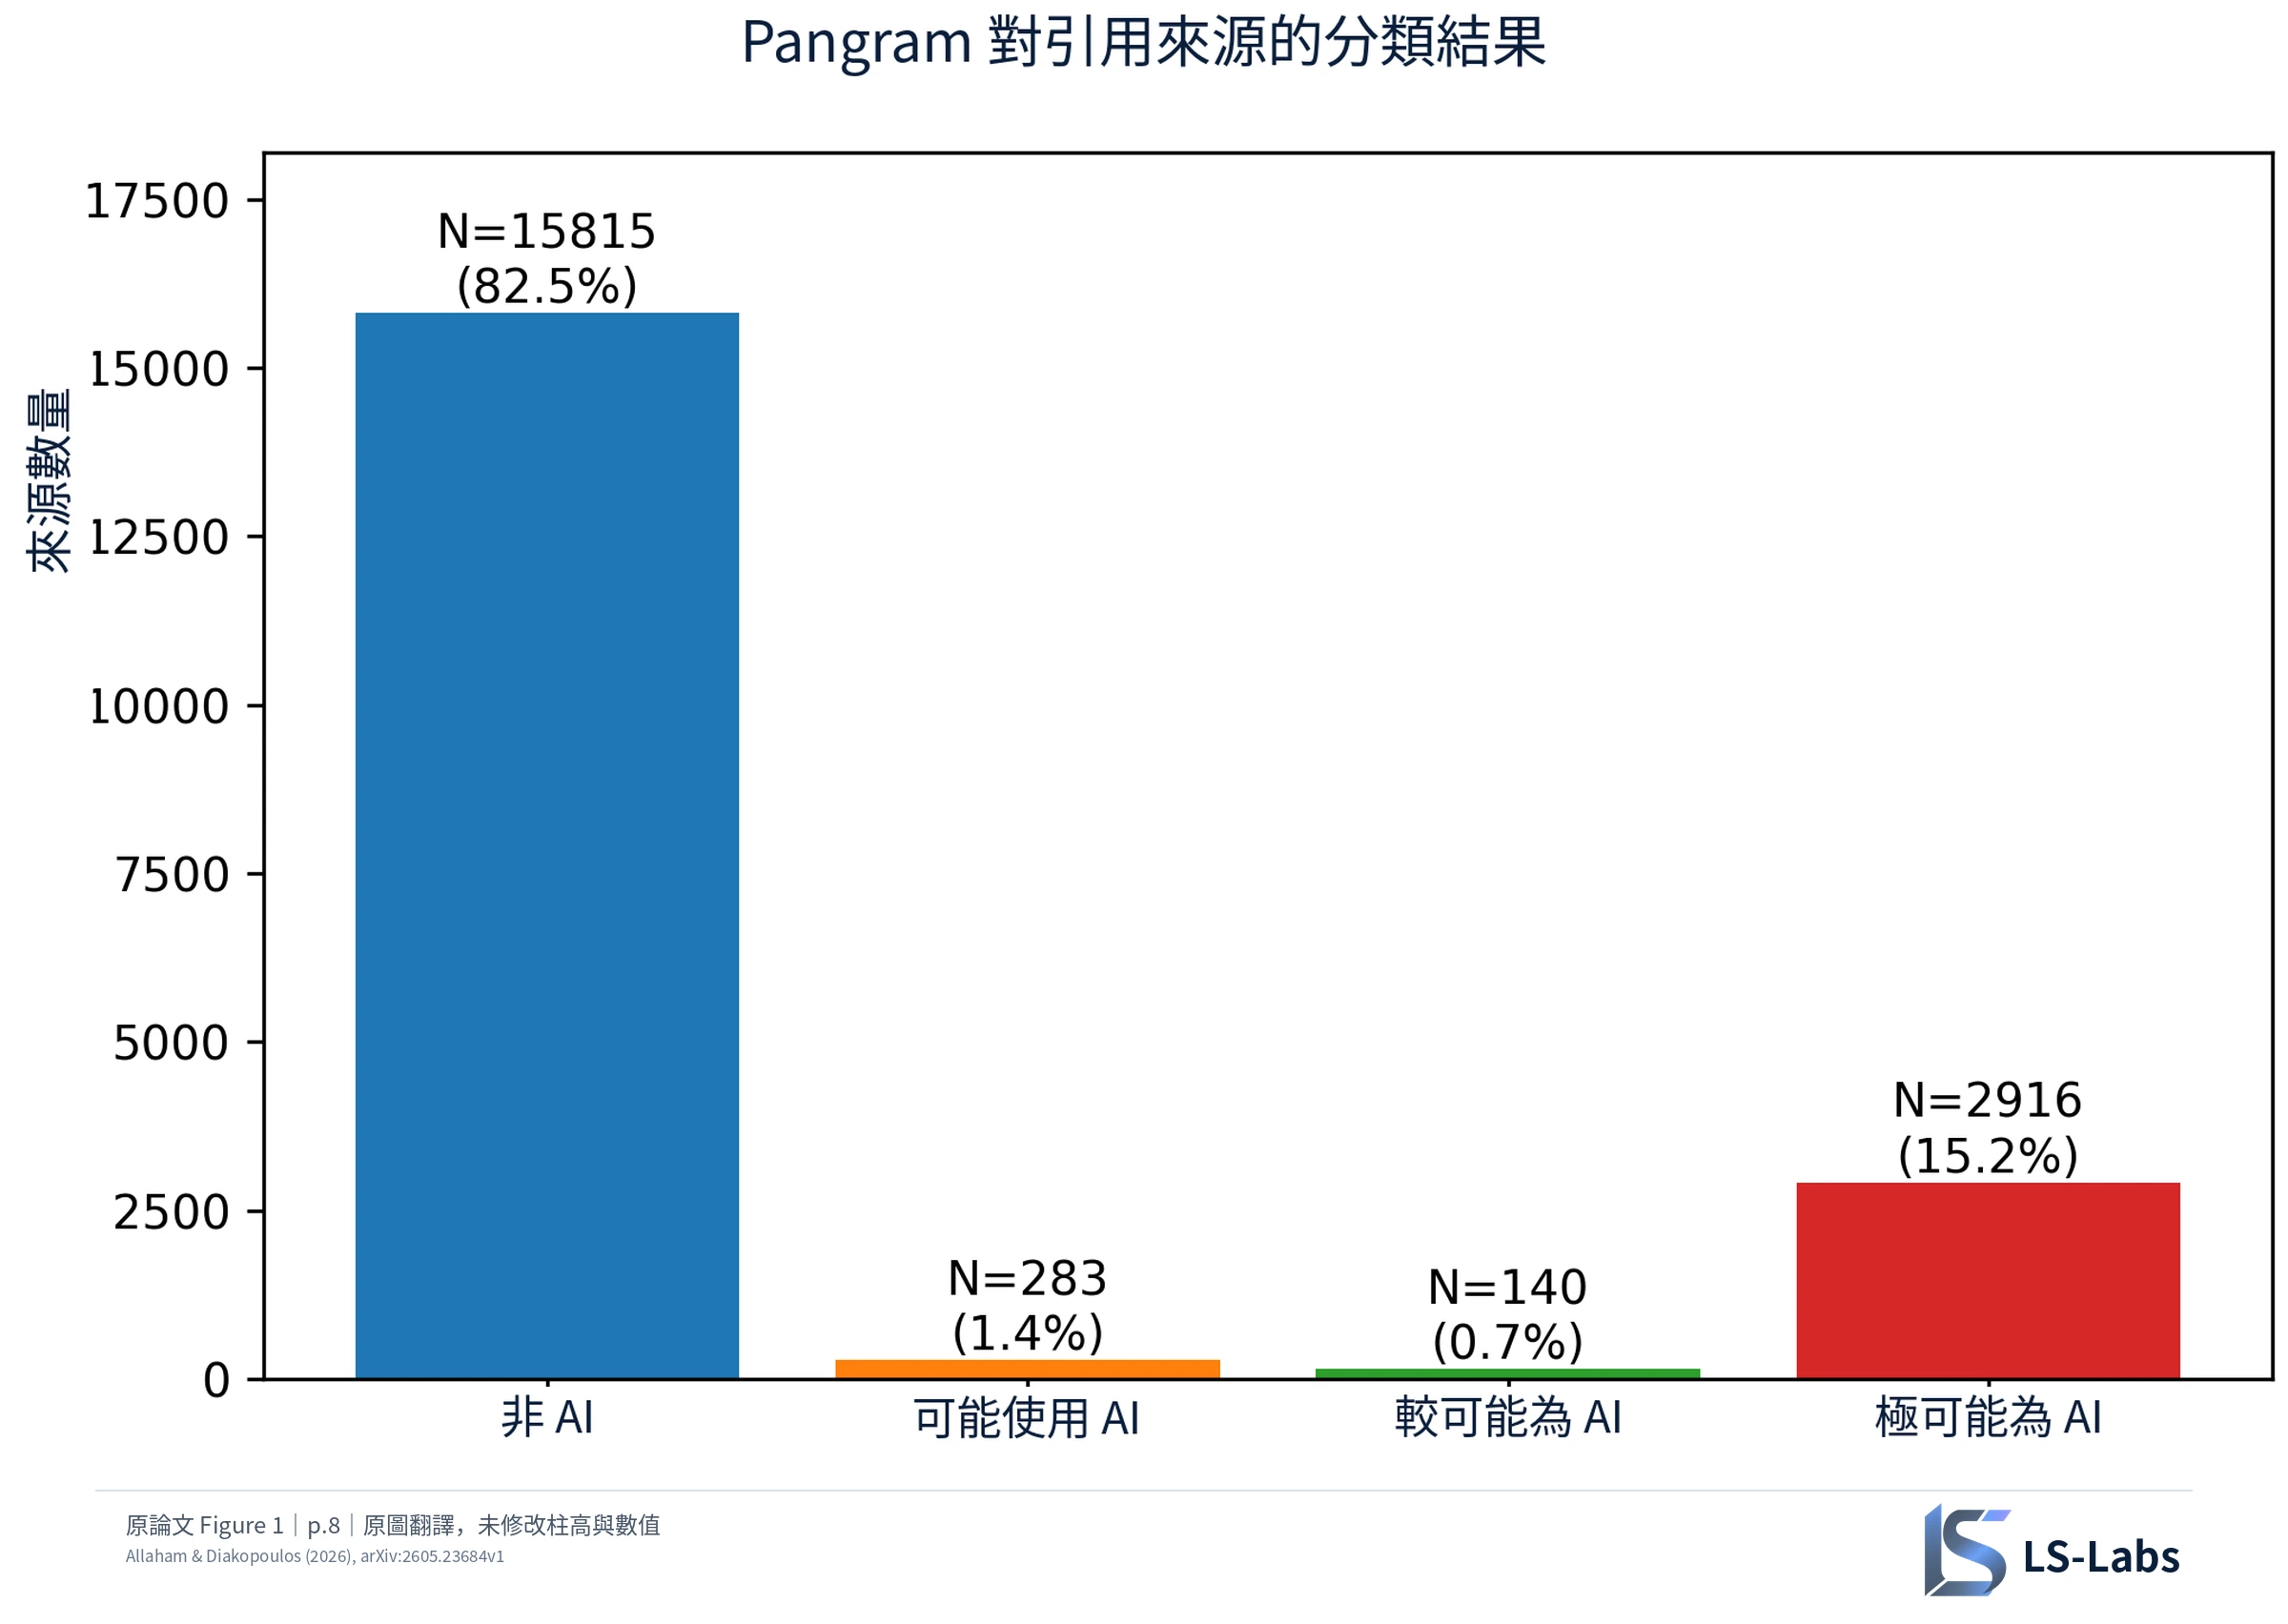
结果显示,在成功抓取文字的页面中,约 16% 被判定为 AI 生成,相当于平均每六个来源,就有一个可能出自 AI 之手。作者把这个数字视为保守的下限:一方面,他们选用的检测工具宁可漏判、也不误判;另一方面,被判定为“可能是 AI”的模糊案例也没有计入。
进一步拆解数据后,有三个现象值得注意:
知名平台与官方网站,都出现了 AI 生成内容:研究显示,被 AI 搜索引用的页面中,Reddit 约有 12% 的内容被判为 AI 生成,美国国家医学图书馆的论文库约 4%,NASA 主导的 earth.gov 则约 14%,印度主流媒体 Times of India 更是出现了接近一半的可怕比例。换句话说,“来自大站或官方网站”已经不能保证内容出自人手。作者也坦言,这些出现在官方网站上的 AI 内容质量是高是低,目前无法判断。
不同 AI 生成内容时,对来源的偏好也不同: 四个 AI 搜索面对同样的问题、同一个网络,引用的 AI 生成比例却相差数倍。ChatGPT 平均每条回答引用约 15 个来源,是四家中最多,AI 生成比例却最低,约 7%;Copilot 平均只引用约 8 个,比例却接近三成,而且它在三个主题里最常引用的 AI 生成网站,几乎整站内容都被判为 AI 生成。这代表引用池的质量并非无法控制,而是各平台挑选来源的标准不同。问题在于,这套标准对用户完全不透明:用户不知道自己用的工具筛掉了什么,又放进了什么。
最需要准确性的领域,回答中的引用率却最低:最令人担心的,莫过于这份研究中显示,在这些样本数据中,约有 8.8% 的回答完全没有附上任何引用。其中健康类问题的比例最高,约每九条就有一条,高于环境类问题(约 8%)与政治类问题(约 6%)。作者推测,这代表 AI 搜索在部分问题上并没有上网查资料,而是直接用模型训练时学到的知识作答,信息因此可能过时,也更容易出现幻觉。
从这份预印本当中,可以明确地看到 AI 生成的内容确实进入了 AI 搜索的引用池。
同时,这个池子被稀释的速度还在加快。
皮尤研究中心(Pew Research Center)在 2026 年 8 月分析了 Common Crawl 约 49 万个英文网页,发现 .com 域名中带有明显 AI 撰写或实质性编辑痕迹的比例,从 2024 年初的 3.8%、2025 年初的 5.5%,一路升到 2026 年初的 9.4%(Bestvater et al., 2026)。两年间增长约 2.5 倍,而且近一年的增幅(约 71%)明显高于前一年(约 46%)。
AI 搜索是黑箱:LLM 幻觉的系统性风险
要理解 AI 搜索的引用池混入 AI 内容,为什么是一种系统性风险,得先理解 AI 搜索的运作逻辑。
当用户向 ChatGPT 或 Perplexity 提问时,系统会先到网上抓取它认为相关的网页内容,再交由语言模型重组成一段通顺的回答。
问题在于,这整个搜索与文字重组的过程,用户完全看不见。它搜索了哪些页面、为什么留下 A 而舍弃 B、回答里的哪一句对应哪一个来源,用户几乎无从得知。
这种不透明的状态,姑且称为“黑箱”。
这与语言模型的底层机制有关。语言模型的运作,是根据上下文预测下一个最可能出现的词。例如“读”的后面,高概率会接“书”,因此它呈现的回答就会是“读书”。
因此,模型读过海量文本后,确实能掌握语法与概念之间的关联,甚至展现某种推理结构,但这套训练逻辑并不能保证输出符合客观事实,也不能保证它“知道自己不知道”这件事。
基于这个原理,可以得出模型的表达能力与事实可靠度,是两回事的结论。
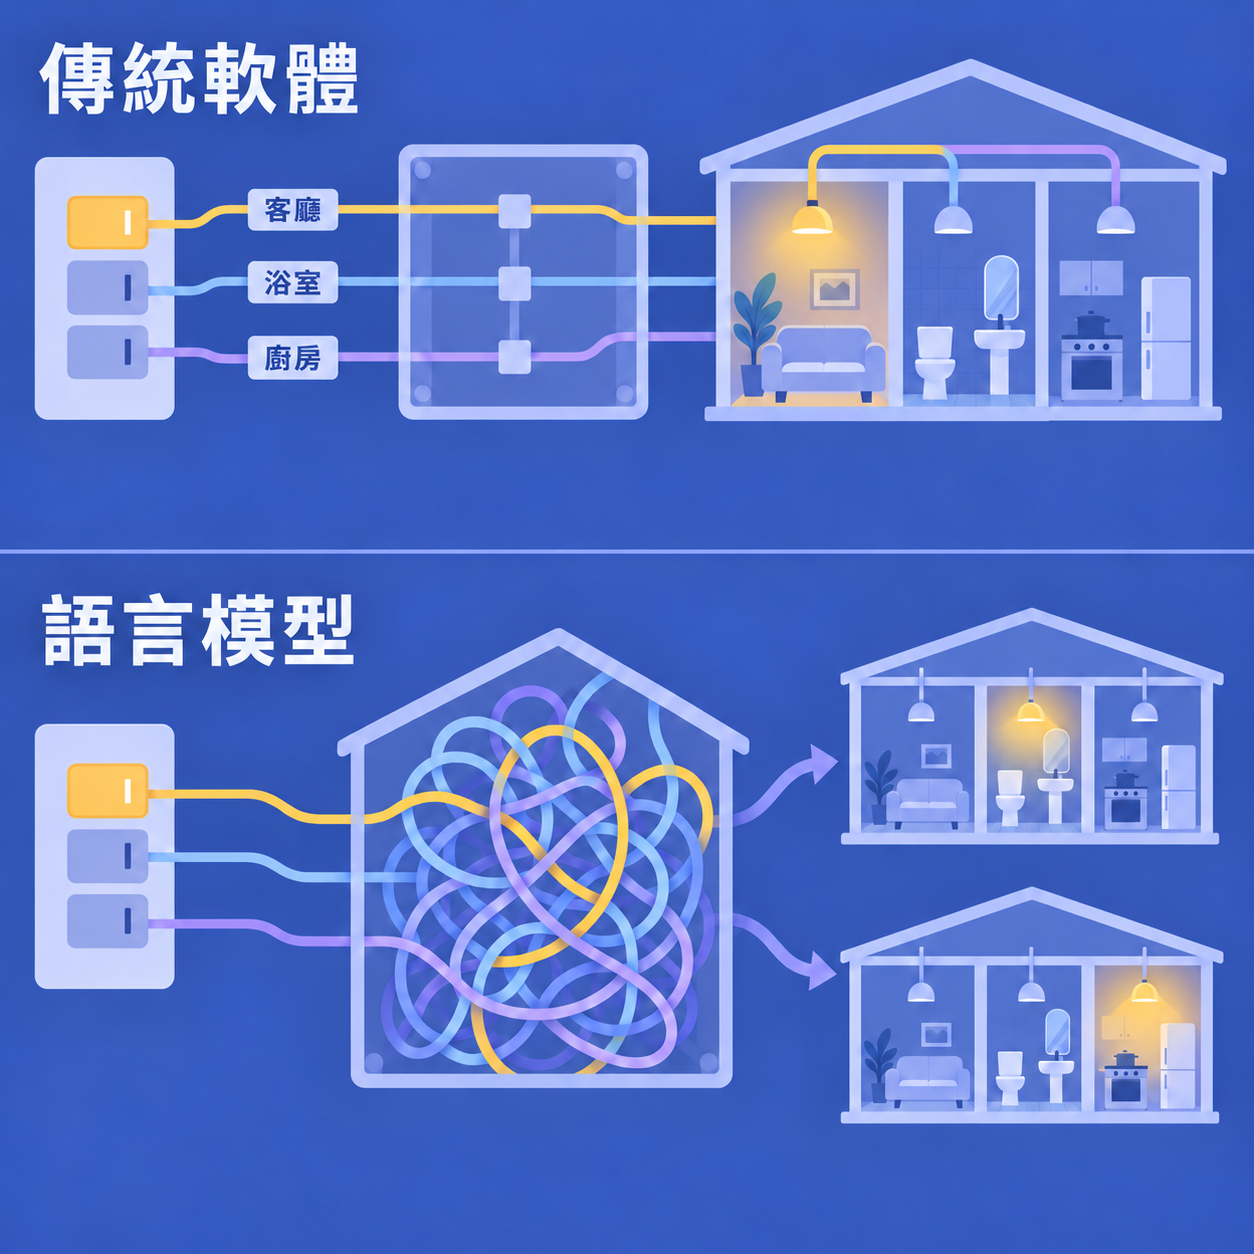
更麻烦的是,即使知道答案错了,也很难找出错在哪里。传统软件就像一个每条电线都贴好标签的配电箱,哪盏灯不亮,顺着标签就能找到是哪条线出了问题;语言模型则像一间电线全部缠在一起的房子,而且同一个开关,每次按下去亮的灯还不一定相同。
你今天按下客厅的开关,亮的可能是卫生间的灯;隔天按下同一个开关,亮的却变成了厨房的灯。你看得到哪盏灯亮了,却找不到是哪条线接过去的。
这也是为什么,目前没有人能保证 AI 的每一个答案都是对的。模型每一次回答,都是在众多可能的下一个词之间做选择,而不是去查一张写好标准答案的表。即使是 1+1 这么简单的问题,AI 答错的概率再低,也不会真正等于零。
这个概念套用到 GEO 的领域,可以得知一个很残酷的事实:既然连 1+1 都只能说“几乎不会错”,那么“让 AI 一定引用你的品牌”这种承诺,本质上就不可能成立。
能做的,只是通过重复测量,观察品牌在不同提问、不同平台、不同时间下被引用的概率与分布,并尽可能地产出优质内容,提高自己在 AI 眼中的信任度与权重。
话说回来,AI 公司当然也清楚这些问题。所以既然很难从模型内部逐一修正错误,他们除了持续训练模型,也会让模型在需要时借助外部工具,而不是全靠自己“想”出答案。比方说,当你请 AI 算一笔复杂的账,它可能会在背后开一个计算程序来算,而不是凭感觉写出一个数字;当你问今天的汇率或天气,它会去查实时数据,而不是凭记忆回答。
AI 搜索就是这个思路的产物。它就像把闭卷考变成开卷考:与其让模型凭记忆作答,不如让它先上网翻资料,再根据查到的内容回答。
但开卷考想要考得好,得先有两个前提:
- 书里写的答案本身得是对的。
- 考生得有能力从书里找到正确答案。
而这两个前提,当前的 AI 搜索都无法保证。
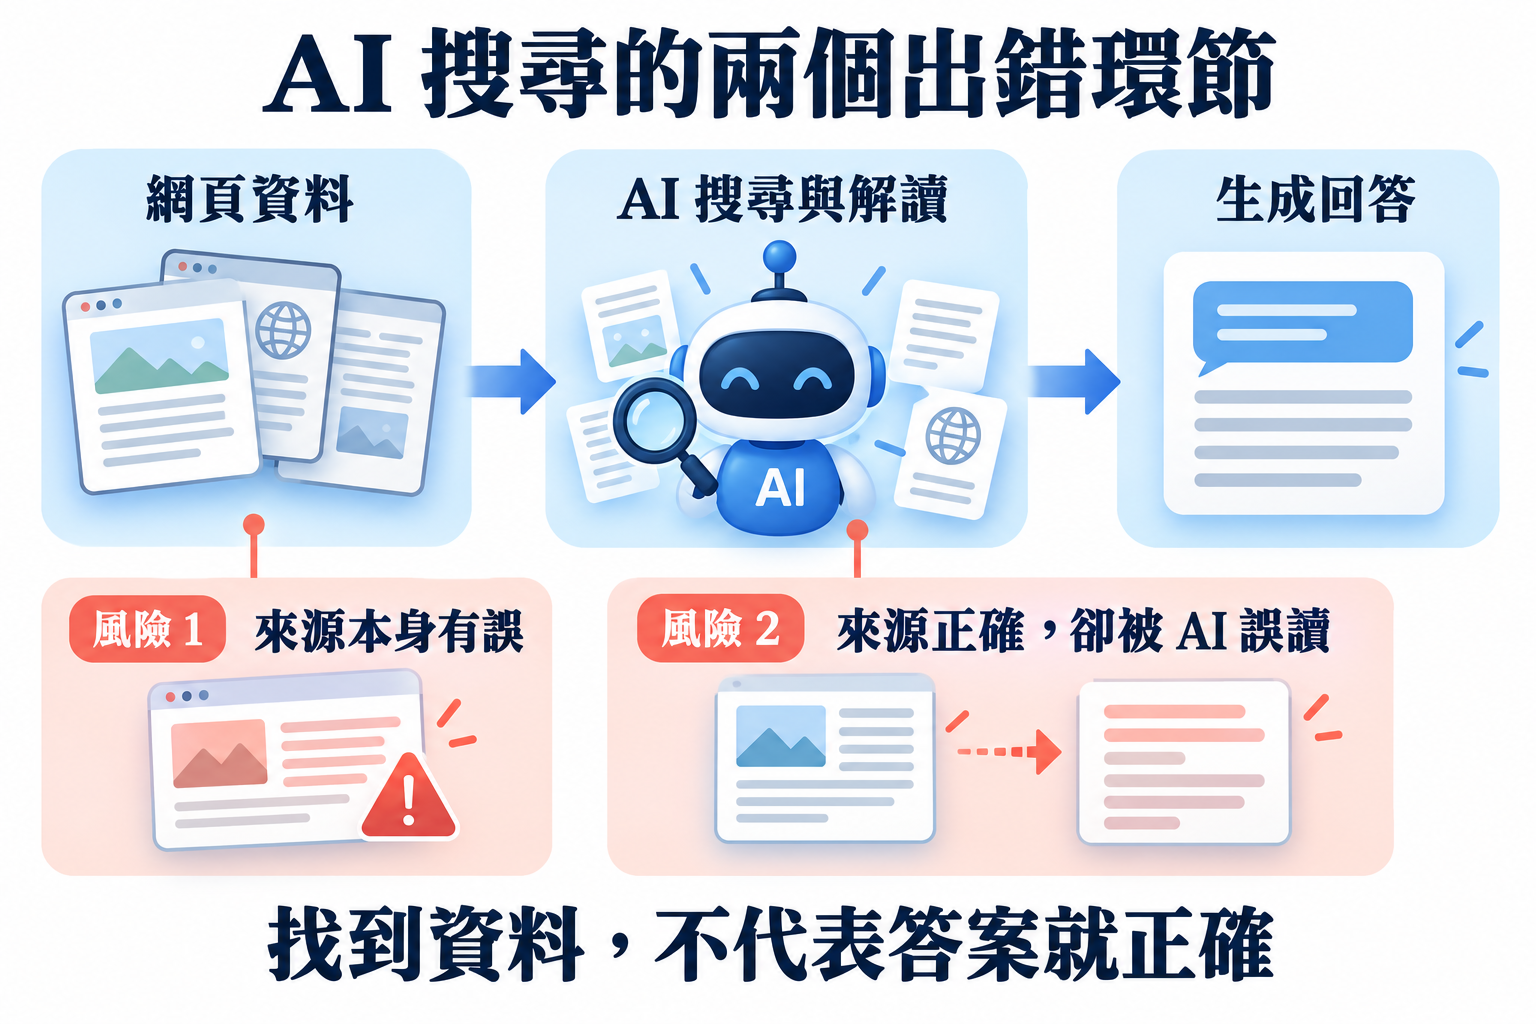
首先,它的可靠程度,取决于抓回来的网页质量。当网上的内容开始混入大量未经查证的 AI 生成文字,原本用来约束模型、减少错误的外部数据,本身就可能成为错误的来源。
其次,即使数据本身正确,搜索与解读的过程也并不稳定。同一个问题问两次,可能抓到不同的页面;就算抓对了,模型仍可能误读或过度延伸,写出看似语气笃定、内容却错误连篇的段落,这也就是基于“黑箱”机制所衍生出的“幻觉”。
更严重的是,无论错误出在数据来源还是文字解读,用户看到的都是一段流畅、自信的回答。
黑箱真正危险的地方,不在于它会出错,而在于它让错误变得极难察觉。
而这种风险,已经出现在日常使用的产品里。英国《卫报》(The Guardian)2026 年 1 月初的调查揭露,Google 的 AI 概览(AI Overviews)提供的错误健康信息,正把用户推向险境(Gregory, 2026a)。例如,系统曾建议胰腺癌患者避免高脂食物,专家指出这与临床建议完全相反,甚至可能增加患者的死亡风险;另一个案例则是在肝功能检查的“正常范围”上,列出未考虑年龄、性别、种族等条件的数字,可能让重症肝病患者误以为自己很健康。
尽管 Google 当时回应,绝大多数摘要正确且有帮助,并指部分案例属于“不完整的截图”。然而,九天后《卫报》的后续报道指出,Google 已撤下“肝功能检测正常范围”等少数查询的 AI 概览,证明了他们也默认了这项风险的存在(Gregory, 2026b)。
幻觉的循环:聊天回声室效应
如果幻觉只停留在单次对话中,影响的顶多是当事人当下的判断。但当人们逐渐习惯请 AI 整理资料、补充数据,并在未经核对的情况下直接发布,这些单次对话里的错误,就可能被放大成整个网络生态的问题。
过去在 AI 尚未出现的年代,人们查找资料多使用传统搜索引擎。那时面对一整页链接,通常会选择点开几个网站交叉比对,用人脑完成初步筛选。然而到了现在,当人们面对一段由 AI 整理好的答案时,绝大多数人却都不会选择去点开那些附在不显眼处的引用来源,更别提在缺乏背景知识的情况下,抓出回答中的错误或漏洞。
这背后牵涉到所谓的回声室效应(Echo Chamber Effect,又称信息茧房效应):人们反复接触与自己立场相近的说法,较少遇到不同观点,原有看法便可能在这个圈子里被不断强化(Cinelli et al., 2021)。而下面要谈的“聊天回声室效应”,则把问题带到了人与 AI 的对话之中。
Jacob、Kerrigan 与 Bastos 在 2025 年的研究中,把这种信任 AI、却不加查证的现象,命名为“聊天回声室效应”(Chat-Chamber Effect,取自 echo chamber 的双关)(Jacob et al., 2025)。他们让受试者分别使用 ChatGPT 3.5 与 Google 搜索,查找印度与爱尔兰的 LGBTQIA+ 民选代表人数,之后再进行半结构式访谈。
结果发现,语言模型可能提供错误、却符合用户既有立场的信息,而用户不仅照单全收、不做交叉查证,还会把这些未经证实的信息内化,形成封闭的反馈循环。
Sharma、Liao 与 Xiao 在 CHI 2024 发表的实验,则从信息多样性的角度,补充了 AI 用户的行为分析(Sharma et al., 2024)。研究发现,比起传统搜索,使用对话式 AI 搜索的受试者,提问方式更偏向自身原有的立场;而当研究者刻意让 AI 附和用户的既有观点时,这种偏向自身立场的信息搜索又被进一步放大。
当 AI 内容泛滥:来源越多,就越可信吗?
在 AI 出现之前,“多方查证”是每个内容创作者最基本的能力,同时也是每个人潜意识里的习惯。例如新闻业要求一条消息至少两个独立消息来源;学术研究要求追溯到一手文献,甚至精确到必须提供引用的句子;而一般人在做决定前通常也会多开几个标签页来做比对与验证。
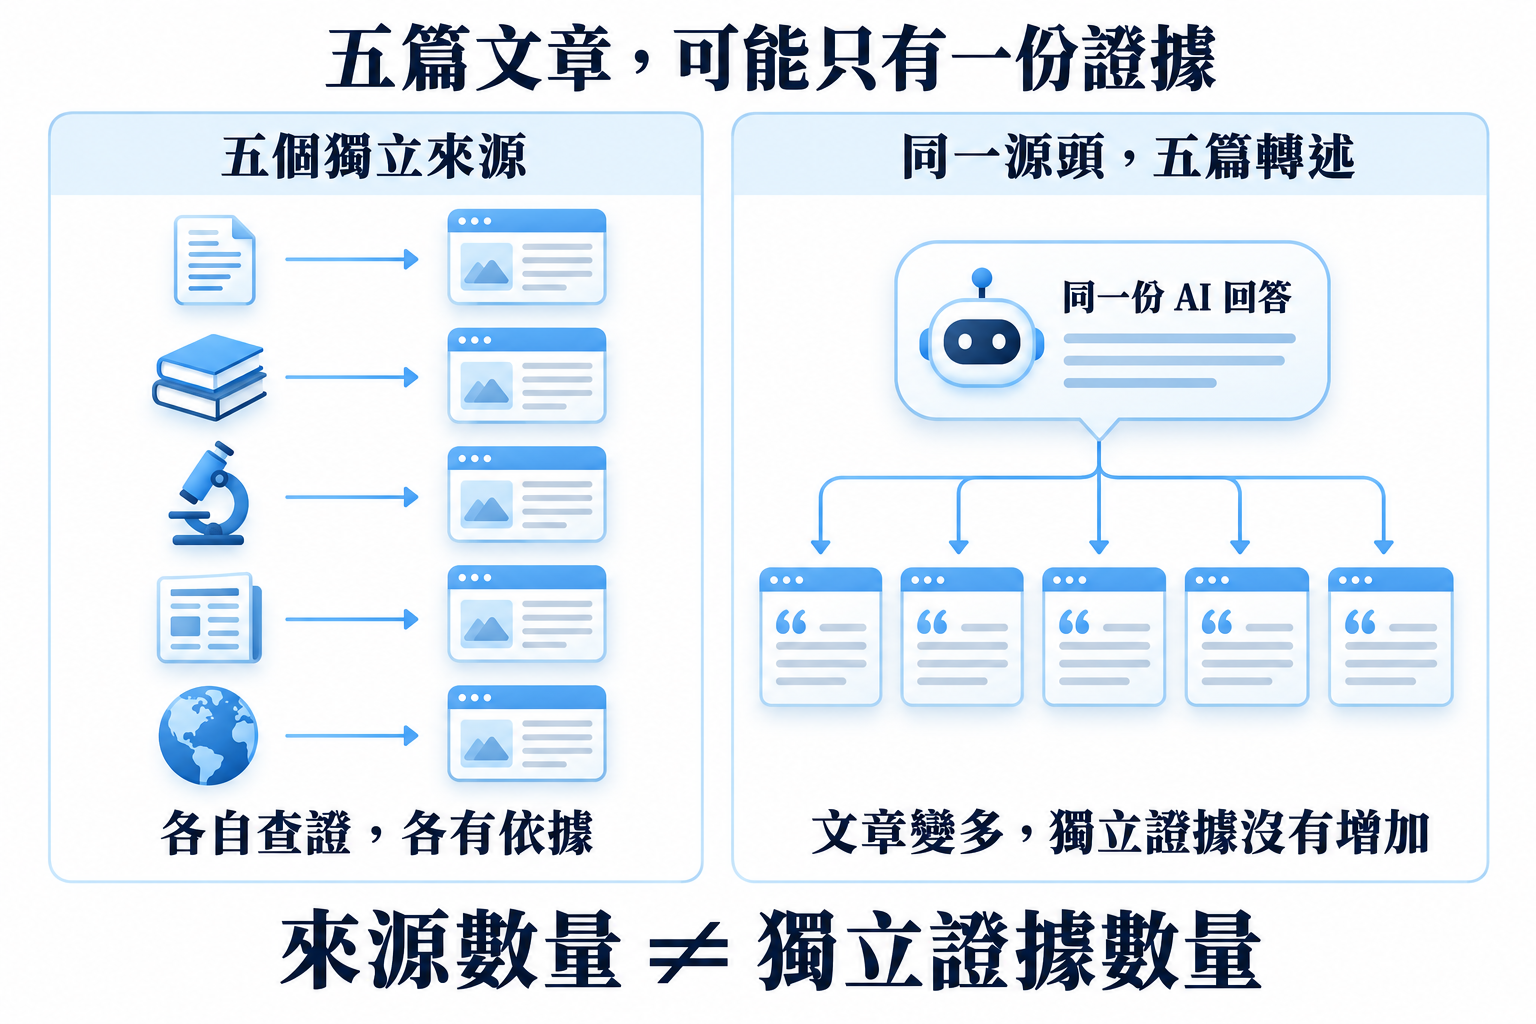
而这个习惯的背后,其实有个鲜为人知的前提,那就是这些来源必须彼此独立。为何五个来源会比一个有说服力?是因为这五个观察者各自接触了原始证据,并得出相同结论,最后将各自的见解上传至网络。
但如果这五篇文章只是互相抄袭、转述同一个源头,那么读者多少能够发现这些来源的证据力并没有增加,因为它们就只是同一套说法的五份副本。新闻与情报分析把这种假象称为“循环报道”(circular reporting)(Tavlin, 2015)。
可到了 AI 时代,这个埋在每个人骨子里的习惯,似乎直接被 AI 给剥夺了。
皮尤研究中心分析 900 名美国成年人的浏览记录后发现,在出现 AI 概览的 Google 搜索页中,用户点击摘要内来源链接的情况,只占约 1% 的访问;就连一般搜索结果的点击率,也从无摘要时的 15% 降到 8%(Chapekis & Lieb, 2025)。
不过有趣的是,尽管人们几乎不再点开链接,去查证 AI 说的真伪,但这不代表“引用”这件事便是无效的,它反而变成一种 AI 给予人类、纯粹的信任指标。
美国圣母大学(University of Notre Dame)与德勤(Deloitte)的研究团队在 2025 年发表的实验中,让 303 位受试者阅读聊天机器人的回答,并随机附上数量与相关性不同的引用(Ding et al., 2025)。
结果发现,只要回答后面挂着引用标记,受试者的信任度就显著上升,哪怕那些链接是随机挑选、与正文毫无关联;在所有附有引用的回答中,只有不到一成曾被受试者点开查看,而那些真正有意识去动手查看引用来源的受试者,对于 AI 回答给出的信任分数反而明显降低。
这揭示了一个悖论式的现象:人们依然把“有来源支持”当作可信度的指标,却已经不再亲自检查这些来源是否独立、是否真实,而是把这份工作全权交给了 AI。
零成本复制时代的知识困境
回头看这份研究延伸出的问题,我认为可以用“供给”与“需求”来理解。
在供给端,内容的生产正在加速。AI 让写文章、做摘要、整理知识变得前所未有地容易。
在需求端,获取答案的速度也在加快。用户通过 AI,几秒钟就能拿到一段整理好的回答。但获取答案变快,不代表理解与判断的能力也以同样的速度增长。
这就衍生出一个较具哲学性的思辨:信息的生产者用 AI 输出,信息的吸收者用 AI 获取答案,这中间却鲜少有人停下来,确认自己建立的知识是否正确。
真正让我在意的是,AI 时代的信息产出效率确实提升了,但这份效率,是否真正转化成了人类知识与能力的增长?
这个困惑,与数学界最近闹得沸沸扬扬的事件不谋而合。
2026 年 9 月,OpenAI 宣布其模型解出了一道与 Navier-Stokes 方程有关的难题,但看过论文的数学家认为,这份证明几乎无法阅读,人类从中学到的东西至今仍然很少(NPR, 2026)。
到了 10 月,OpenAI 一口气公开了 370 多道悬而未决的数学难题解答。消息一出后,多个数学家组成的团体发表公开信,呼吁同行停止与 OpenAI 合作。同时,菲尔兹奖(常被称为数学界的诺贝尔奖)得主陶哲轩,也持续公开批评这种做法。他认为,真正推动数学理解的,是抵达答案的过程,而不只是答案本身(Kahn, 2026)。
人们追求知识,从来不只是为了得到答案,而是为了在得到答案的过程中变得更有能力,从过程中去学习,去理解,去知道它为什么成立、知道怎么检查,也知道什么时候该怀疑。
结语
生成式 AI 的出现,让获取知识变得前所未有地容易。一个问题丢进对话框,几秒钟内就能得到一段结构完整、语气笃定,甚至附上来源的回答。
检查品牌在 AI 回答中的表现时,也应把“有引用”与“说得准确”分开记录。GEO 主题页以 MCAC 四项诊断示范这个区别。
AI 辅助产出内容 发布并被收录 被 AI 检索与引用 生成新的回答 回答再被发布成内容
这条内容创作的链一旦成为常态,就可能形成让网络生态持续恶化的循环。
当这些环节成为一种内容产出的趋势,链上的每个人都会觉得自己只是在做很合理的事:写作的人用 AI 提高效率,搜索的人用 AI 节省时间,平台用 AI 让答案更完整。没有人刻意造假,但这些累积下来的微小错误,却可能被藏在这些合理的选择之间,一层一层地被传下去,逐渐成为既定的事实。
大家不妨想象一个极端的世界。在那里,所有人都放弃了查证,AI 说什么,人们就信什么。
某一天,AI 在某次回答里出了错,说“1+1 等于 3”。有人觉得新奇,便把这件事当成新发现写成文章,还让 AI 替他写好了完整的论证;而后其他人用 AI 查证,AI 找到了这篇文章,于是更笃定地回答“1+1 等于 3”。几轮循环之后,这句话出现在教科书里、出现在试卷上,成了每个人从小就接触到的常识。一百年后,再也没有人记得,1+1 曾经等于 2。
但现实世界并不会因此改变,数学、物理、化学...这些人类几千年历史所积累下来的既定知识之所以存在,便有它的道理。两颗苹果放在一起还是两颗。当最底层的算法常识出错时,人类不免最终走向灭亡,或自欺欺人地重新花费数千年建立一个新的知识体系。
对我来说,这份研究最重要的意义,不在于 16%(被判定为 AI 生成的引用来源比例)这个数据,而在于它让我重新意识到一个很可怕的问题:人们以为 AI 搜索是在帮自己“查资料”,但它查到的资料,可能已经有一部分出自另一个 AI。
身为一个专注于研究 AI 搜索、自己也每天在做内容创作的人,我很清楚自己也身处这个循环之中。对于做 SEO 与 GEO 的人来说,最直接的诱惑,就是用 AI 大量产出内容,换取被 AI 引用的机会。
当 AI 开始引用 AI 生成的文章,网络知识会发生什么?这篇研究还无法给出答案,我也无法给出一个确切的预测。而这份研究同样无法证明,所有经过 AI 生成的内容都会降低信息质量。
但有一个变化值得重新理解。过去,人们往往将搜索结果中的多个来源,视为交叉验证信息的起点。然而,当不同网站上的文章可能都源自同一份 AI 回答时,来源数量便不再能直接反映独立证据的多少。
AI 正在改变的,不只是人们获取知识的方式,也包括未来的知识从何而来。当今天生成的答案成为明天搜索的资料,在处理与筛选网络内容时,将需要更严谨的审视,以免被一次又一次重新包装的说法所欺骗。
参考文献(References)
导读论文
- Allaham, M., & Diakopoulos, N. (2026). Synthetic sources?: Auditing generative search engine citations for evidence of AI-generated sources (arXiv:2605.23684v1) [Preprint]. https://doi.org/10.48550/arXiv.2605.23684
导读论文使用的数据集与工具
- De La Calzada, N., Da Costa, T. A., Blangero, A., & Chesneau, N. (2024). ClimateQ&A: Bridging the gap between climate scientists and the general public (arXiv:2403.14709) [Preprint]. https://arxiv.org/abs/2403.14709
- Emi, B., & Spero, M. (2024). Technical report on the Pangram AI-generated text classifier (arXiv:2402.14873) [Preprint]. https://arxiv.org/abs/2402.14873
- Miroyan, M., Wu, T.-H., King, L., Li, T., Pan, J., Hu, X., Chiang, W.-L., Angelopoulos, A. N., Darrell, T., Norouzi, N., et al. (2025). Search Arena: Analyzing search-augmented LLMs (arXiv:2506.05334) [Preprint]. https://arxiv.org/abs/2506.05334
学术研究
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative engine optimization. In Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD '24). ACM. https://doi.org/10.1145/3637528.3671900
- Cinelli, M., De Francisci Morales, G., Galeazzi, A., Quattrociocchi, W., & Starnini, M. (2021). The echo chamber effect on social media. Proceedings of the National Academy of Sciences, 118(9), e2023301118. https://doi.org/10.1073/pnas.2023301118
- Ding, Y., Facciani, M., Joyce, E., Poudel, A., Bhattacharya, S., Veeramani, B., Aguinaga, S., & Weninger, T. (2025). Citations and trust in LLM generated responses. Proceedings of the AAAI Conference on Artificial Intelligence, 39(22), 23787–23795. https://doi.org/10.1609/aaai.v39i22.34550
- Jacob, C., Kerrigan, P., & Bastos, M. (2025). The chat-chamber effect: Trusting the AI hallucination. Big Data & Society, 12(1), 20539517241306345. https://doi.org/10.1177/20539517241306345
- Sharma, N., Liao, Q. V., & Xiao, Z. (2024). Generative echo chamber? Effects of LLM-powered search systems on diverse information seeking. In Proceedings of the CHI Conference on Human Factors in Computing Systems (CHI '24). ACM. https://doi.org/10.1145/3613904.3642459
研究机构与产业报告
- Bestvater, S., Smith, A., TerBush, C., Baronavski, C., & Chavda, J. (2026, August 20). How much of the internet is written with AI? Pew Research Center. https://www.pewresearch.org/data-labs/2026/08/20/how-much-of-the-internet-is-written-with-ai/
- Chapekis, A., & Lieb, A. (2025, July 22). Google users are less likely to click on links when an AI summary appears in the results. Pew Research Center. https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/
- Linehan, L., & Guan, X. (2026, May 11). We tracked 1,885 pages adding schema. AI citations barely moved. Ahrefs. https://ahrefs.com/blog/schema-ai-citations/
新闻报道
- AI solved one of math's hardest problems. Humanity learned nothing (so far). (2026, September 22). NPR. https://www.npr.org/2026/09/22/nx-s1-5968588/openai-navier-stokes-problem-mathematicians-learn-little
- Gregory, A. (2026a, January 2). Google AI Overviews put people at risk of harm with misleading health advice. The Guardian. https://www.theguardian.com/technology/2026/jan/02/google-ai-overviews-risk-harm-misleading-health-information
- Gregory, A. (2026b, January 11). 'Dangerous and alarming': Google removes some of its AI summaries after users' health put at risk. The Guardian. https://www.theguardian.com/technology/2026/jan/11/google-ai-overviews-health-guardian-investigation
- Kahn, J. (2026, October 7). OpenAI publishes solutions to more than 370 outstanding math challenges. The results divide mathematicians but most agree: Math will never be the same. Fortune. https://fortune.com/2026/10/07/openai-math-controversy-solutions-370-outstanding-challenges-published-criticisms-celebration/
概念说明
- Tavlin, N. (2015). How false news can spread [Video]. TED-Ed. https://ed.ted.com/lessons/how-false-news-can-spread-noah-tavlin
本文引用数据最后核对日期:2026 年 10 月 24 日。