文章目錄文章開頭0%
引言
如今,AI 已經成為人們寫作與研究的日常工具。從搜尋資料、整理大綱到修改文章,許多人為了提升效率,都習慣讓 AI 參與其中。
但當「用 AI 寫作」和「用 AI 找資料」這兩件事逐漸成為趨勢時,一個值得注意的問題隨之浮現:原本未經查證的說法,可能在反覆引用與轉述的過程中,逐漸變成看似有多個來源支持的事實。
舉個例子,假設今天有位研究員發表了一篇文章,宣稱「網站加入 FAQ 常見問題區塊,就能讓 AI 搜尋引用率提高 40%」。然而,這個數字並未經過實驗驗證,只是這位研究員根據少數觀察提出的推測。
文章發布後,某天有位部落客在撰寫 SEO 教學文時,使用 AI 輔助搜尋相關資料,恰好 AI 引用了這篇文章的數據,並放進了回答當中。這位部落客得到 AI 的回答後,沒有進一步查證,便將「FAQ 能提高 40% 的 AI 引用率」寫進自己的 SEO 教學文章。
隨著其他網站陸續引用、改寫,原本只有一篇文章提及的數字,開始出現在不同的網站上。
當未來有使用者詢問相同問題時,AI 可能找到五篇、十篇都提到「40%」的文章,最終給出一個其實沒有任何實證依據的數據。這些內容看似來自不同來源,卻可能都源自那位研究員最初的推測。
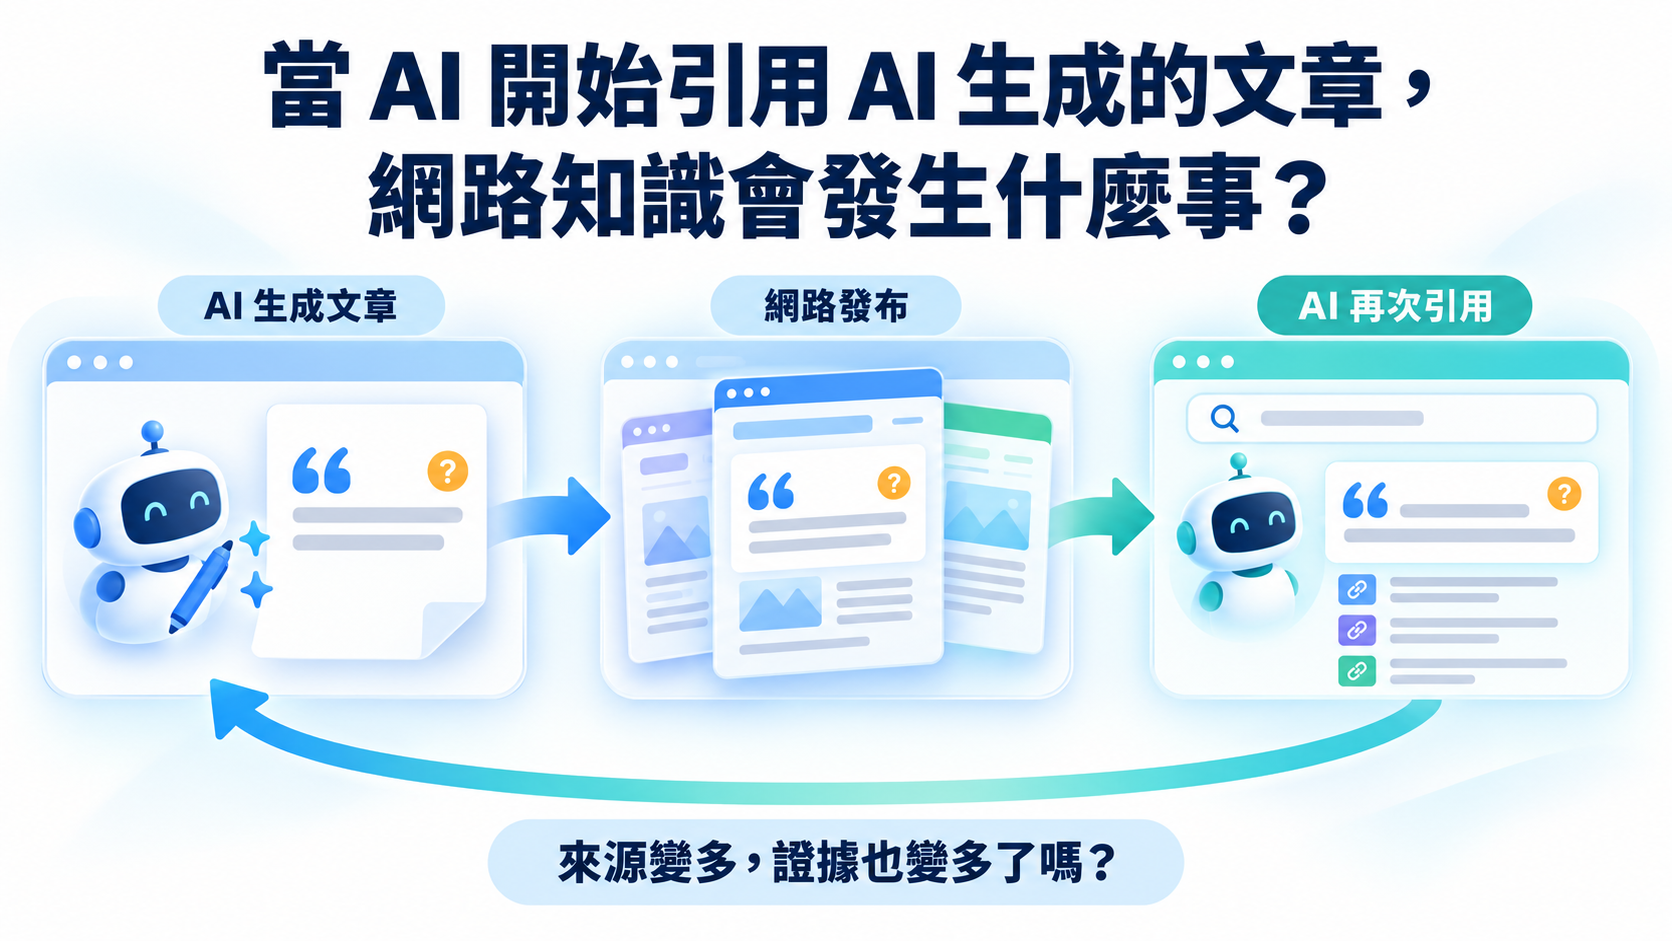
更值得注意的是,當 AI 再次引用這些新文章,而其他創作者又根據 AI 的回答產出更多內容時,相同的資訊便可能不斷回到搜尋結果中,形成反覆引用與再生產的循環。
上述這個例子並非完全虛構。過去網路上其實真的流傳著「做好 FAQ 可以讓 AI 可見度提升 40%」的說法。LS-Labs 實際追溯了一下源頭,發現最開始是普林斯頓大學等機構研究團隊提出的一篇 GEO 概念論文(Aggarwal et al., 2024),裏頭確實提到了做好 GEO,可以讓 AI 可見度提升 40%。
但這個 40%,是研究團隊在自建的 10,000 題測試集上,加入引文、統計數據、引用來源等改寫手法後,能見度的最大提升幅度;在實際上線的 Perplexity 上,最高約為 37%。
而且這項研究測試的手法中,實際上也沒有去添加 FAQ 區塊。另一方面,Ahrefs 在 2026 年 5 月追蹤了 1,885 個新增結構化資料(JSON-LD)的網頁,並與 4,000 個對照頁面比較,發現 AI 引用並沒有明顯提升(Linehan & Guan, 2026)。不過,這些頁面在加入結構化資料前就已經被 AI 大量引用,因此這項研究無法回答「結構化資料對尚未被引用的頁面是否有幫助。」
換句話說,「40%」這個數字正是本文描述的那種擴散方式,一個在有限條件下的實驗,被視作一種常態的行銷手法,逐漸成為一種被默認的事實。
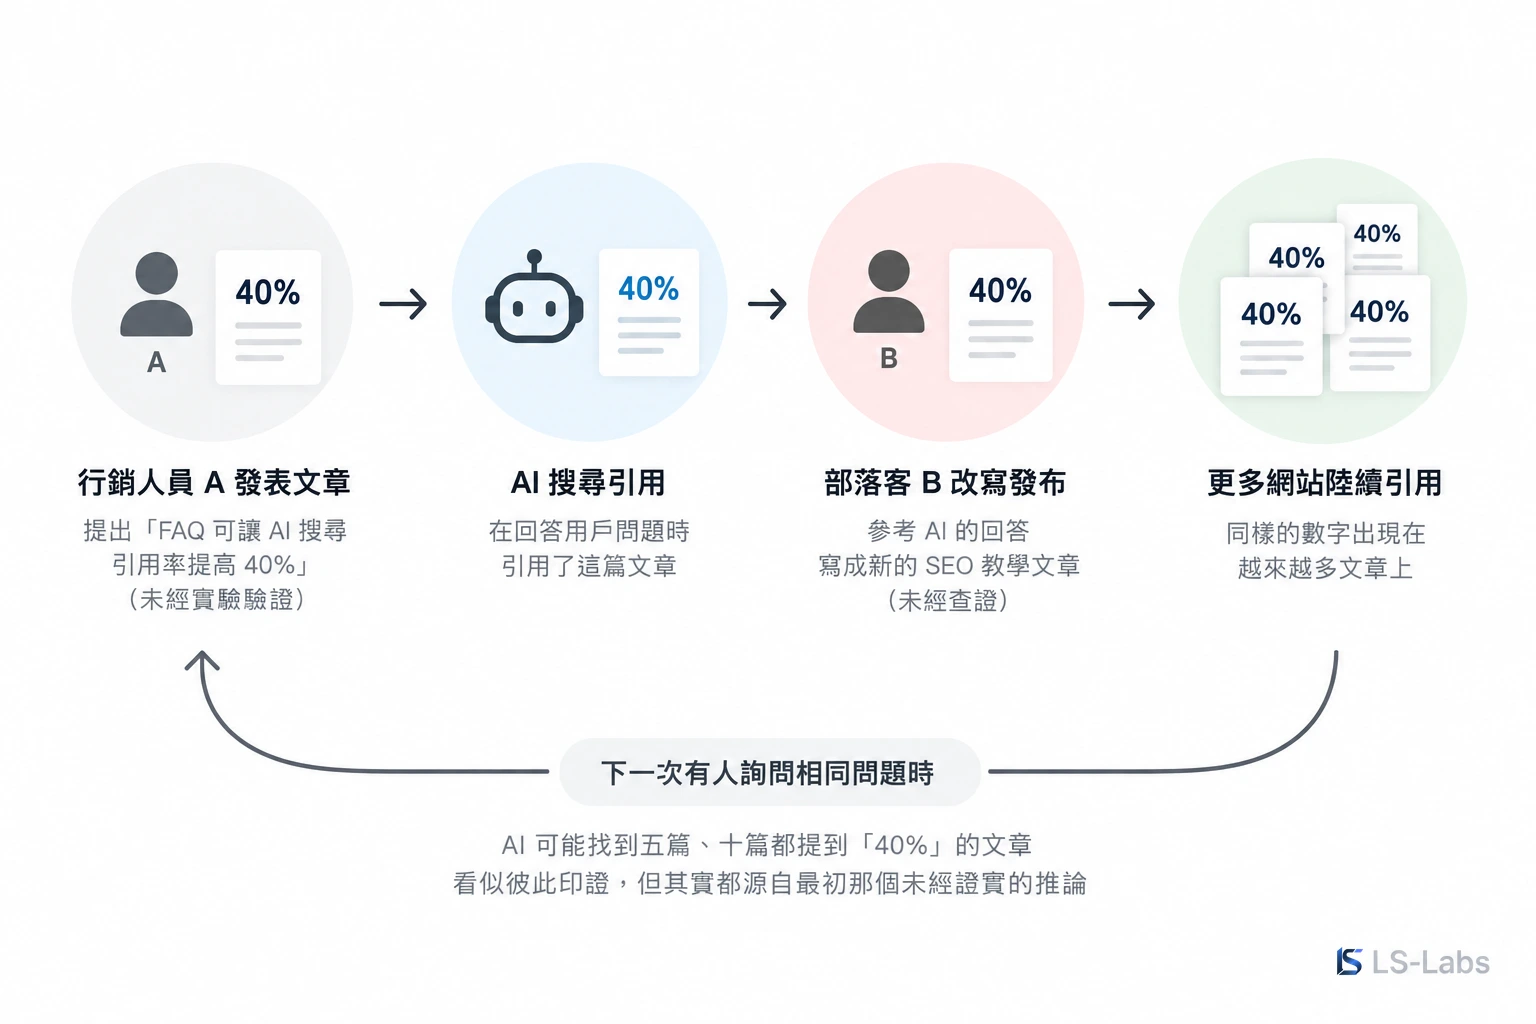
這種自我強化的循環一旦成形,缺乏證據的說法就會因為頻繁曝光,而被當成一種事實。但無論被轉述多少次,最初那個數字依然沒有經過驗證。這些看似彼此印證的文章,本質上只是在重複同一個人的猜測。
而這個循環的第一步,也就是 AI 搜尋是否真的會引用 AI 生成的內容,正是本篇導讀的論文想要研究的問題。
研究發現:每六個引用來源,就有一個可能出自 AI
上述這個循環最大的問題就在於,當網路上越來越多內容由 AI 寫成,AI 搜尋引用的來源,難道還能保證出自人手、經過查證嗎?
2026 年 5 月,西北大學(Northwestern University)的 Mowafak Allaham 與 Nicholas Diakopoulos 發表了一篇預印本〈Synthetic Sources?: Auditing Generative Search Engine Citations for Evidence of AI-Generated Sources〉,本文意譯為〈AI 搜尋引用的來源裡,有多少本身就是 AI 生成的?〉(Allaham & Diakopoulos, 2026)。
研究團隊從兩個公開資料集(Search Arena 與 Climate Q&A)的真實使用者提問中,挑出 712 個與美國相關、涵蓋政治、健康與環境議題的英文問題,並以程式模擬真人操作,逐一輸入 ChatGPT、Copilot、Gemini 與 Perplexity 的網頁介面。他們共收集到 26,266 個被引用的網址,其中 19,154 個頁面成功擷取文字,再交由 AI 文字偵測工具 Pangram 判讀。
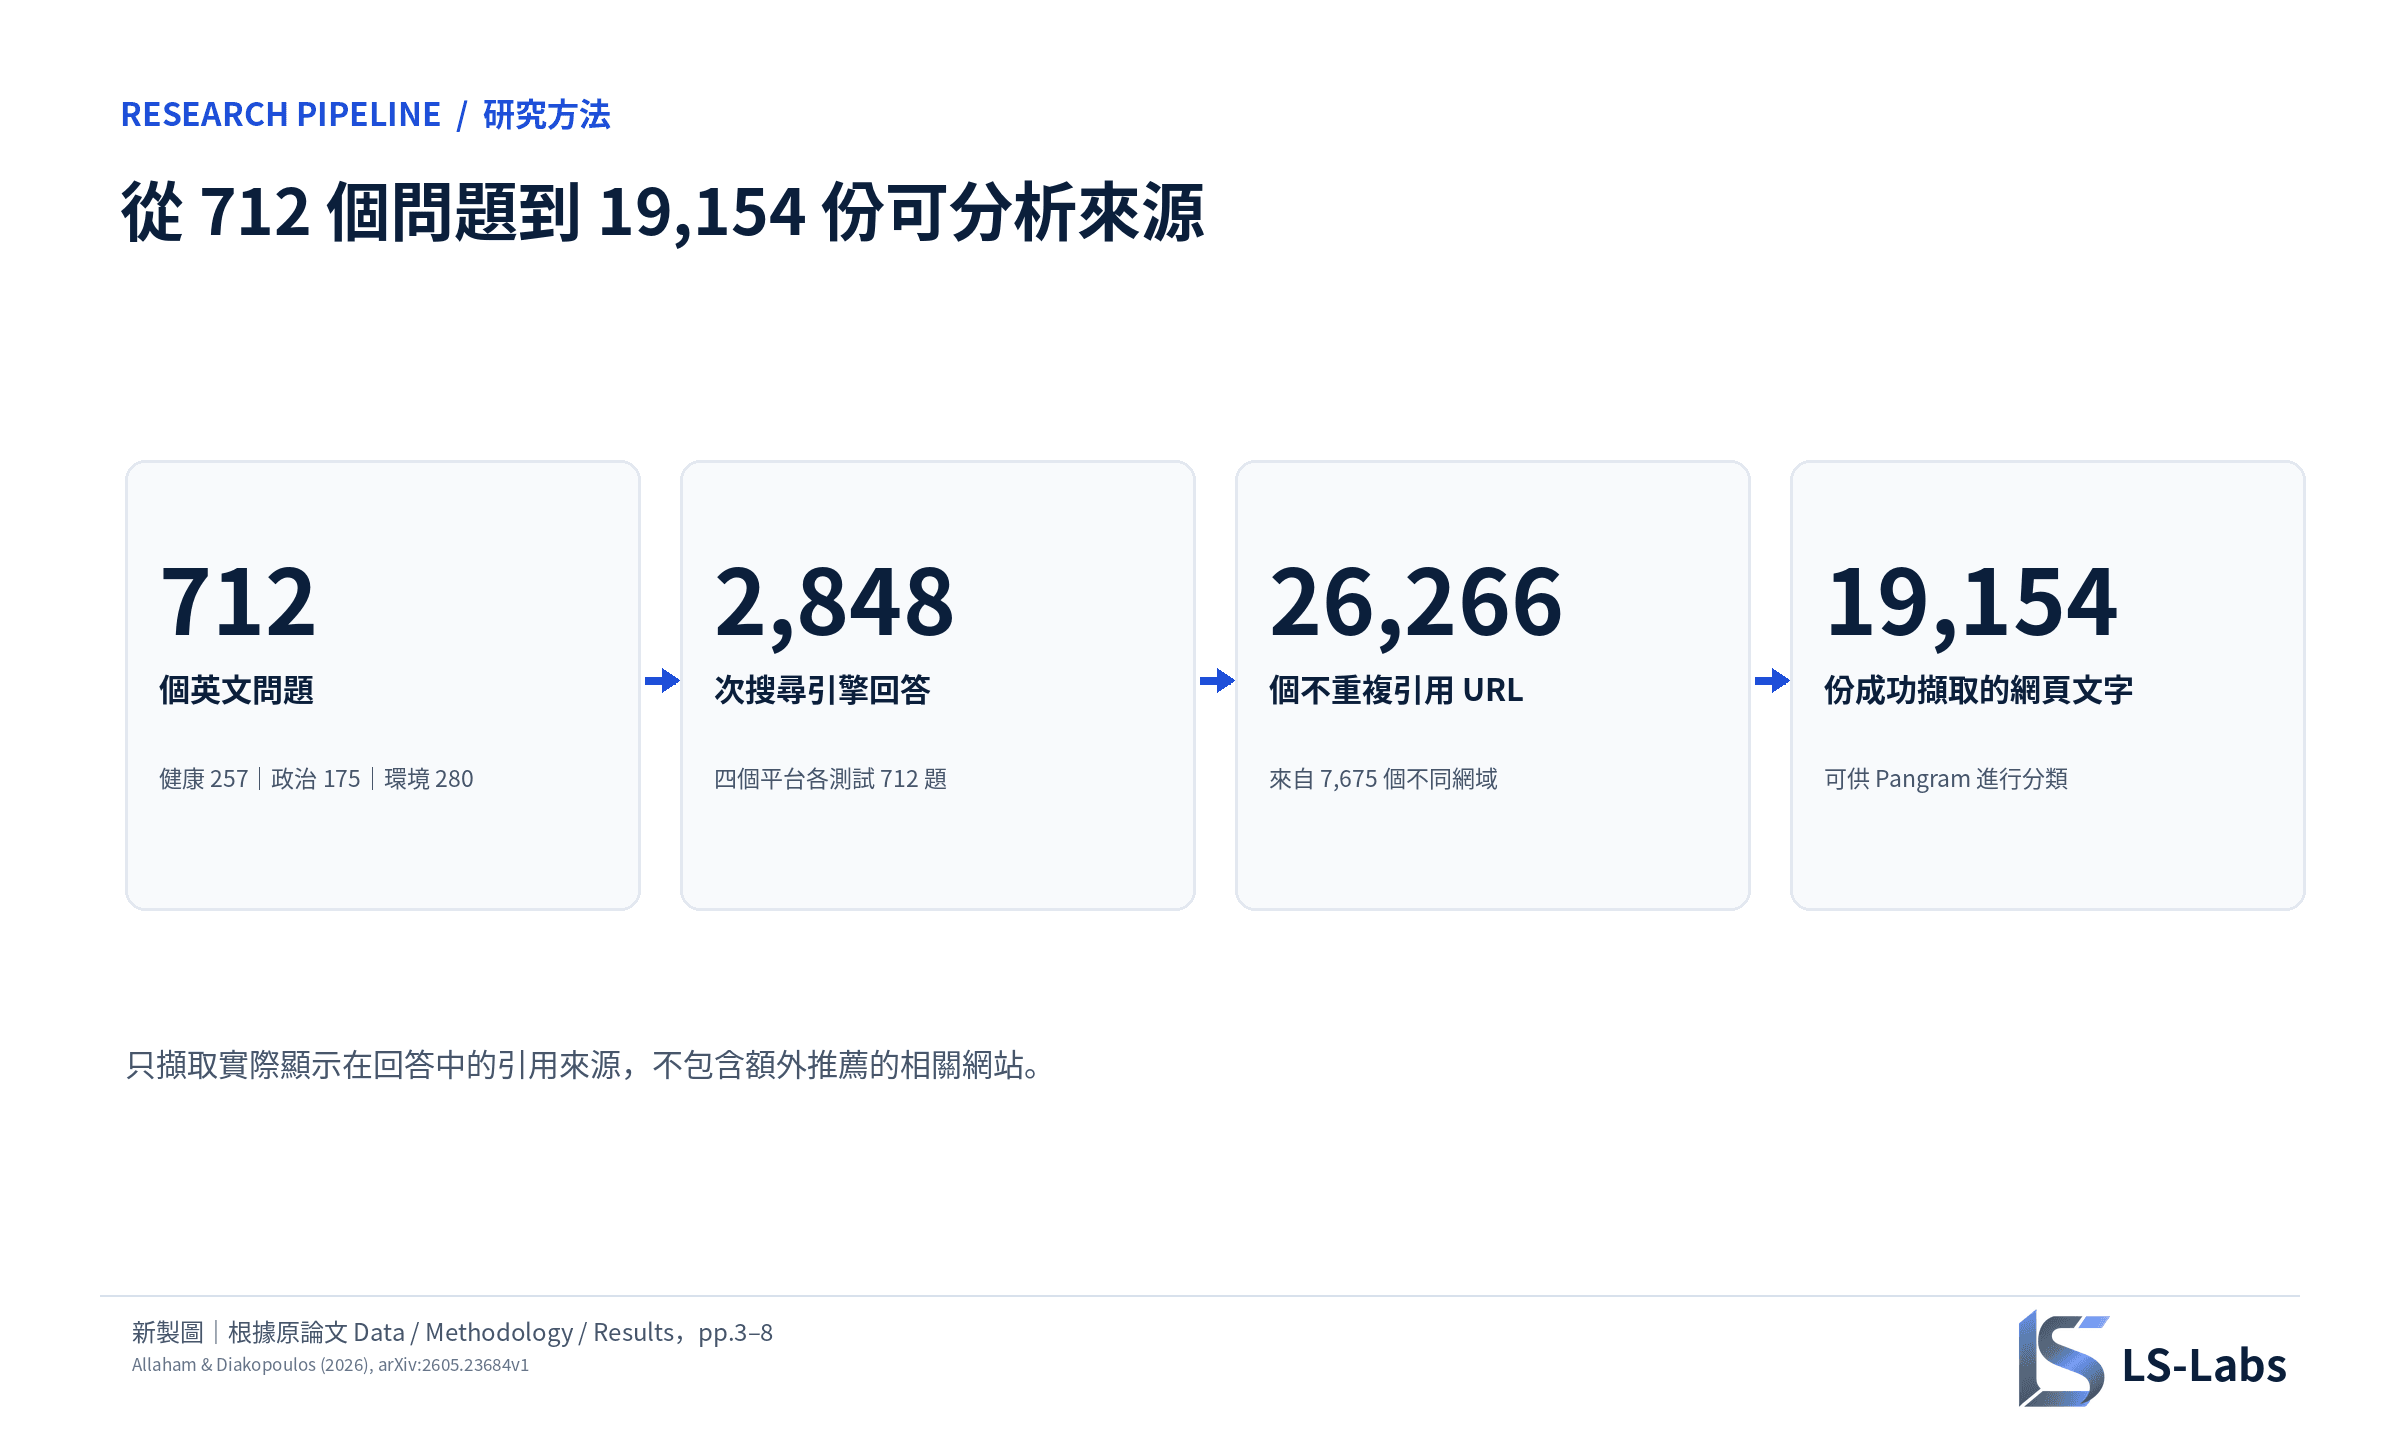
結果顯示,在成功擷取文字的頁面中,約 16% 被判定為 AI 生成,相當於平均每六個來源,就有一個可能出自 AI 之手。作者把這個數字視為保守的下限:一方面,他們選用的偵測工具寧可漏判、也不誤判;另一方面,被判定為「可能是 AI」的模糊案例也沒有計入。
進一步拆解數據後,有三個現象值得注意:
知名平台與官方網站,都出現了 AI 生成內容:研究顯示,被 AI 搜尋引用的頁面中,Reddit 約有 12% 的內容被判為 AI 生成,美國國家醫學圖書館的論文庫約 4%,NASA 主導的 earth.gov 則約 14%,印度主流媒體 Times of India 更是出現了接近一半的可怕比率。換句話說,「來自大站或官方網站」已經不能保證內容出自人手。作者也坦言,這些出現在官方網站上的 AI 內容品質是高是低,目前無法判斷。
不同 AI 生成內容時,對來源的偏好也不同: 四個 AI 搜尋面對同樣的問題、同一個網路,引用的 AI 生成比例卻相差數倍。ChatGPT 平均每則回答引用約 15 個來源,是四家中最多,AI 生成比例卻最低,約 7%;Copilot 平均只引用約 8 個,比例卻接近三成,而且它在三個主題裡最常引用的 AI 生成網站,幾乎整站內容都被判為 AI 生成。這代表引用池的品質並非無法控制,而是各平台挑選來源的標準不同。問題在於,這套標準對使用者完全不透明:使用者不知道自己用的工具篩掉了什麼,又放進了什麼。
最需要準確性的領域,回答中的引用率卻最低:最令人擔心的,莫過於這份研究中顯示,在這些樣本資料中,約有 8.8% 的回答完全沒有附上任何引用。其中健康題的比例最高,約每九則就有一則,高於環境題(約 8%)與政治題(約 6%)。作者推測,這代表 AI 搜尋在部分問題上並沒有上網找資料,而是直接用模型訓練時學到的知識作答,資訊因此可能過時,也更容易出現幻覺。
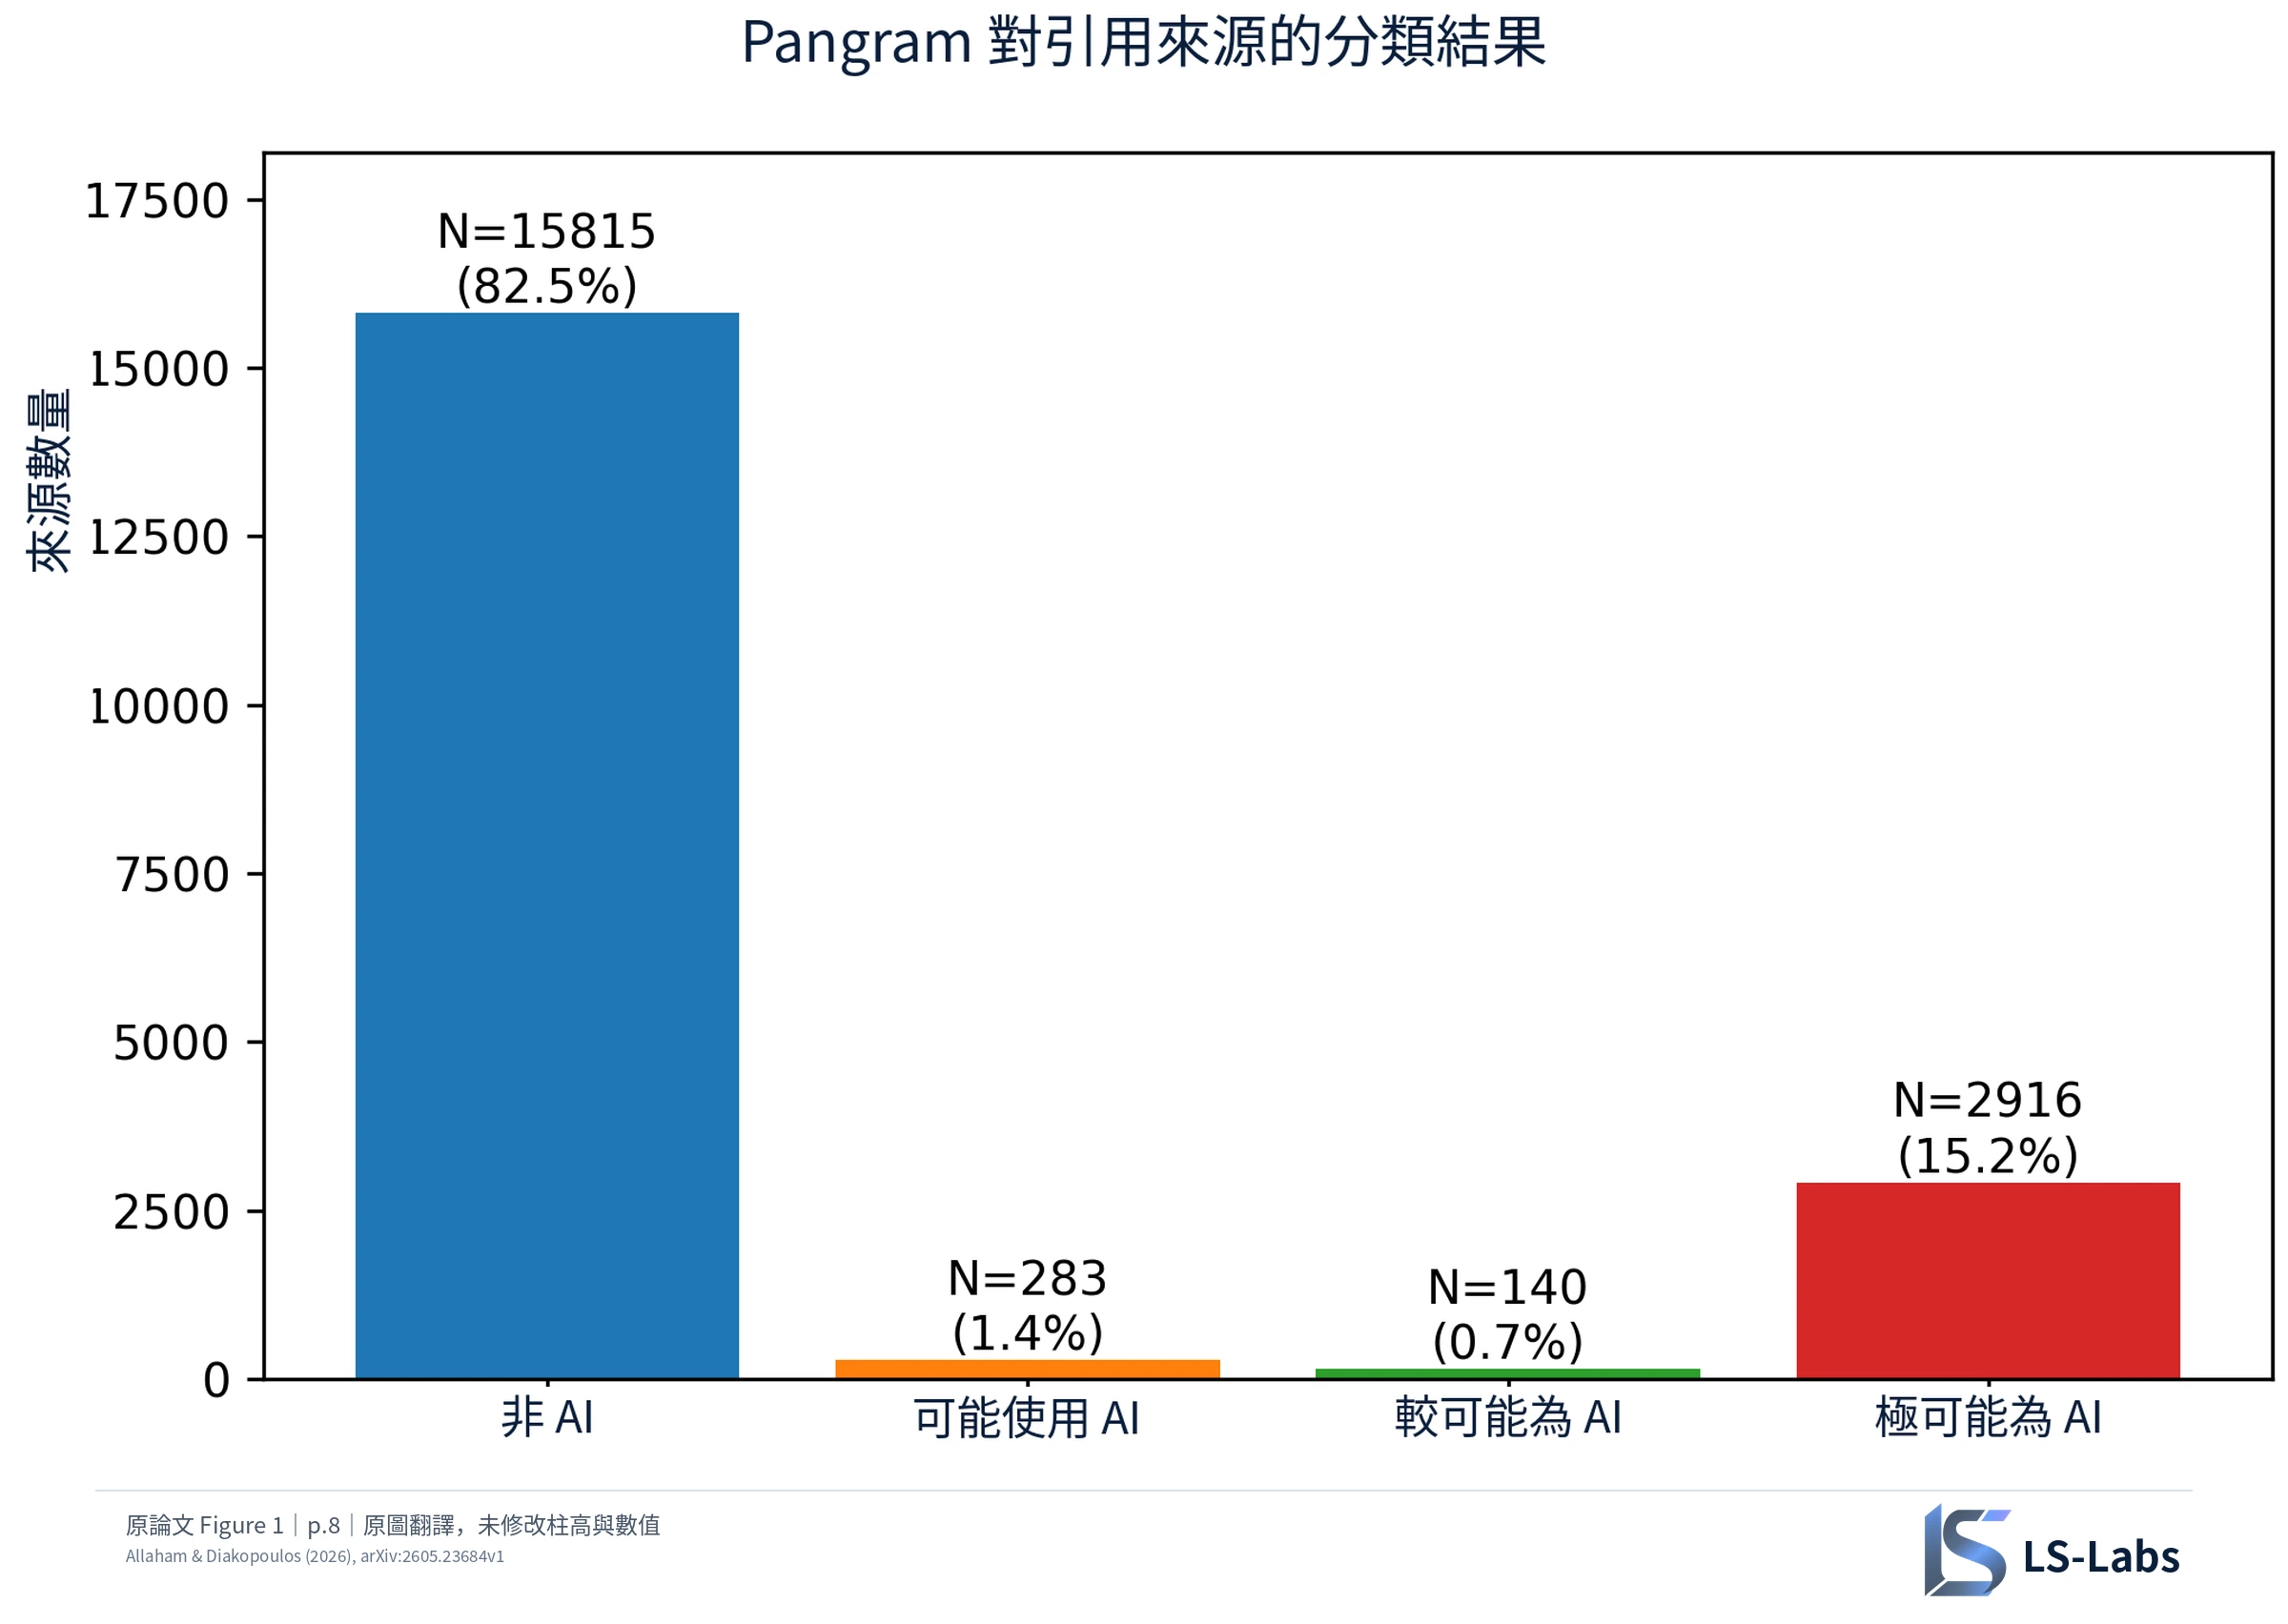
從這份預印本當中,可以明確地見到 AI 生成的內容確實進入了 AI 搜尋的引用池。
同時,這個池子被稀釋的速度還在加快。
皮尤研究中心(Pew Research Center)在 2026 年 8 月分析了 Common Crawl 約 49 萬個英文網頁,發現 .com 網域中帶有明顯 AI 撰寫或實質編修痕跡的比例,從 2024 年初的 3.8%、2025 年初的 5.5%,一路升到 2026 年初的 9.4%(Bestvater et al., 2026)。兩年間成長約 2.5 倍,而且近一年的增幅(約 71%)明顯高於前一年(約 46%)。
AI 搜尋是黑箱:LLM 幻覺的系統性風險
要理解 AI 搜尋的引用池混入 AI 內容,為什麼是一種系統性風險,得先理解 AI 搜尋的運作邏輯。
當使用者向 ChatGPT 或 Perplexity 提問時,系統會先到網路上撈取它認為相關的網頁資料,再交由語言模型重組成一段通順的回答。
問題在於,這整個搜尋與文字重組的過程,使用者完全看不見。它搜尋了哪些頁面、為什麼留下 A 而捨棄 B、回答裡的哪一句對應哪一個來源,使用者幾乎無從得知。
姑且把這種不透明的狀態稱為「黑箱」。
這與語言模型的底層機制有關。語言模型的運作,是根據上文預測下一個最可能出現的詞。例如「讀」的後面,高機率會接「書」,因此它呈現的回答就會是「讀書」。
因此,模型在讀過海量文本後,確實能掌握語法與概念之間的關聯,甚至展現某種推理結構,但這套訓練邏輯並不能保證輸出符合客觀事實,也不能保證它「知道自己不知道」這件事。
基於這個原理,可以得出模型的表達能力與事實可靠度,是兩回事的結論。
更麻煩的是,即使知道答案錯了,也很難找出錯在哪裡。傳統軟體就像一個每條電線都貼好標籤的配電箱,哪盞燈不亮,順著標籤就能找到是哪條線出了問題;語言模型則像一間電線全部纏在一起的房子,而且同一個開關,每次按下去亮的燈還不一定相同。
你今天按下客廳的開關,亮的可能是廁所的燈;隔天按下同一個開關,亮的卻變成了廚房的燈。你看得到哪盞燈亮了,卻找不到是哪條線接過去的。
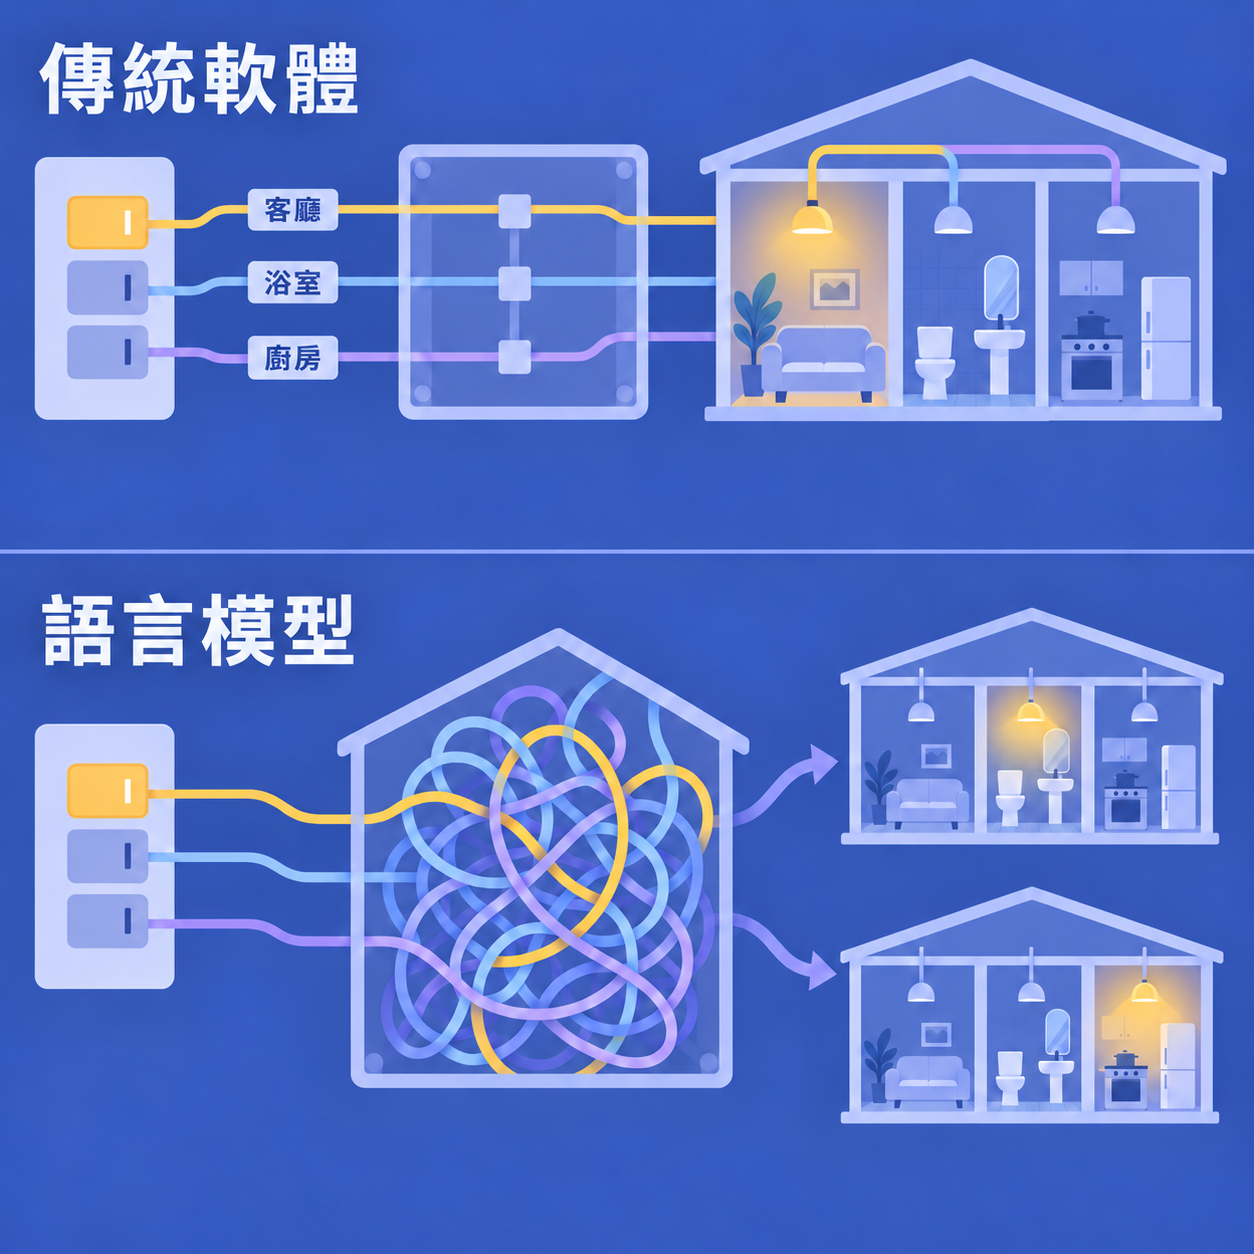
這也是為什麼,目前沒有人能保證 AI 的每一個答案都是對的。模型每一次回答,都是在眾多可能的下一個詞之間做選擇,而不是去查一張寫好標準答案的表。即使是 1+1 這麼簡單的問題,AI 答錯的機率再低,也不會真正等於零。
這個概念套用到 GEO 的領域,可以得知一個很殘酷的事實:既然連 1+1 都只能說「幾乎不會錯」,那麼「讓 AI 一定引用你的品牌」這種承諾,本質上就不可能成立。
行銷人員能做的,只是透過重複測量,觀察品牌在不同提問、不同平台、不同時間下被引用的機率與分布,並盡可能的產出優質內容,提高自己在 AI 眼中的信任度與權重。
話又說回來,AI 公司當然也清楚這些問題。所以既然很難從模型內部逐一修正錯誤,他們除了持續訓練模型,也會讓模型在需要時借助外部工具,而不是全靠自己「想」出答案。比方說,當你請 AI 算一筆複雜的帳,它可能會在背後開一個計算程式來算,而不是憑感覺寫出一個數字;當你問今天的匯率或天氣,它會去查即時資料,而不是憑記憶回答。
AI 搜尋就是這個思路的產物。它就像把閉卷考變成開書考:與其讓模型憑記憶作答,不如讓它先上網翻資料,再根據查到的內容回答。
但開書考想要考得好,得先有兩個前提:
- 書裡寫的答案本身得是對的。
- 考生得有能力從書裡找到正確答案。
而這兩個前提,當前的 AI 搜尋都無法保證。
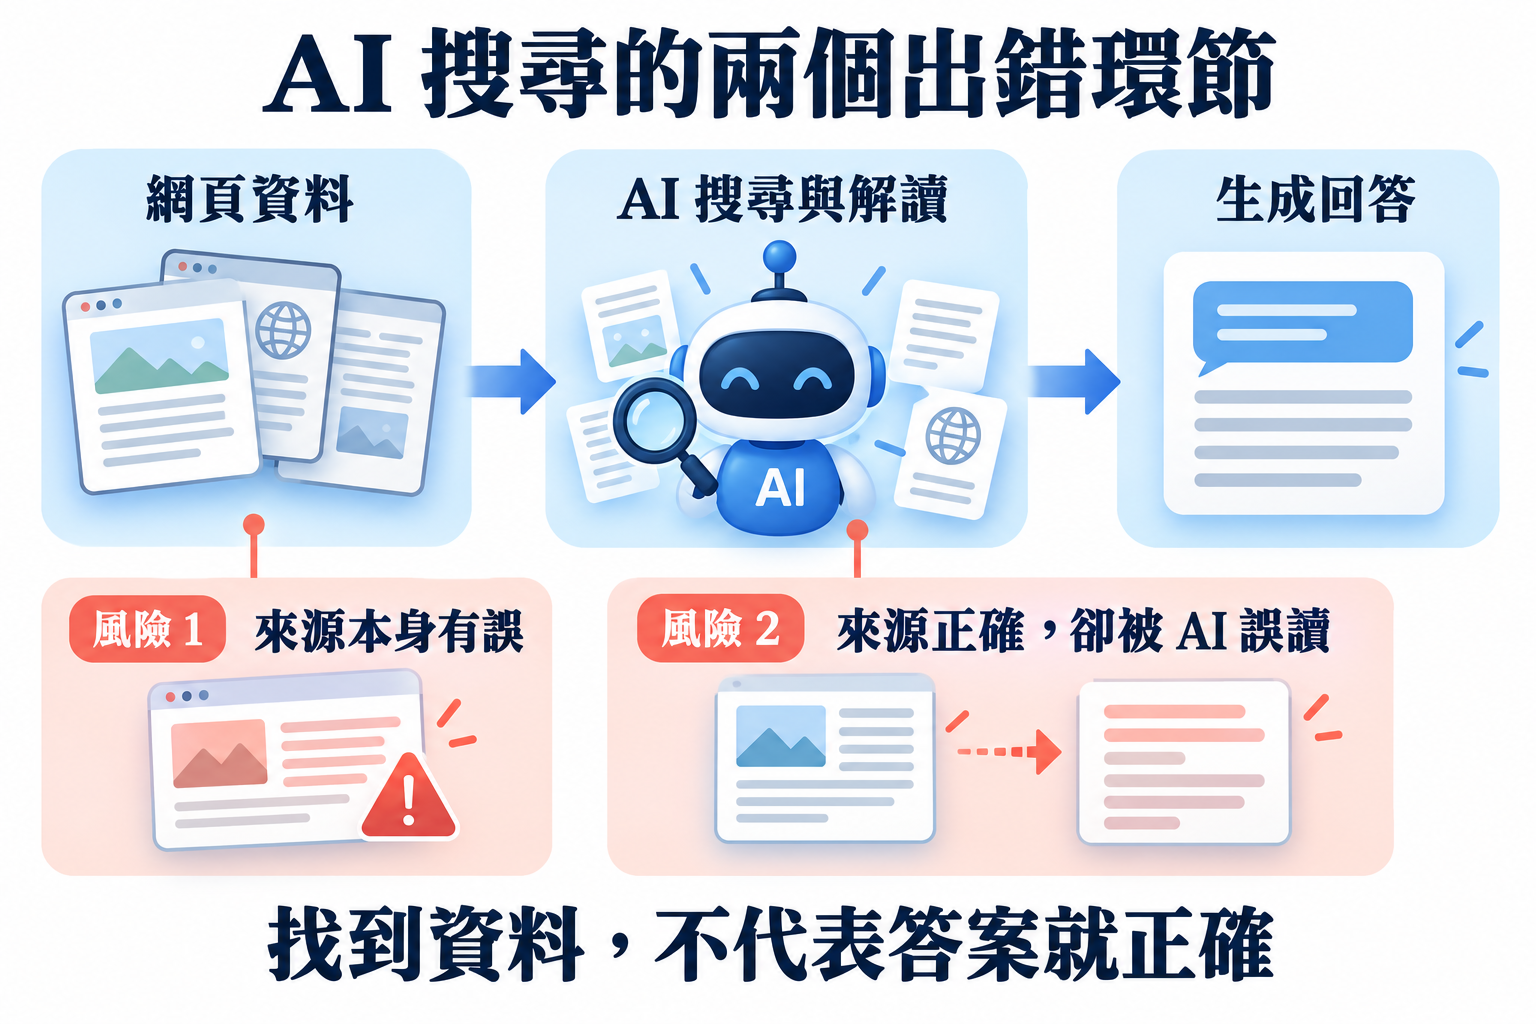
首先,它的可靠程度,取決於抓回來的網頁品質。當網路上的內容開始混入大量未經查證的 AI 生成文字,原本用來約束模型、減少錯誤的外部資料,本身就可能成為錯誤的來源。
其次,即使資料本身正確,搜尋與解讀的過程也並不穩定。同一個問題問兩次,可能抓到不同的頁面;就算抓對了,模型仍可能誤讀或過度延伸,寫出看似語氣篤定、內容卻錯誤連篇的段落,這也就是基於「黑箱」機制所衍伸出的「幻覺」。
更嚴重的是,無論錯誤出在資料來源還是文字解讀,使用者看到的都是一段流暢、自信的回答。
黑箱真正危險的地方,不在於它會出錯,而在於它讓錯誤變得極難察覺。
而這種風險,已經出現在日常使用的產品裡。英國《衛報》(The Guardian)2026 年 1 月初的調查揭露,Google 的 AI 摘要(AI Overviews)提供的錯誤健康資訊,正把使用者推向險境(Gregory, 2026a)。例如,系統曾建議胰臟癌患者避免高脂食物,專家指出這與臨床建議完全相反,甚至可能增加患者的死亡風險;另一個案例則是在肝功能檢查的「正常範圍」上,列出未考量年齡、性別、種族等條件的數字,可能讓重症肝病患者誤以為自己很健康。
儘管 Google 當時回應,絕大多數摘要正確且有幫助,並指部分案例屬於「不完整的截圖」。然而,九天後《衛報》的後續報導指出,Google 已撤下「肝功能檢測正常範圍」等少數查詢的 AI 摘要,證明了他們也默認了這項風險的存在(Gregory, 2026b)。
幻覺的循環:聊天迴聲室效應
如果幻覺只停留在單次對話中,影響的頂多是當事人當下的判斷。但當人們逐漸習慣請 AI 整理資料、補充數據,並在未經核對的情況下直接發布,這些單次對話裡的錯誤,就可能被放大成整個網路生態的問題。
過去在 AI 尚未出現的年代,人們查找資料多使用傳統搜尋引擎。那時面對一整頁連結,通常會選擇點開幾個網站交叉比對,用人腦完成初步篩選。然而到了現在,面對一段由 AI 整理好的答案時,絕大多數人卻都不會選擇去點開那些附註在不起眼處的引用來源,更別提在缺乏背景知識的情況下,抓出回答中的錯誤或漏洞。
這背後牽涉到常被提及的回聲室效應(Echo Chamber Effect,又稱同溫層效應):人們反覆接觸與自己立場相近的說法,較少遇到不同觀點,原有看法便可能在這個圈子裡被不斷強化(Cinelli et al., 2021)。而下面要談的「聊天迴聲室效應」,則把問題帶到了人與 AI 的對話之中。
Jacob、Kerrigan 與 Bastos 在 2025 年的研究中,把這種信任 AI、卻不加查證的現象,命名為「聊天迴聲室效應」(Chat-Chamber Effect,取自 echo chamber 的雙關)(Jacob et al., 2025)。他們讓受試者分別使用 ChatGPT 3.5 與 Google 搜尋,查找印度與愛爾蘭的 LGBTQIA+ 民選代表人數,之後再進行半結構式訪談。
結果發現,語言模型可能提供錯誤、卻符合使用者既有立場的資訊,而使用者不僅照單全收、不做交叉查證,還會把這些未經證實的資訊內化,形成封閉的回饋循環。
Sharma、Liao 與 Xiao 在 CHI 2024 發表的實驗,則從資訊多樣性的角度,補充了 AI 使用者的行為分析(Sharma et al., 2024)。研究發現,比起傳統搜尋,使用對話式 AI 搜尋的受試者,提問方式更偏向自身原有的立場;而當研究者刻意讓 AI 附和使用者的既有觀點時,這種偏向自身立場的資訊搜尋又被進一步放大。
當 AI 內容氾濫:來源越多,就越可信嗎?
在 AI 出現之前,「多方查證」是每個內容創作者最基本的能力,同時也是每個人潛意識裡的習慣。例如新聞業要求一則消息至少兩個獨立消息來源;學術研究要求追到一手文獻,甚至精確到必須提供引用的句子;而一般人在做決定前通常也會多開幾個分頁來做比對與驗證。
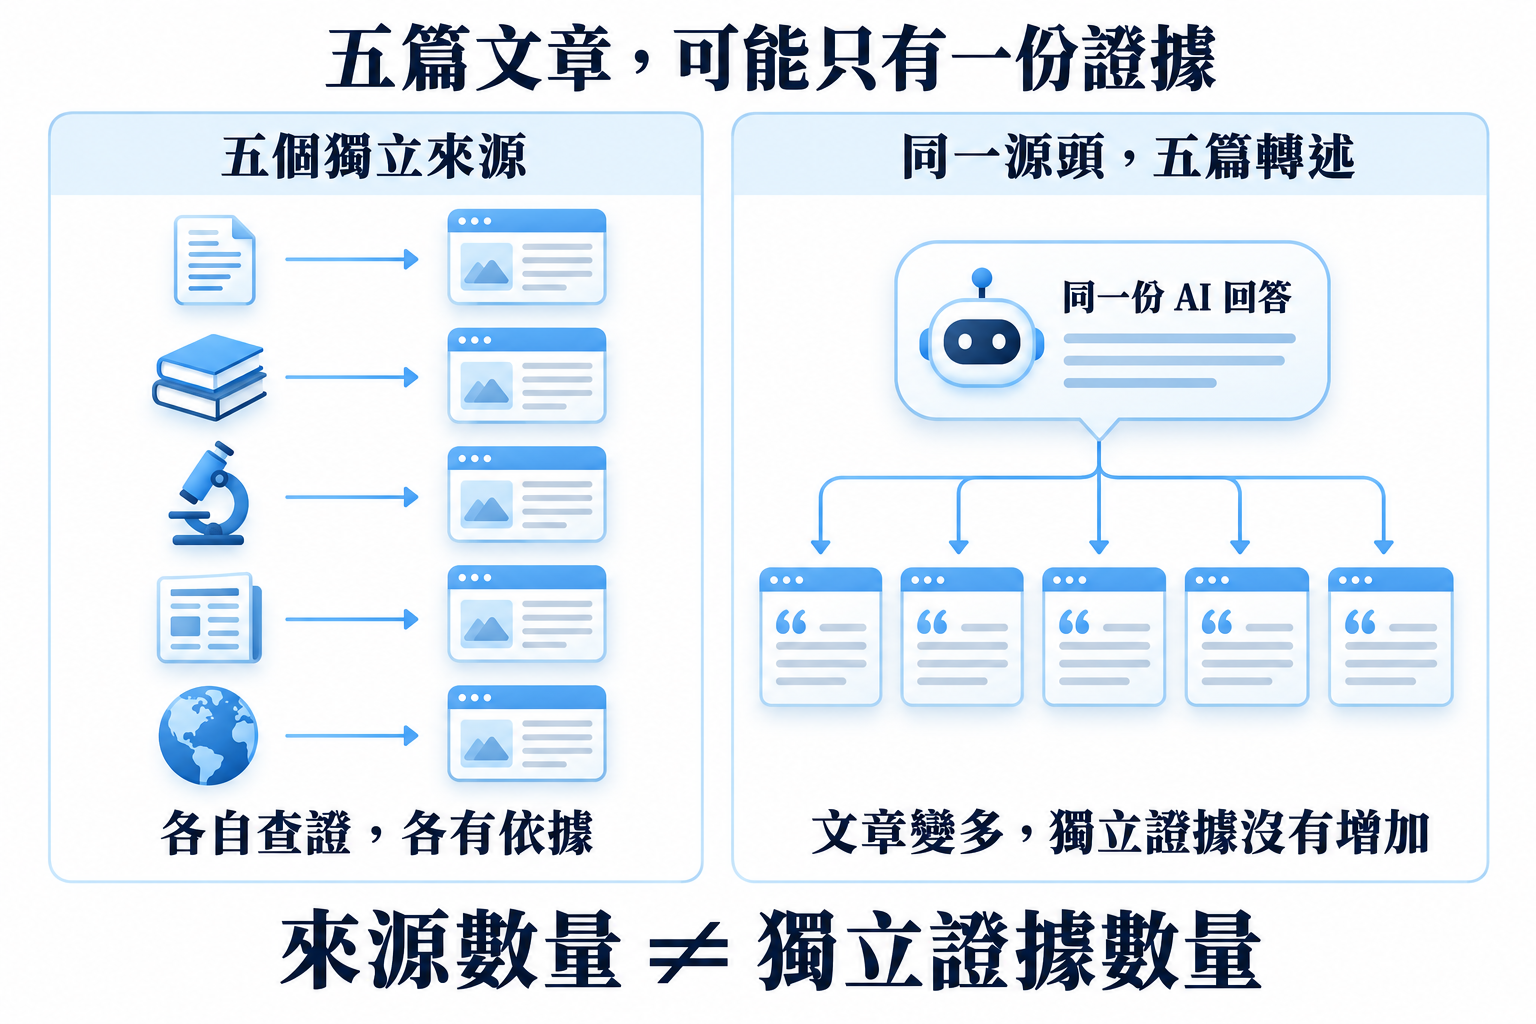
而這個習慣的背後,其實有個鮮為人知的前提,那就是這些來源必須彼此獨立。為何五個來源會比一個有說服力?是因為這五個觀察者各自接觸了原始證據,並得出相同結論,最後將各自的見解上傳至網路。
但如果這五篇文章只是互相抄襲、轉述同一個源頭,那麼讀者多少能夠發現這些來源的證據力並沒有增加,因為它們就只是同一套說法的五份副本。新聞與情報分析把這種假象稱為「循環報導」(circular reporting)(Tavlin, 2015)。
可到了 AI 時代,這個埋在每個人骨子裡的習慣,似乎直接被 AI 給剝奪了。
皮尤研究中心分析 900 名美國成年人的瀏覽紀錄後發現,在出現 AI 摘要的 Google 搜尋頁中,使用者點擊摘要內來源連結的情況,只占約 1% 的造訪;就連一般搜尋結果的點擊率,也從無摘要時的 15% 降到 8%(Chapekis & Lieb, 2025)。
不過有趣的是,儘管人們幾乎不再點開連結,去查證 AI 說的真偽,但這不代表「引用」這件事便是無效的,它反而變成一種 AI 給予人類,純粹的信任指標。
美國聖母大學(University of Notre Dame)與德勤(Deloitte)的研究團隊在 2025 年發表的實驗中,讓 303 位受試者閱讀聊天機器人的回答,並隨機附上數量與相關性不同的引用(Ding et al., 2025)。
結果發現,只要回答後面掛著引用標記,受試者的信任度就顯著上升,哪怕那些連結是隨機挑選、與內文毫無關聯;在所有附有引用的回答中,只有不到一成曾被受試者點開查看,而那些真正有意識去動手查看引用來源的受試者,對於 AI 回答給出的信任分數反而明顯降低。
這揭示了一個弔詭的現象:人們依然把「有來源支持」當作可信度的指標,卻已經不再親自檢查這些來源是否獨立、是否真實,而是把這份工作全權交給了 AI。
零成本複製時代的知識困境
回頭看這份研究延伸出的問題,我認為可以用「供給」與「需求」來理解。
在供給端,內容的生產正在加速。AI 讓寫文章、做摘要、整理知識變得前所未有地容易。
在需求端,取得答案的速度也在加快。使用者透過 AI,幾秒鐘就能拿到一段整理好的回答。但取得答案變快,不代表理解與判斷的能力也以同樣的速度成長。
這就衍生出一個較具哲學性的思辨:資訊的生產者用 AI 輸出,資訊的吸收者用 AI 取得答案,這中間卻鮮少有人停下來,確認自己建立的知識是否正確。
真正讓我在意的是,AI 時代的資訊產出效率確實提升了,但這份效率,是否真正轉化成了人類知識與能力的增長?
這個困惑,與數學界最近鬧得沸沸揚揚的事件不謀而合。
2026 年 9 月,OpenAI 宣布其模型解出了一道與 Navier-Stokes 方程有關的難題,但看過論文的數學家認為,這份證明幾乎無法閱讀,人類從中學到的東西至今仍然很少(NPR, 2026)。
到了 10 月,OpenAI 一口氣公開了 370 多道懸而未決的數學難題解答。消息一出後,多個數學家組成的團體發表公開信,呼籲同行停止與 OpenAI 合作。同時,菲爾茲獎(常被稱為數學界的諾貝爾獎)得主陶哲軒,也持續公開批評這種做法。他認為,真正推動數學理解的,是抵達答案的過程,而不只是答案本身(Kahn, 2026)。
人們追求知識,從來不只是為了得到答案,而是為了在得到答案的過程中變得更有能力,從過程中去學習,去理解,去知道它為什麼成立、知道怎麼檢查,也知道什麼時候該懷疑。
結語
生成式 AI 的出現,讓取得知識變得前所未有地容易。一個問題丟進對話框,幾秒鐘內就能得到一段結構完整、語氣篤定,甚至附上來源的回答。
檢查品牌在 AI 回答中的表現時,也應把「有引用」與「說得正確」分開記錄。GEO 主題頁以 MCAC 四項診斷示範這個區別。
AI 輔助產出內容 發布並被收錄 被 AI 檢索與引用 生成新的回答 回答再被發布成內容
這條內容創作的鏈一旦成為常態,就可能形成讓網路生態持續惡化的循環。
當這些環節成為一種內容產出的趨勢,鏈上的每個人都會覺得自己只是在做很合理的事:寫作的人用 AI 提高效率,搜尋的人用 AI 節省時間,平台用 AI 讓答案更完整。沒有人刻意造假,但這些累積下來的微小錯誤,卻可能被藏在這些合理的選擇之間,一層一層地被傳下去,逐漸成為既定的事實。
大家不妨想像一個極端的世界。在那裡,所有人都放棄了查證,AI 說什麼,人們就信什麼。
某一天,AI 在某次回答裡出了錯,說「1+1 等於 3」。有人覺得新奇,便把這件事當成新發現寫成文章,還讓 AI 替他寫好了完整的論證;而後其他人用 AI 查證,AI 找到了這篇文章,於是更篤定地回答「1+1 等於 3」。幾輪循環之後,這句話出現在教科書裡、出現在考卷上,成了每個人從小學到的常識。一百年後,再也沒有人記得,1+1 曾經等於 2。
但現實世界並不會因此改變,數學、物理、化學...這些人類幾千年歷史所積累下來的既定知識之所以存在,便有它的道理。兩顆蘋果放在一起還是兩顆。當最底層的算法常識出錯時,人類不免最終走向滅亡,或自欺欺人地重新花費數千年建立一個新的知識體系。
對我來說,這份研究最重要的意義,不在於 16%(被判定為 AI 生成的引用來源比例)這個數據,而在於它讓我重新意識到一個很可怕的問題:多數人以為 AI 搜尋是在幫自己「查資料」,但它查到的資料,可能已經有一部分出自另一個 AI。
身為一個專注於研究 AI 搜尋、自己也每天在做內容創作的人,我很清楚自己也身在這個循環之中。對於做 SEO 與 GEO 的人來說,最直接的誘惑,就是用 AI 大量產出內容,換取被 AI 引用的機會。
當 AI 開始引用 AI 生成的文章,網路知識會發生什麼事?這篇研究還無法給出答案,我也無法給出一個確切的預測。而這份研究同樣無法證明,所有經過 AI 生成的內容都會降低資訊品質。
但有一個變化值得重新理解。過去,人們往往將搜尋結果中的多個來源,視為交叉驗證資訊的起點。然而,當不同網站上的文章可能都源自同一份 AI 回答時,來源數量便不再能直接反映獨立證據的多寡。
AI 正在改變的,不只是人們取得知識的方式,也包括未來的知識從何而來。當今天生成的答案成為明天搜尋的資料,讀者在處理與篩選網路內容時,將需要更嚴謹的審視,以免被一次又一次重新包裝的說法所欺騙。
參考文獻(References)
導讀論文
- Allaham, M., & Diakopoulos, N. (2026). Synthetic sources?: Auditing generative search engine citations for evidence of AI-generated sources (arXiv:2605.23684v1) [Preprint]. https://doi.org/10.48550/arXiv.2605.23684
導讀論文使用的資料集與工具
- De La Calzada, N., Da Costa, T. A., Blangero, A., & Chesneau, N. (2024). ClimateQ&A: Bridging the gap between climate scientists and the general public (arXiv:2403.14709) [Preprint]. https://arxiv.org/abs/2403.14709
- Emi, B., & Spero, M. (2024). Technical report on the Pangram AI-generated text classifier (arXiv:2402.14873) [Preprint]. https://arxiv.org/abs/2402.14873
- Miroyan, M., Wu, T.-H., King, L., Li, T., Pan, J., Hu, X., Chiang, W.-L., Angelopoulos, A. N., Darrell, T., Norouzi, N., et al. (2025). Search Arena: Analyzing search-augmented LLMs (arXiv:2506.05334) [Preprint]. https://arxiv.org/abs/2506.05334
學術研究
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative engine optimization. In Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD '24). ACM. https://doi.org/10.1145/3637528.3671900
- Cinelli, M., De Francisci Morales, G., Galeazzi, A., Quattrociocchi, W., & Starnini, M. (2021). The echo chamber effect on social media. Proceedings of the National Academy of Sciences, 118(9), e2023301118. https://doi.org/10.1073/pnas.2023301118
- Ding, Y., Facciani, M., Joyce, E., Poudel, A., Bhattacharya, S., Veeramani, B., Aguinaga, S., & Weninger, T. (2025). Citations and trust in LLM generated responses. Proceedings of the AAAI Conference on Artificial Intelligence, 39(22), 23787–23795. https://doi.org/10.1609/aaai.v39i22.34550
- Jacob, C., Kerrigan, P., & Bastos, M. (2025). The chat-chamber effect: Trusting the AI hallucination. Big Data & Society, 12(1), 20539517241306345. https://doi.org/10.1177/20539517241306345
- Sharma, N., Liao, Q. V., & Xiao, Z. (2024). Generative echo chamber? Effects of LLM-powered search systems on diverse information seeking. In Proceedings of the CHI Conference on Human Factors in Computing Systems (CHI '24). ACM. https://doi.org/10.1145/3613904.3642459
研究機構與產業報告
- Bestvater, S., Smith, A., TerBush, C., Baronavski, C., & Chavda, J. (2026, August 20). How much of the internet is written with AI? Pew Research Center. https://www.pewresearch.org/data-labs/2026/08/20/how-much-of-the-internet-is-written-with-ai/
- Chapekis, A., & Lieb, A. (2025, July 22). Google users are less likely to click on links when an AI summary appears in the results. Pew Research Center. https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/
- Linehan, L., & Guan, X. (2026, May 11). We tracked 1,885 pages adding schema. AI citations barely moved. Ahrefs. https://ahrefs.com/blog/schema-ai-citations/
新聞報導
- AI solved one of math's hardest problems. Humanity learned nothing (so far). (2026, September 22). NPR. https://www.npr.org/2026/09/22/nx-s1-5968588/openai-navier-stokes-problem-mathematicians-learn-little
- Gregory, A. (2026a, January 2). Google AI Overviews put people at risk of harm with misleading health advice. The Guardian. https://www.theguardian.com/technology/2026/jan/02/google-ai-overviews-risk-harm-misleading-health-information
- Gregory, A. (2026b, January 11). 'Dangerous and alarming': Google removes some of its AI summaries after users' health put at risk. The Guardian. https://www.theguardian.com/technology/2026/jan/11/google-ai-overviews-health-guardian-investigation
- Kahn, J. (2026, October 7). OpenAI publishes solutions to more than 370 outstanding math challenges. The results divide mathematicians but most agree: Math will never be the same. Fortune. https://fortune.com/2026/10/07/openai-math-controversy-solutions-370-outstanding-challenges-published-criticisms-celebration/
概念說明
- Tavlin, N. (2015). How false news can spread [Video]. TED-Ed. https://ed.ted.com/lessons/how-false-news-can-spread-noah-tavlin
本文引用數據最後核對日期:2026 年 10 月 24 日。