文章目錄文章開頭0%
過去二十年的數位行銷,大多建立在一條單純的線性路徑之上:使用者輸入關鍵字、搜尋引擎提供連結、使用者點擊連結進入網站,最終流量在官方或第三方網站中完成轉換。
然而,生成式 AI 的崛起,正在改寫這條路徑。Google AI Overviews(AIO)、ChatGPT、Perplexity 等產品,讓人們習慣直接在搜尋頁或對話框中完成資訊的獲取,這便導致原先的線性路徑正在被截斷。
本報告聚焦於當前生成式檢索的運作機制中的直覺迷思:如果許多沒有獨立官網的老店,仍然能出現在 AI 的推薦名單裡,那品牌為什麼還需要官網?
基於這個矛盾出發,本報告結合綜合公開研究、平台文件與台北六家牛肉麵商家的 Perplexity Sonar API 實測,得出以下結論。
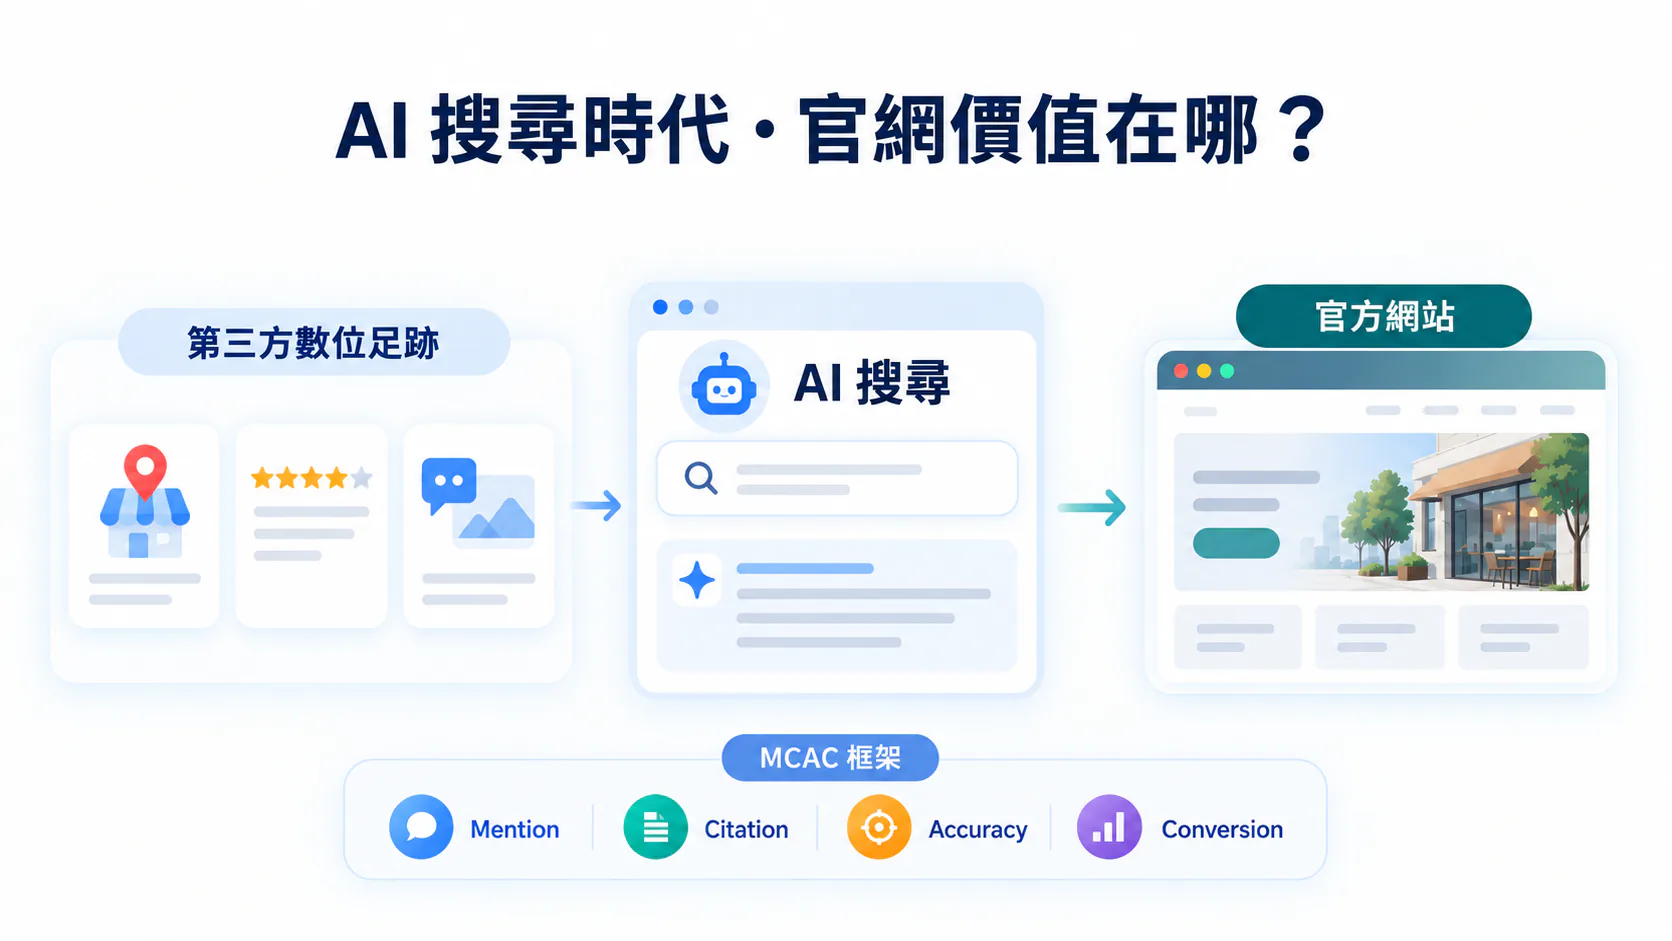
MCAC 框架:Mention、Citation、Accuracy、Conversion-readiness。
目標是分別回答四個問題:固定提問下,AI 是否提到品牌?答案列出哪些來源?可核對的資訊是否正確?回答是否提供使用者可採取的下一步?
MCAC 用於區分品牌在能見度、引用來源、資訊品質與行動入口上的缺口;本次資料沒有測量轉換率。
一、緒論
1.1 研究背景
過去二十年的搜尋引擎生態,核心邏輯是一條線性的路徑,使用者產生資訊需求、搜尋引擎透過演算法排序網頁連結、使用者點擊進入官方或第三方網站,在網站內完成理解與轉換。
在這個單一的線性架構下,網站即是流量的終點,也是所有行銷轉換發生的核心場域,所有的搜尋意圖都被收斂在單一網站當中。
然而,隨著 Google AI Overviews、ChatGPT 與 Perplexity 等 AI 應用產品普及,搜尋引擎正在從「目錄導流系統」轉變成「資訊整合系統」。
品牌可以在使用者從未造訪官方網站的情況下,被 AI 摘要、推薦,甚至直接給出電話、地址等轉換入口。對行銷人而言,這意味著過去用「排名 → 點擊 → 網站 → 轉換」描述搜尋價值的方式,開始出現斷裂。
1.2 研究問題與目的
討論 AI 搜尋與 GEO 時,常見的假設是:「品牌必須做好官網與結構化資料,AI 才能讀懂並推薦。」本研究檢查這個假設在小型樣本中的觀測結果。
但只要實際透過 AI 應用或 SERP 中的 AIO 查詢台灣各地的在地名店,就會發現一個明顯的矛盾:許多只有 Google 商家檔案、Facebook 粉專,甚至連粉專都沒有更新的老字號小吃店,依然頻繁出現在 AI 的推薦清單中,且地址、招牌菜與營業資訊往往十分準確。
這引出了一個核心問題:如果沒有官網也能被 AI 推薦,那官網到底替品牌增加了什麼價值?在 AI 搜尋時代,該如何重新定義並量測這種價值?
二、AI 搜尋如何改變曝光與獲客
2.1 流量漏斗的轉變:藍色連結的失效與 SERP 閉環
傳統的搜尋主要是透過藍色連結導流與監測成效,因為使用者必須前往外部網站才能獲取完整的資訊,得到確切的答案。但在生成式 AI 普及的當下,這條路徑從單一的線性,變成了多分支,甚至是圓形的路徑閉環。除了傳統的 SERP 被 AIO 截獲外,AI 應用本身也是一種 SERP,使用者向 GPT 提問 → GPT 直接提供答案 → 使用者完成資訊的獲取,實際上使用者在這條路徑中,從未去接觸藍色連結,也就是網站本身。
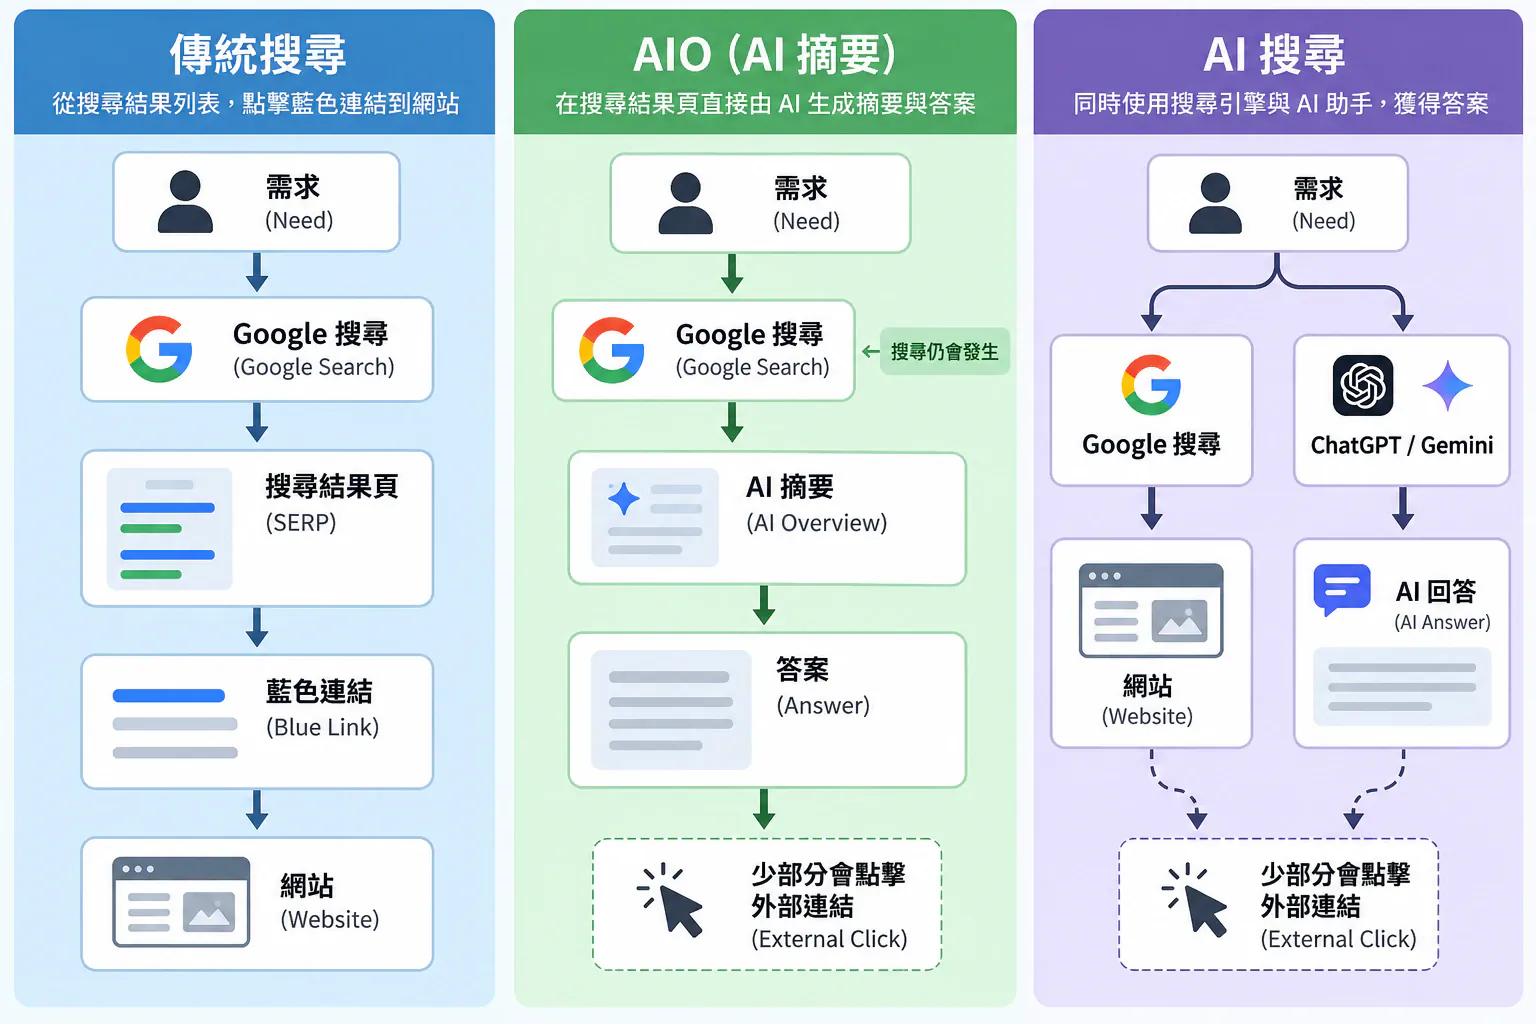
根據 Pew Research Center 追蹤 900 名美國成人的瀏覽紀錄顯示:在出現 Google AI 摘要的搜尋中,僅約 8% 會點擊傳統搜尋結果;在未出現 AI 摘要時,點擊率則為 15%;使用者點擊摘要內來源連結的比例約為 1%。這些觀測顯示,取得答案後不一定會點進網站。
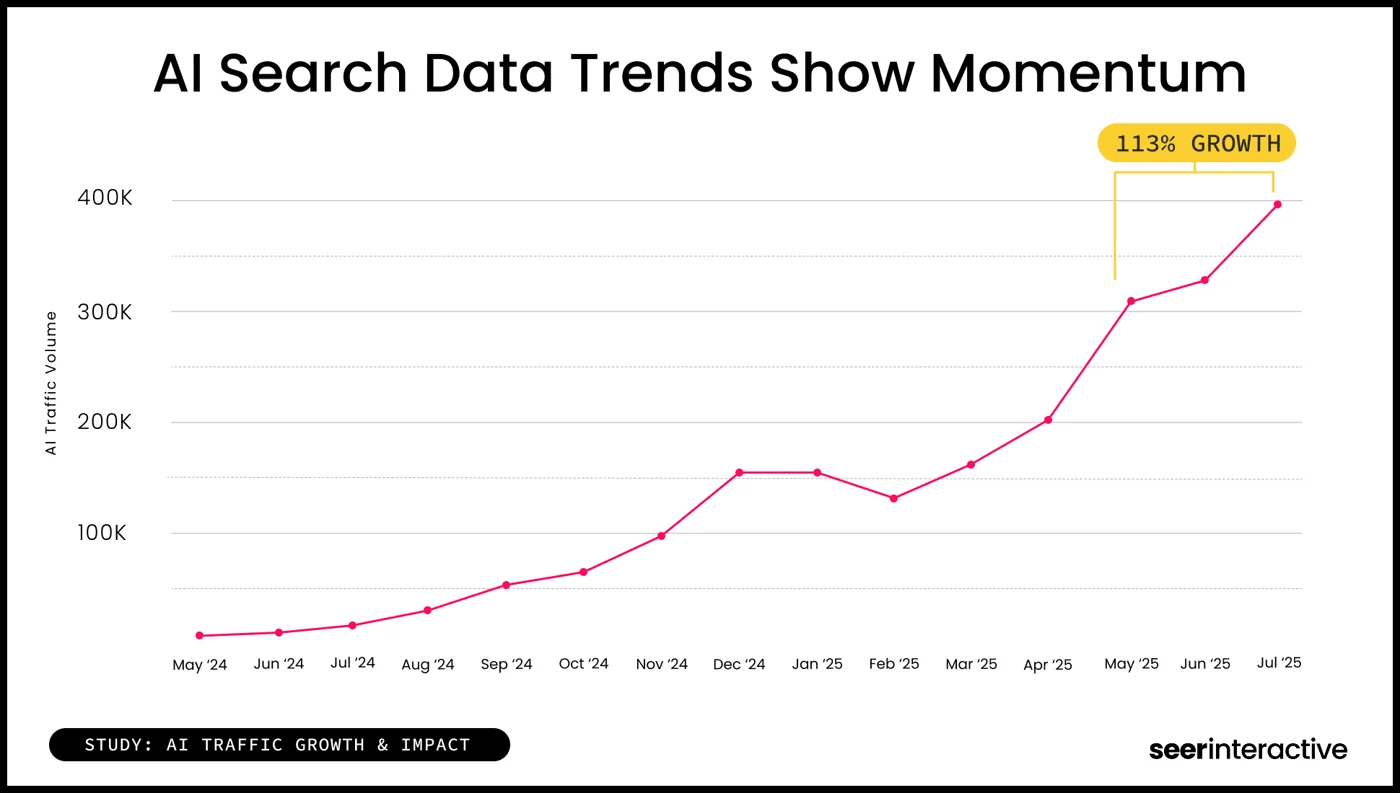
另一方面,Seer Interactive 的客戶資料也顯示,2025 年 5–7 月的 AI 導流相較此前三個月成長 113%。隨著生成式 AI 的普及,AI 已經全方位壓縮傳統點擊,同時正在形成新的、較高意圖的導流來源和路徑。
2.2 零點擊常態化
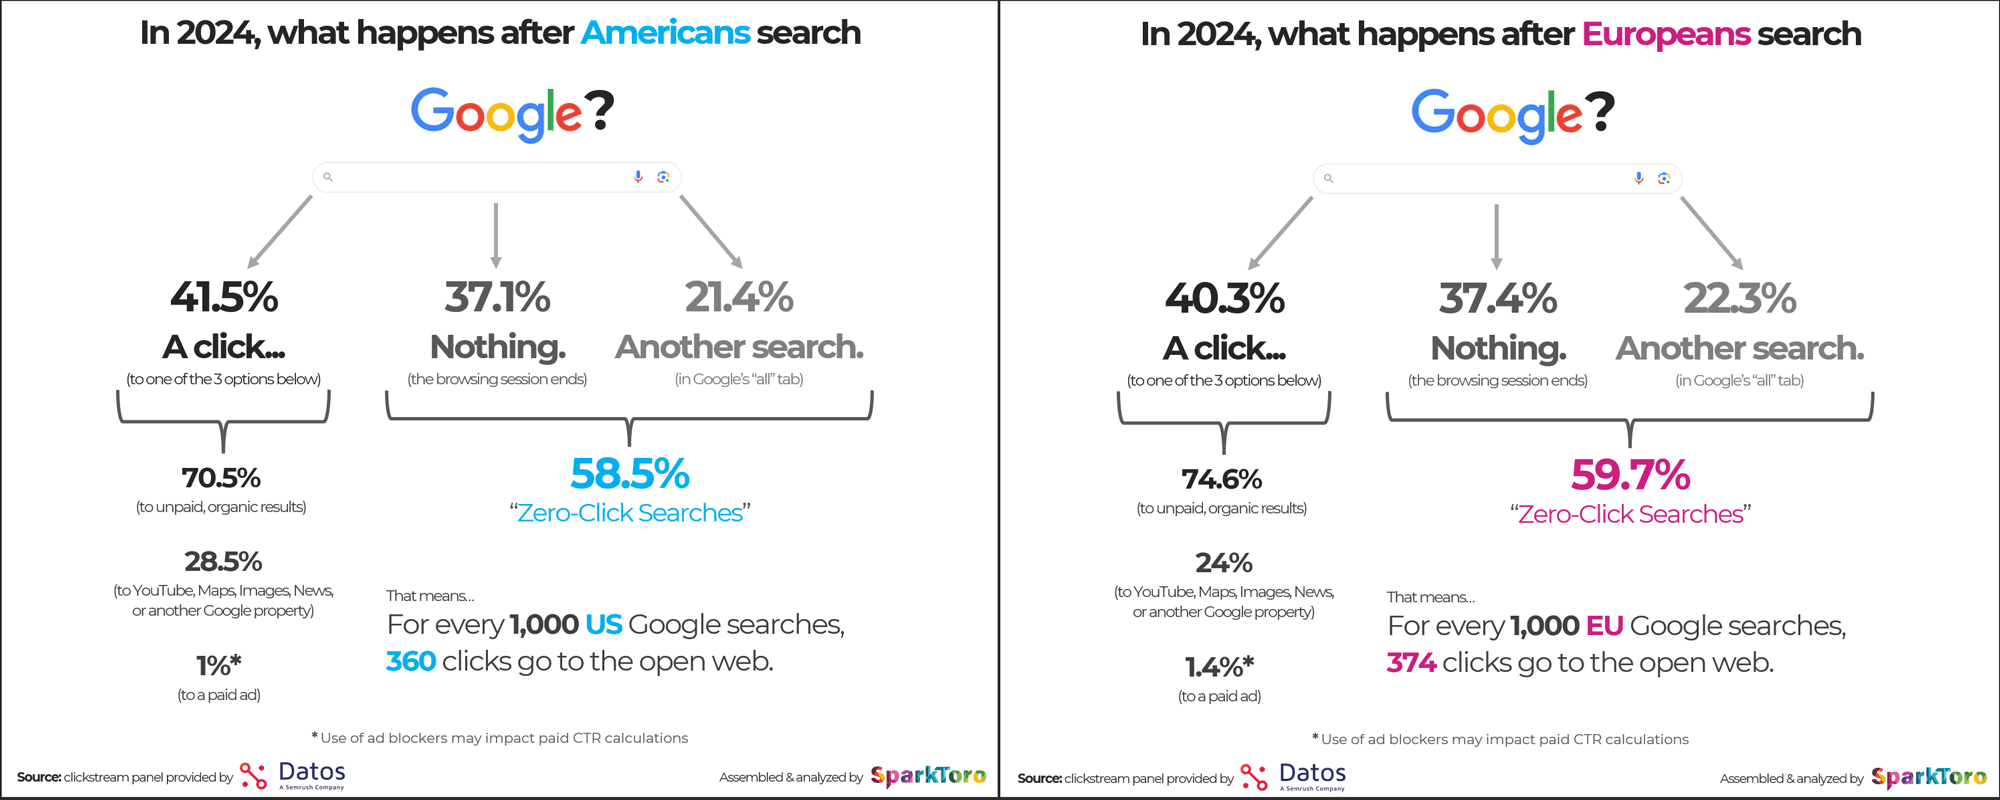
零點擊其實並非生成式 AI 出現後才出現的現象。過去 Google 早已透過知識圖譜、精選摘要等功能,讓使用者對資訊的需求能直接在 SERP 被滿足。
2024 年 SparkToro 與 Datos 的研究顯示,美國約有 58.5% 的 Google 搜尋沒有產生任何點擊,顯示在生成式 AI 衝擊搜尋路徑前,零點擊早已是一種現象。
不過雖然精選摘要截斷了搜尋意圖,但仍然會導流至藍色連結當中,人們依舊能使用行銷手段爭奪第 0 位;但當搜尋決策鏈從 SERP 轉向 AI 應用內部的 AI SERP 後,傳統的 SEO、SEM 等優化手段的價值或會受到衝擊與價值重估。
伴隨著 Google 於 2024 年 5 月在美國正式推出 AIO(AI Overviews),並於同年 10 月開始大規模向全球市場擴張,使「搜尋 → 點擊網站」不再是取得資訊的必要路徑
到了 2026 年,SparkToro 結合 Similarweb 資料更估計,美國 Google 搜尋的零點擊比例已升至 68.01%。這顯示人們在 AIO 普及後,更加依賴生成式 AI 提供的資訊,而非主動去深挖資訊來源。當使用者在 SERP 便獲取到了想要的資訊,進而直接結束搜尋意圖,於是促進了零點擊的成長曲線上升。
2.3 AI Overviews 與 AI 搜尋的路徑差異
生成式 AI 對傳統搜尋決策鏈的影響,除了搜尋結果頁內嵌的 AI Overviews,還有對話式 AI 搜尋的普及。
對話式 AI 搜尋讓使用者可以持續追問;傳統搜尋結果頁與對話介面因此有不同的站外點擊路徑。
AI Overviews:流量攔截
使用者依然在 Google 搜尋,但可能直接在摘要取得答案。
AI 搜尋:入口替代
使用者直接在對話介面提問,搜尋引擎不再是唯一的起點。
Shi、Zhu 與 Gu(2026)實際分析 ChatGPT Search 上線前後的行為,發現人們在與 ChatGPT 的對話中僅 5.2% 產生可辨識的站外推薦;同時,在人們取得 ChatGPT Search 權限後,對於傳統搜尋使用量平均下降了 9.4%,且 20 週後降幅更是估計擴大至 17.0%。
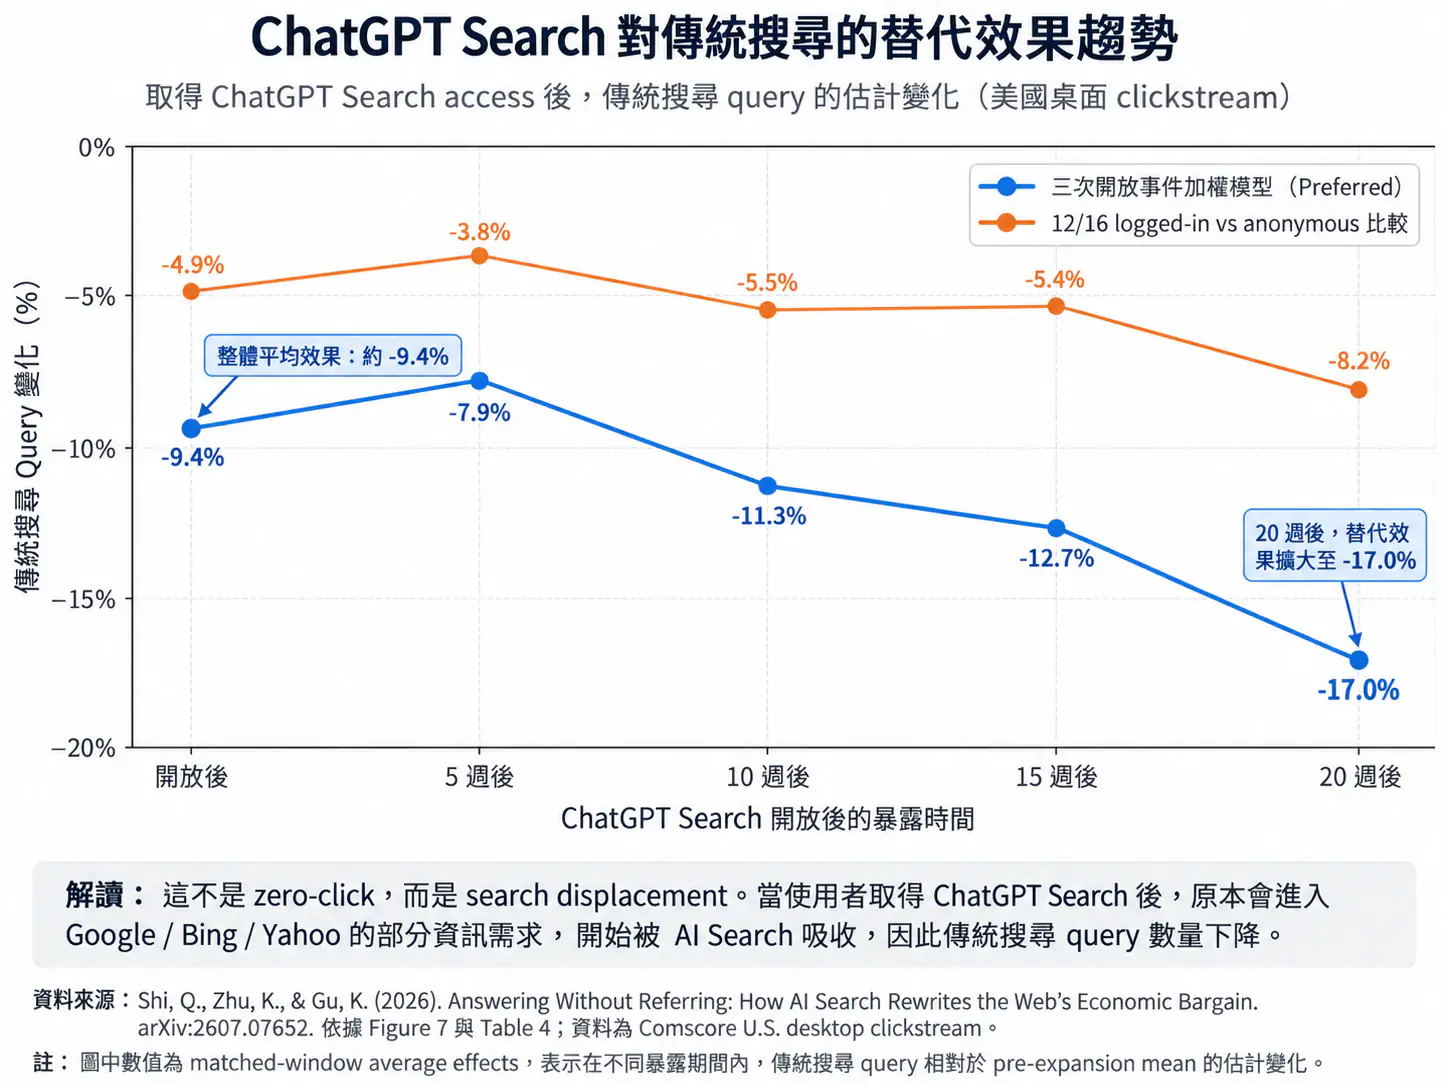
這些研究觀察的是不同平台、不同分母下的行為,不能據此推算使用者轉向 AI 搜尋的整體比例。
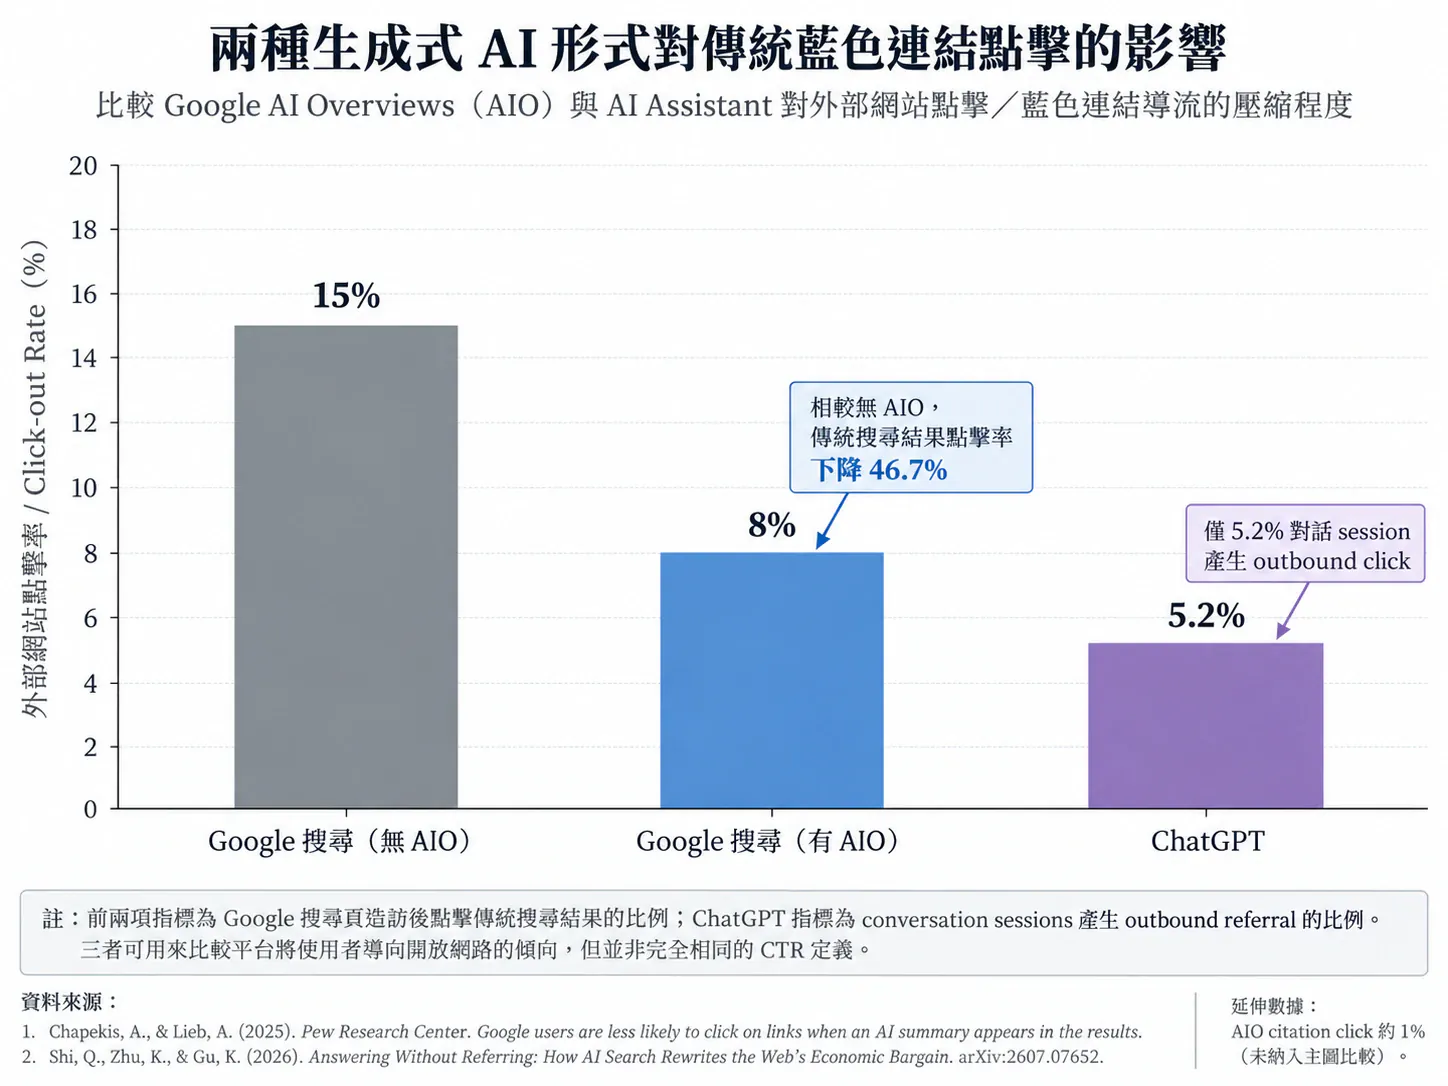
從搜尋意圖來看,AIO 是在既有搜尋版圖內進行「流量攔截(Traffic Interception)」,而 AI 應用則是更根本的「入口替代(Substitution Effect)」。
2.4 決策代理人化之影響預測
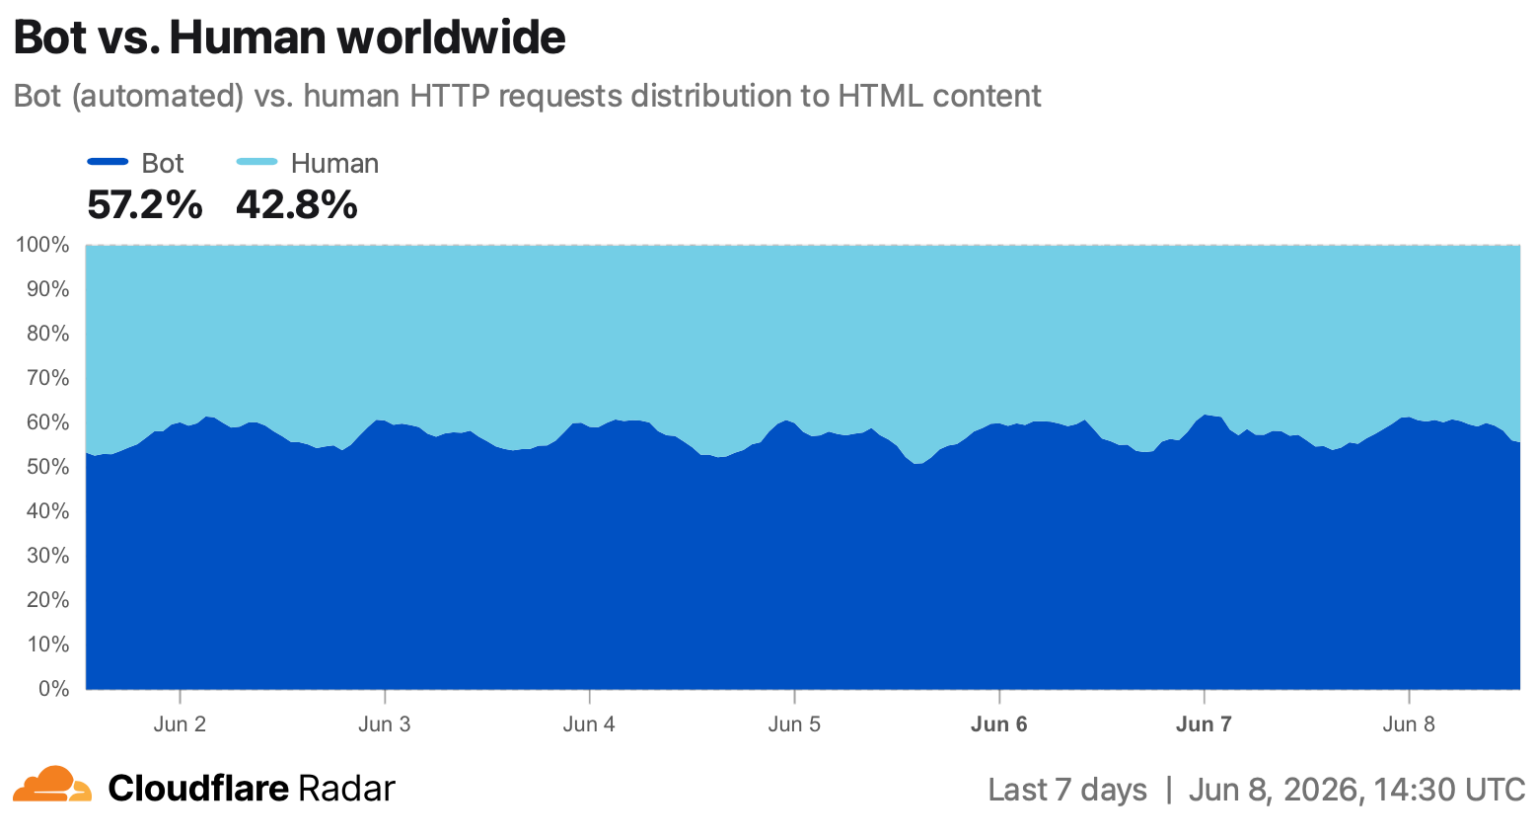
根據 CDN 服務商 Cloudflare 的 Radar 2026 年 6 月 8 日 HTML 請求圖表,Bot 占 57.2%、Human 占 42.8%,機器人請求已超過人類。Cloudflare 執行長 Matthew Prince 於 6 月 3 日指出,這是機器人流量首度超越人類。
伴隨著 AI Agent (AI 代理人)的技術逐漸完善,可預期的是人們將會把搜尋決策鏈更簡化為直接下達命令給代理人。屆時 AI 不再只是回答使用者的提問,而是會自主拆解複雜任務、跨平台調用工具、主動去造訪網頁。
HUMAN Security 2026 年的報告亦證實,由 AI 代理與代理式瀏覽器產生的網路流量年增率高達 7,851%,且高度集中於零售電商、影音媒體與旅遊住宿等具強交易屬性的產業。
未來「使用者是否親自造訪網站」與「品牌是否完成一次交易或聯絡」可能愈來愈分離,也迫使著企業與商家需重估網站的價值,因為對 AI 代理人來說,第一手資訊來源,意味著高信任的數位錨點。
當搜尋行為進一步演進,「決策代理人化」勢必會讓網站所扮演的角色出現變化。
三、AI 如何認識一家商家?官網的價值解析
前面的 2.4 節中有提到,隨著 AI 代理人的技術逐漸成熟,搜尋決策鏈很可能再度被簡化。因此,如何讓 AI 準確的引用到官方網站,甚至直接從中提取資訊作為答案的來源,便成為了重中之重。
3.1 AI 眼中的「數位實體」
在本文的分析框架中,一家餐廳不只對應一個 URL;名稱、地址、電話、菜單、評論、新聞與社群頁面等公開資訊,共同構成可供核對的「數位實體」。
Google Business Profile(GBP)的官方說明即指出,商家資訊可能來自公開網站、第三方授權資料、使用者內容、商家提供內容,以及 Google 與該地點互動後取得的資訊。
因此,沒有獨立官網不等於沒有可被 AI 使用的資料。對一間經營多年的老店而言,大量食記、媒體報導、地圖評論與社群貼文,本身就可能形成非常厚的數位足跡。
當 AI 在回答「台北有什麼老字號牛肉麵?」時,便可利用這些數位足跡完成實體辨識、特徵整理,並進一步給出資訊。
這也是「無官網商家仍會被 AI 提到」最重要的機制解釋:它們不是沒有資料,而是品牌資料分散在整個公開網路。
3.2 「數位錨點」的價值解析
前一節提到,一家店即使沒有官網,也能透過第三方聚合留下足夠多的數位足跡,讓 AI 辨識出數位實體。但這些資料畢竟分散在不同網站,菜單更新了,部落客必然不會去做修改;分店搬遷了,Google 評論裡仍可能留下舊地址。
商家可以更正部分平台資料,卻無法統一維護所有人的描述,這也會造成數位足跡的紊亂。因此,「網路上有這家店的資料」與「這家店有一份自己能持續維護的官方說明」仍然是兩回事。
LS-Labs 在本文將「官網」這種第一手資訊來源稱為「數位錨點」,指商家可自行更新、供外界核對資訊的官方節點。
官網的價值並非否定數位足跡的價值,也非保證 AI 一定會採用官方提供的資訊,而是讓品牌有一個可持續更新的錨點做來源。而這個錨點的用途,又可被分成三個面向。
品牌可以自行維護價格、分店、服務、菜單、FAQ、公告與品牌描述,讓公開網路上存在一個能被追溯的官方版本。至少品牌擁有一個可更新、可核對、可長期維護的第一方節點。
電話與地圖同樣能承接消費者,但官網可以進一步串接訂位、訂購、詢價、會員、CRM、分店選擇與其他自有流程。對多分店、複雜服務、需要留資或線上交易的品牌而言價值極高。
品牌可以透過清楚的頁面架構、LocalBusiness Schema、FAQ、產品資料與一致的實體命名,讓資訊更容易被搜尋系統解析;同時,也能把站內事件、來源與後續轉換串回分析系統。這讓品牌擁有更完整的「可讀、可管、可量」數位資產。
3.3 為何要分開量測提及、引用與資訊品質?
前兩節說明了第三方數位足跡能讓沒有確認官網的商家進入 AI 回答;官網則提供商家可維護的數位錨點。但如果只統計「店名出現幾次」,實際上無法去分辨當前 AI 眼中的商家到底是什麼樣子的。
AI 可能在某句回答中提到一家店時,引用食記的比例大過於官網;也可能雖列出了官網,但回答中附帶的地址或電話卻去採用第三方的過時來源。
這也是單一「GEO 分數」的侷限:它可以概括可見度,卻很難指出品牌是否有 AI 幻覺或是資訊來源的污染。
Semrush 2026 年針對多個 AI 搜尋介面的研究,也觀察到「引用」與「品牌提及」並不是同一事件:在其 3,981 次網域出現事件中,61.7% 為有來源連結但未提及品牌(幽靈引用),25.1% 為提及品牌但未附來源連結,只有 13.2% 同時出現品牌提及與來源連結。
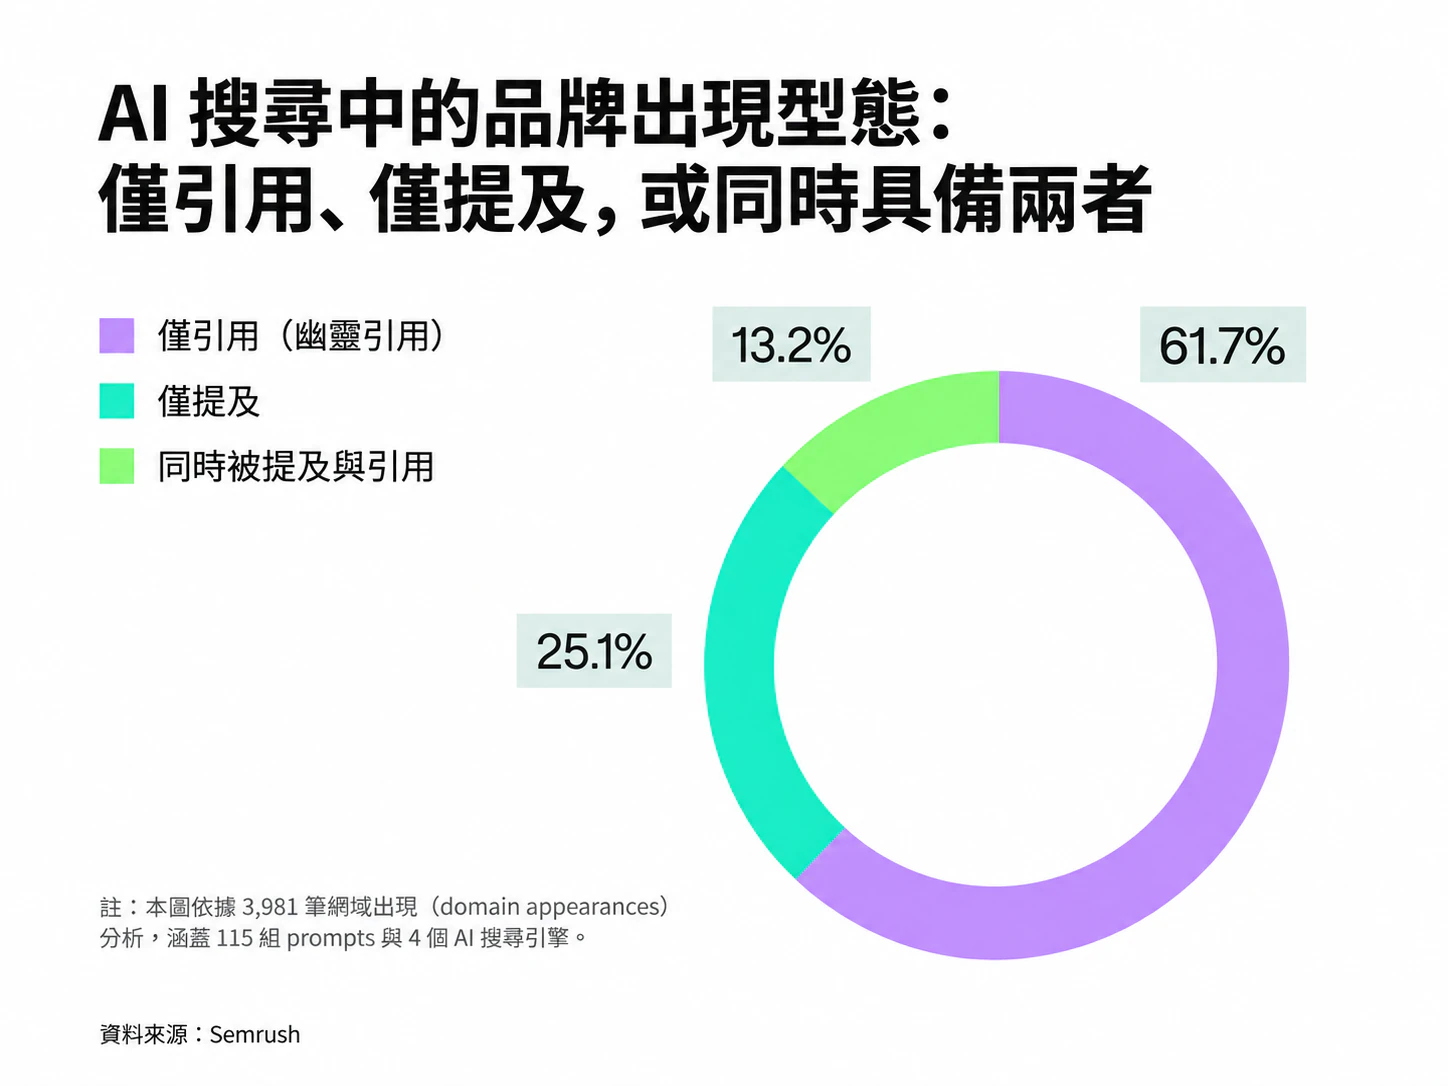
品牌被提及與網站被列為來源並非同一件事。
對本報告而言,更重要的是釐清:AI 到底有沒有提到商家?用了哪些來源?基本資訊是否與參照資料一致?回答是否提供了轉化路徑?
若這些資訊,最後都只被壓成一個單純的「GEO Score」,品牌其實很難知道下一步該做內容、做 PR、修資料,還是改善 CTR。
為此,LS-Labs 將這個問題拆成 MCAC 模型,作為自我檢測的框架。
四、LS-Labs 的 AI 搜尋量測框架:MCAC 模型
4.1 MCAC:分開檢查 AI 搜尋中的品牌表現
本研究以 MCAC(Mention、Citation、Accuracy、Conversion-readiness)作為操作性框架,分別觀察品牌提及、引用來源、資訊正確性與回答提供的行動入口。原始觀測將第四項記為 Actionability;公開框架改稱 Conversion-readiness 以對應 MCAC 縮寫,量測內容仍是回答提供的行動資訊。實際轉換仍需另行驗證。
這四項診斷在 GEO 主題頁以同一則餐廳回答示範,搭配本報告的樣本與方法,可以區分觀察到的現象與尚待驗證的改善假設。
Mention
是否在回答中被提及?在固定問題下,品牌是否進入 AI 回答正文與候選集合。
Citation
引用的來源為何?回答列出或使用哪些來源,來源由誰控制(第一方 vs 第三方)。
Accuracy
回答是否準確?可核對事實(地址、電話、價格等)是否與真值表一致。
Conversion-readiness
是否具備轉換路徑?回答是否能提供電話、網址、地址等能形成實際轉換的路徑。
表格可左右捲動,比較完整欄位
| 構面 | 本文定義 | 核心問題 | 對品牌的意義 |
|---|---|---|---|
| M — Mention | 在固定問題下,品牌是否出現在 AI 回答中 | 是否在回答中被提及? | 衡量候選能見度與被召回能力 |
| C — Citation | 回答列出或使用哪些來源,來源由誰控制 | 引用的來源為何? | 看第一方、平台與第三方聲量如何共同構成品牌敘事 |
| A — Accuracy | 可核對事實是否與品牌真值表一致 | 回答是否準確? | 找出地址、電話、分店、價格等資訊漂移 |
| C — Conversion-readiness | 回答是否能提供電話、網址、地址等能形成實際轉換的路徑 | 是否具備轉換路徑? | 衡量曝光能否被承接為聯絡、導航、訂位或交易 |
MCAC 的用途,在於讓檢查方向更具體:Mention 低,可檢查主題關聯;Citation 過度依賴第三方,可檢查第一方資訊是否可見;Accuracy 出錯,須核對資料;Conversion-readiness 弱,表示回答缺少可採取的下一步。
4.2 實測設計:六家台北牛肉麵店 × 四類問題
本研究於 2026 年 9 月 16 日,以台北市牛肉麵商家進行小型目的性抽樣。三家可確認自有官網,三家在本次查核中未確認獨立自有網域。
表格可左右捲動,比較完整欄位
| 分組 | 商家名稱 | 分組依據 |
|---|---|---|
| 有確認自有官網 | 洪師父冠軍牛肉麵-建北店、天下三絕麵食館、牛店精燉牛肉麵 | 可確認品牌控制的獨立網域或正式門市頁 |
| 未確認自有網域 | 林東芳牛肉麵、富宏牛肉麵、劉山東小吃店 | 本次查核僅確認 Google 商家、Facebook 或第三方頁面 |
實測方法
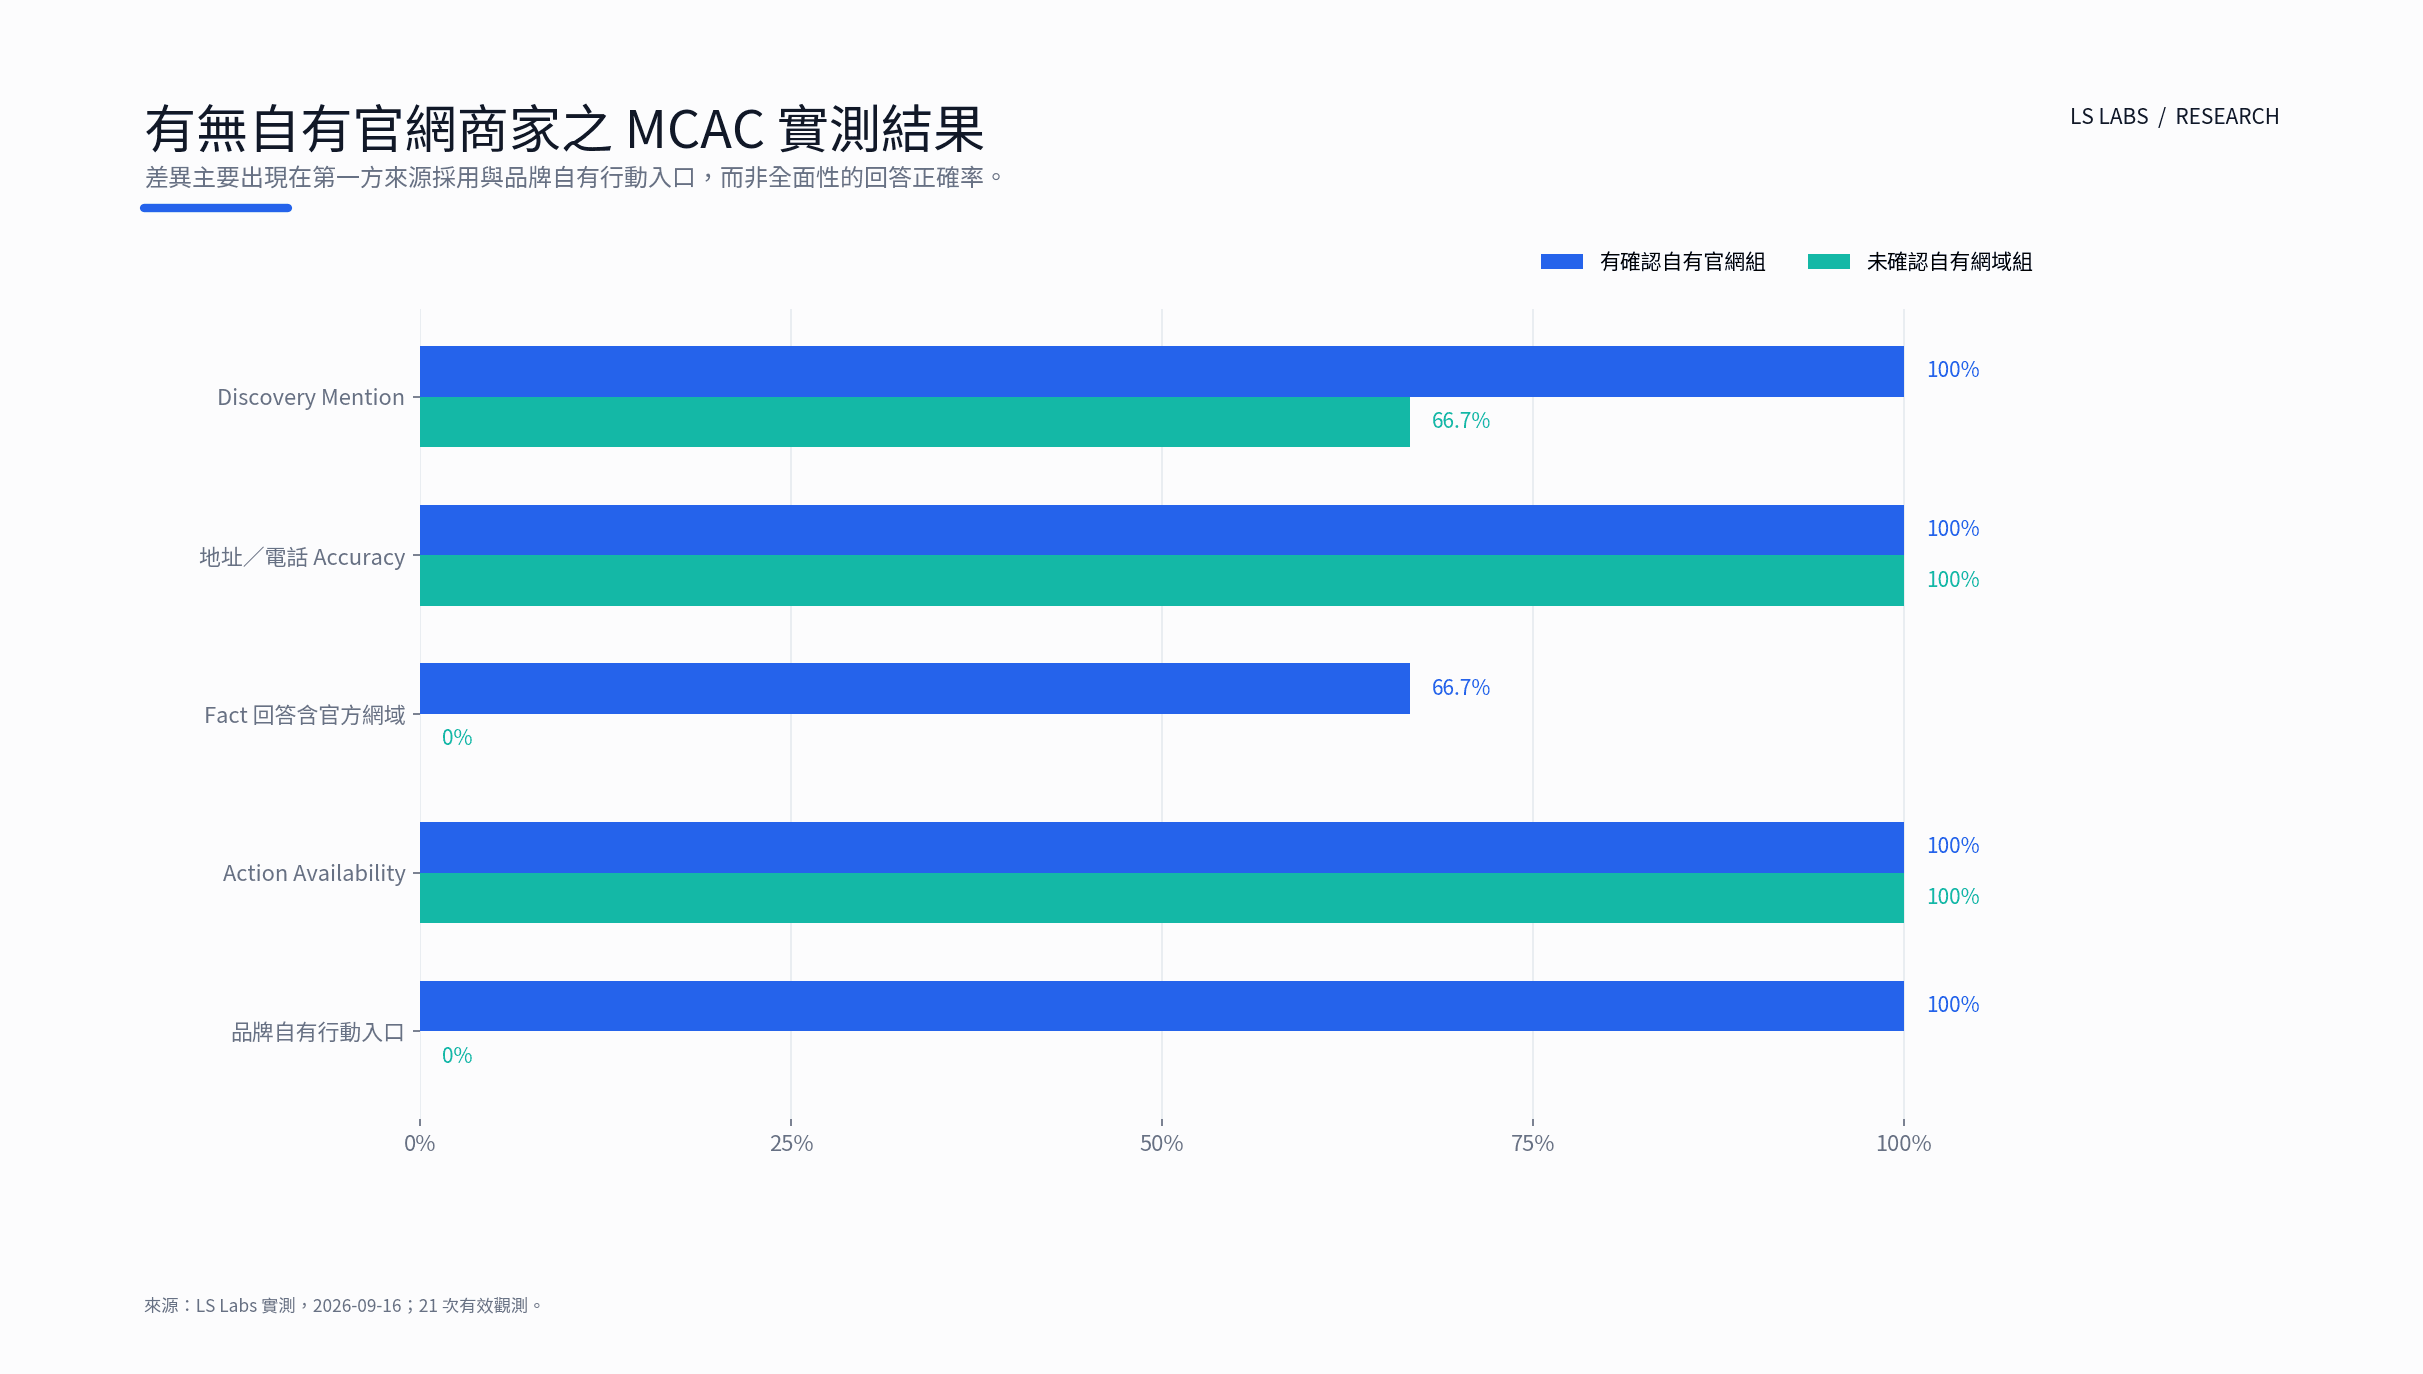
資料蒐集使用 Perplexity Sonar API,語境固定為台北、繁體中文,並保存回答、citations 與 search_results。原始共 24 次呼叫,其中 3 次因樣本重新分類於統計前排除,最終納入 21 次有效觀測:3 次 Discovery Query、6 次 Fact Query、6 次 Action Query,以及 6 次正反序 Comparison Query。
4.3 實測結果:官網能有效提供第一方數位錨點,不過並非壟斷 AI 能見度
| MCAC 觀測構面 | 有確認自有官網組 | 未確認自有網域組 | 行銷實務解讀 |
|---|---|---|---|
| Mention:Discovery 留存回答中的品牌出現 | 9/9品牌×執行紀錄 | 6/9品牌×執行紀錄 | 無官網商家仍能穩定進入部分推薦回答,官網不是被 AI 看見的必要條件 |
| Citation:Fact 回答來源清單含樣本官方網域 | 2/3 | 0/3 | 官網增加第一方來源進入回答的機會,但不保證每次被採用 |
| Accuracy:地址、電話與參照表一致 | 6/6 | 6/6 | 基本在地資訊可由多來源支撐,本輪兩組沒有出現差異 |
| Conversion-readiness:有基本行動資訊 | 3/3 | 3/3 | 電話、地址本身就能承接行動,沒有官網不等於沒有下一步 |
| Conversion-readiness:正文列出登錄官方網址 | 3/3 | 0/3 | 官網組多了一個可由品牌維護的第一方落點 |
這組實測結果最值得注意的是,不同 MCAC 構面在結果上帶來了完全不同視角的觀點解析。在能見度上,第三方足跡已經可以把沒有獨立官網的老店帶進回答;在基本事實上,兩組都能答對地址與電話;到了來源與落點,官網的價值才真正出現。
4.4 Citation 重析:AI 的來源池遠比品牌官網更分散
對 21 筆有效紀錄重新計數,共得到 408 個 citations 清單項目、206 個依原始 URL 字串去重的網址,以及 112 個移除 www. 後的主機名稱。三家樣本商家的登錄官方網域,在全體資料中共對應 6 個去重網址,占 206 個去重網址的 2.91%;若以 citations 清單項目計算,官方來源為 10/408,占 2.45%。
表格可左右捲動,比較完整欄位
| 題型 (Query Type) | 有效回答數 | citations 項目數 | 題型內去重網址 | 樣本官方網址項目 |
|---|---|---|---|---|
| Discovery(推薦題) | 3 | 60 | 20 | 0 |
| Fact(事實題) | 6 | 116 | 114 | 2 |
| Action(行動題) | 6 | 119 | 118 | 6 |
| Comparison(比較題) | 6 | 113 | 111 | 2 |
| 全體合計 | 21 | 408 | 206 | 10 |
這個結果不應被讀成「AI 只信任官網 2.91%」,因為來源清單的出現次數不是信任權重;但它很清楚地呈現了一個搜尋現實:生成式搜尋的答案來源是多源的,品牌官網只是整個資訊生態的一部分。
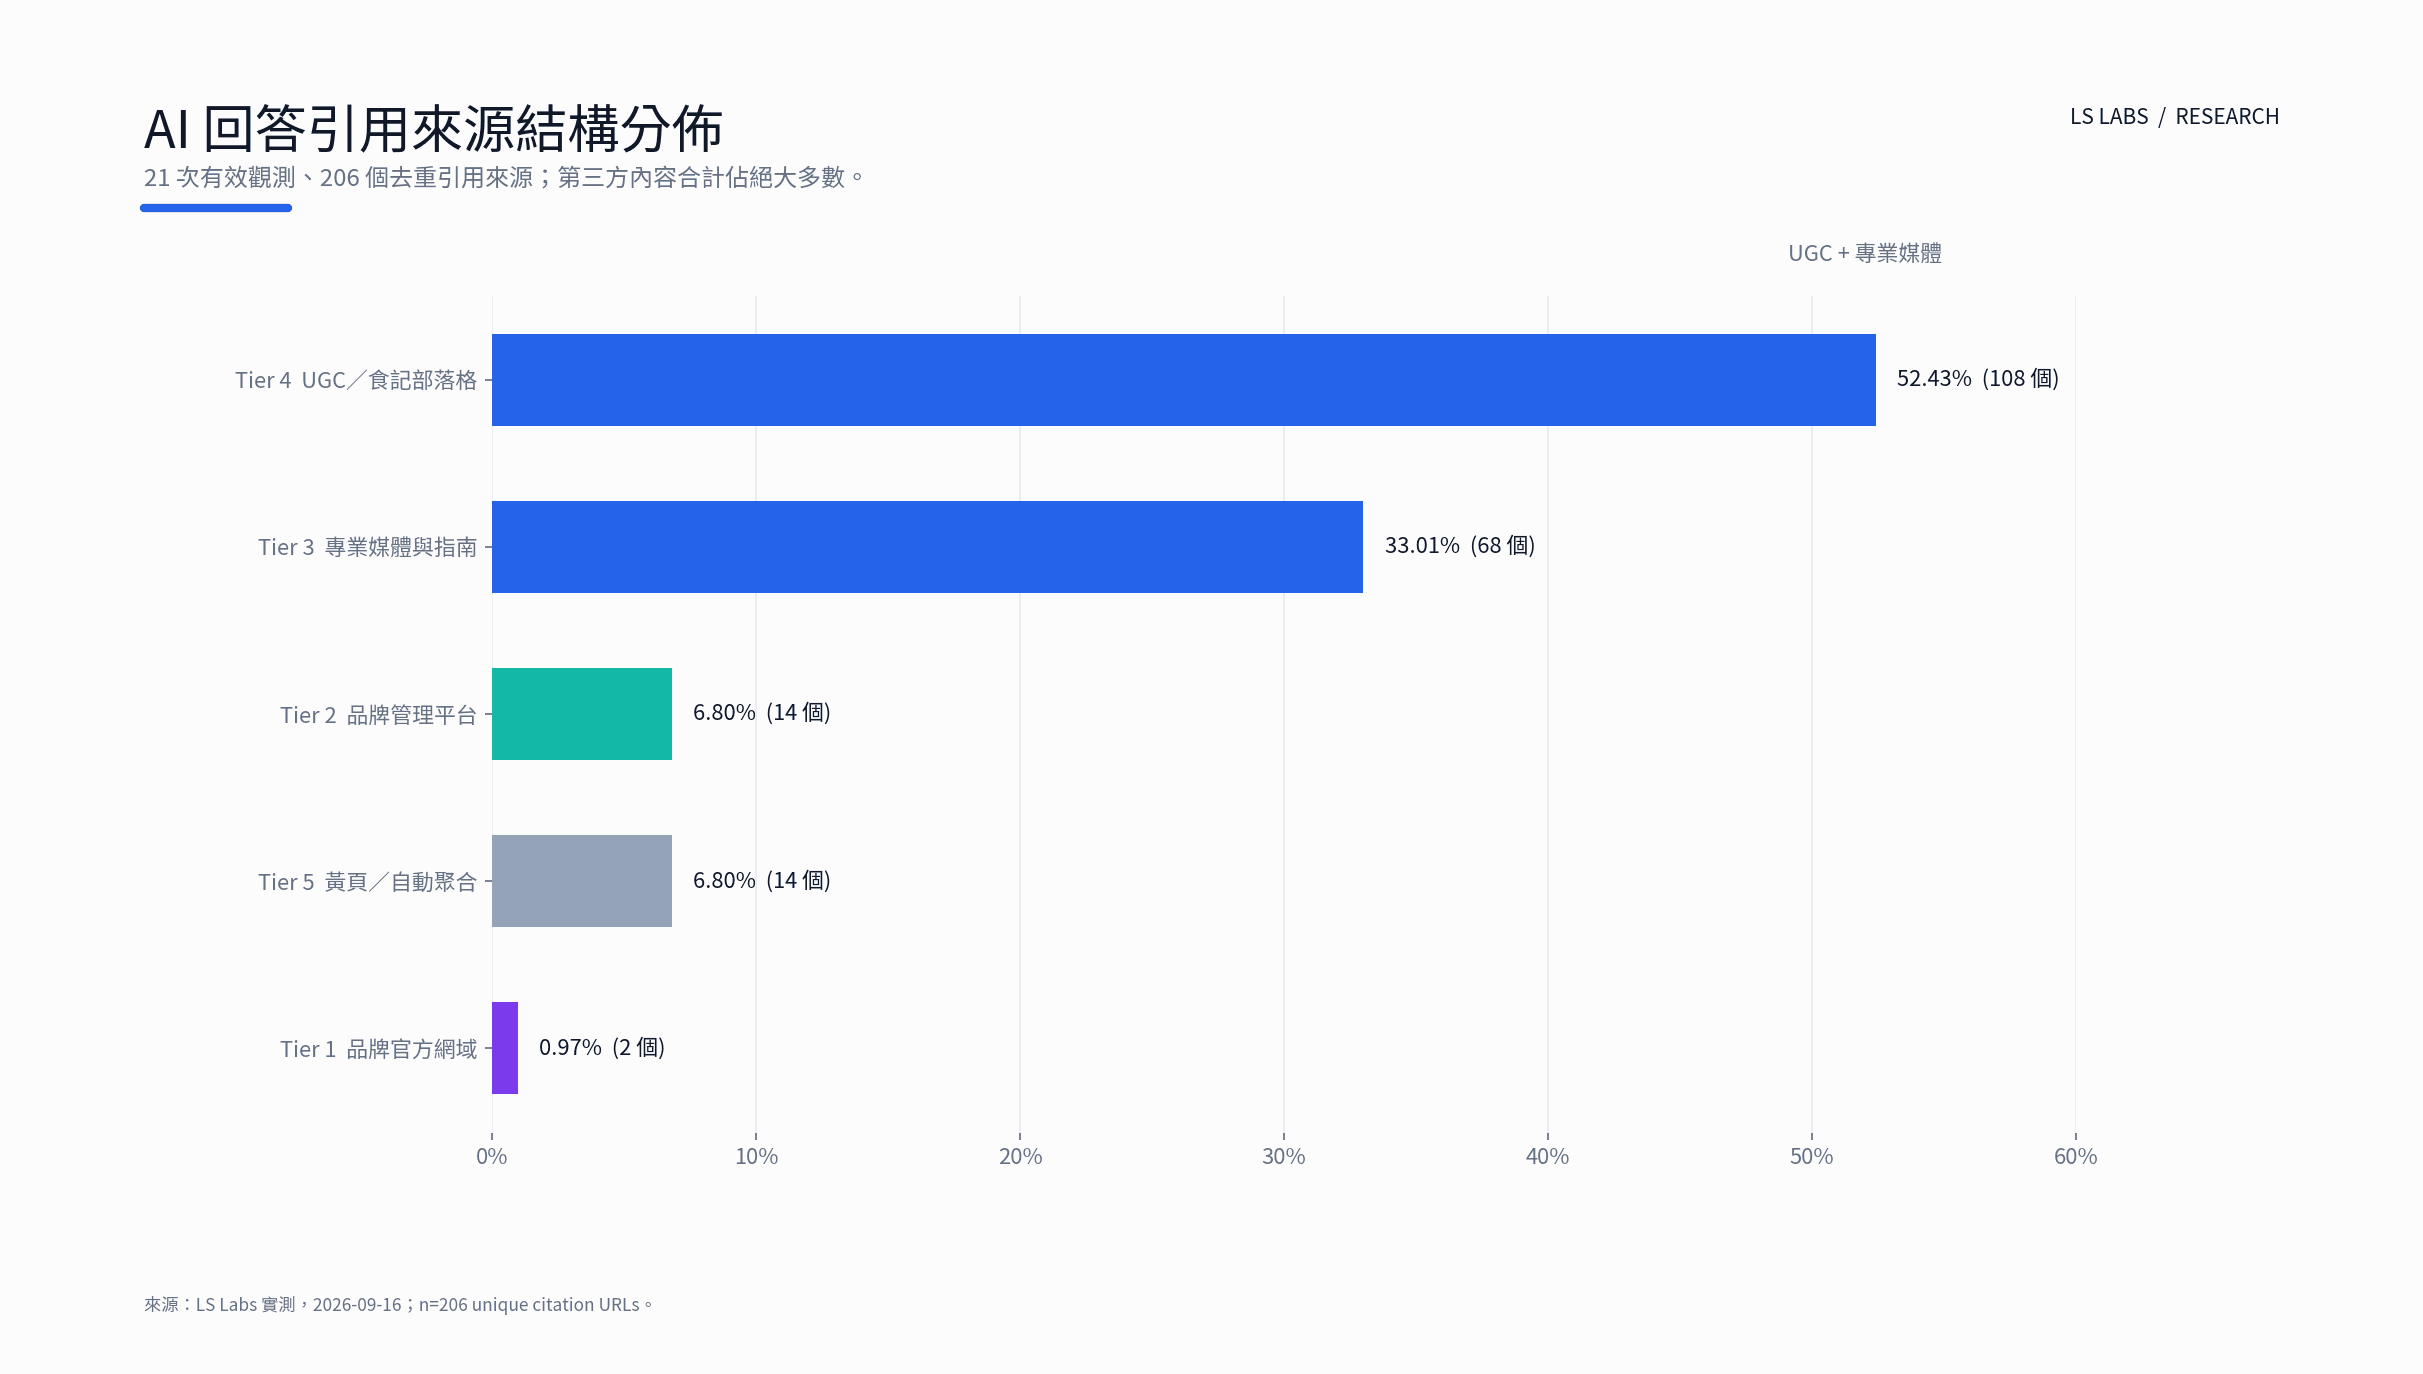
對品牌而言,這反而說明 GEO 不應只做站內 SEO。真正的 AI 可見度來自一個混合結構:第一方官網負責標準答案與承接,Google Business Profile 等可管理平台負責在地實體資訊,媒體與專業內容提供權威背書,UGC 與評論則補充口碑與情境語意。這些來源並非相互取代,反而是形成類似合作的關係,共同構築出 AI 眼中的品牌實體。
4.5 Comparison 壓力測試:MCAC 也能檢查量測本身
本輪雙店比較題出現一個很有價值的現象:正序與反序測試中,第一順位商家 6/6 都能取得地址與電話,第二順位則 0/6 完整;順序翻轉後,缺漏也跟著翻轉。
這個結果最大的價值,不是證明某一個模型「有位置偏誤」,而是提醒 GEO 量測不能只跑一次、只看一種 Prompt。若原始測試沒有做反序校準,很容易把「第一順位比較完整」誤讀成「有官網商家表現更好」。
對 MCAC 而言,這讓框架多了一層用途:它不只衡量品牌,也能檢查量測設計。未來實務上可透過重複執行、Prompt 順序平衡、跨模型觀測與時間序列,把一次性的 AI 回答轉成更穩定的品牌監測資料。
五、結論:AI 搜尋時代,單一面向的 GEO Score 可能造成量測偏差
本報告從「沒有官網的老店,為什麼還是能被 AI 推薦?」這樣一個看似矛盾的觀點出發,實際深入探究 AI 眼中品牌形象是如何被組成,最終得出「AI 認識的是商家在整個公開網路留下的實體訊號,也就是本研究所謂的 數位足跡」,Google 商家、媒體、食記、社群與評論,足以讓一個品牌被辨識、描述與推薦。
然而實測也發現,官網真正的價值在於塑造一個可持續更新的 數位錨點,讓品牌能在多源的搜尋環境當中,建立一個由第一方主動控制的資訊來源。它讓品牌擁有一個可維護的公開版本、一個可被引用的官方落點,以及一個能承接訂位、訂購、詢價、會員與其他商業流程的入口,並不能只從 能不能被 AI 推薦 這樣淺薄的理由忽視官網的價值。
對小型在地商家而言,如果主要需求只有名稱、地址、電話與現場來客,Google Business Profile、社群與第三方平台可能已經承擔大部分功能;但當品牌開始面對多分店、服務條件、內容敘事、訂位訂購、CRM、數據歸因與跨平台一致性時,官網的邊際價值會明顯提高。
在 206 個去重引用網址中,樣本商家的登錄官方網址有 6 個,占 2.91%。這個比例描述的是本次回答列出的來源構成,不是 AI 對官網的信任分數。品牌若只整理站內內容,仍無法處理分散在公開平台上的過時資訊與第三方描述;反過來說,只累積第三方聲量,也無法取代一份可持續維護的官方版本。
因此,本報告不把 GEO 壓成單一排名分數。反而提出 MCAC 框架分別檢查四件事:AI 有沒有提到品牌、根據哪些來源描述品牌、基本事實是否正確,以及回答有沒有提供可轉換的路徑。四者呈現的不同面向,正好對應行銷的四個價值。本次研究也顯示,商家出現在問題中的先後順序會影響資訊完整度;只測一次、只看店名有沒有出現,甚至可能把提問方式造成的差異誤判成品牌表現。
當搜尋從藍色連結走向生成式答案,真正值得被監測的,不只是曝光,而是品牌在答案形成前就具備足夠多的 正確資訊。同時,GEO 監測也不應只是告訴品牌「你有沒有被提到」,而應該持續回答品牌在 AI 決策鏈中的位置、來源、正確性與轉換能力,這也正是 LS-Labs 持續想要傳遞的價值。
最後,以上建議僅代表本次案例研究提出的決策方向,而非對所有商家建站效益的因果估計。
資料可用性與研究揭露
資料可用性:本頁提供研究方法、樣本範圍與統計結果。原始 API 紀錄、參照表與分析檔目前未公開提供下載,因此本頁不等於已提供可獨立重算的公開資料集。資料存取問題可透過聯絡入口詢問。
利益關係:作者同時參與 LS-Labs 的研究與工具開發,相關經驗可能影響研究問題、工具選擇與詮釋。現有研究紀錄未提供完整的外部贊助或資助聲明,不能據此宣稱沒有利益關係。
AI 協作:研究修訂紀錄載明使用 AI 協助文獻檢索、程式重算、證據比對與語言編輯。AI 輔助不代表來源已逐項人工查證,也不代表經過外部同儕審查。
學術預印本:本研究的學術版已於 2026-10-30 發布於 Zenodo,提供英文與繁體中文 PDF。引用格式:LI-Sheng(李昇)(2026)。Retrieval Mechanisms of Local Businesses in the Generative Search Era: Third-Party Footprints, First-Party Anchors, and the MCAC Empirical Evaluation Framework(預印本)。Zenodo。https://doi.org/10.5281/zenodo.23773956
參考文獻
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative engine optimization. Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining. https://arxiv.org/abs/2311.09735
- Chapekis, A., & Lieb, A. (2025). Google users are less likely to click on links when an AI summary appears in the results. Pew Research Center. 線上報告
- Fishkin, R. (2024). 2024 Zero-Click Search Study. SparkToro & Datos. SparkToro 報告
- Fishkin, R. (2026). In 2026, less than one third of Google searches still send a click. SparkToro / Similarweb. SparkToro 2026 分析
- Gao, T., Yen, H., Yu, J., & Chen, D. (2023). Enabling large language models to generate text with citations. EMNLP 2023. https://arxiv.org/abs/2305.14627
- Google. (n.d.). AI features and your website. Google Search Central. 查閱日:2026-09-26. 官方說明
- Google. (n.d.). Google’s guide to optimizing for generative AI features on Google Search. Google Search Central. 查閱日:2026-09-17. 官方指南
- Google. (n.d.). Grounding with Google Maps. Google AI for Developers. 查閱日:2026-09-26. 開發者文件
- Google. (n.d.). Local business structured data. Google Search Central. 查閱日:2026-09-17. Schema 規範
- Google. (n.d.). Understand how Google sources & uses info in Business Profiles & local search results. Google Business Profile Help. 查閱日:2026-09-26. 說明中心
- HUMAN Security. (2026). 2026 State of AI Traffic & Cyberthreat Benchmark Report. HUMAN Security 白皮書
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Liu, N. F., Zhang, T., & Liang, P. (2023). Evaluating Verifiability in Generative Search Engines. Findings of EMNLP 2023. https://arxiv.org/abs/2304.09848
- Loktionova, M. (2026). Why 62% of AI citations don’t lead to brand mentions [Study]. Semrush. Semrush 研究
- McDonald, T., Scharf, A., & Williams, M. (2025). The AI search landscape, beyond the SEO vs GEO hype. Seer Interactive. Seer 研究分析
- Murphy, R. (2026). Local Consumer Review Survey 2026. BrightLocal. BrightLocal 調查
- OpenAI. (n.d.). Searching the web with ChatGPT. 查閱日:2026-09-17. OpenAI 發布說明
- Perplexity. (n.d.). Create Chat Completion — Sonar API. 查閱日:2026-09-26. API 文件
- Schulte, J., Bleeker, M., & Kaufmann, P. (2026). Don’t Measure Once: Measuring Visibility in AI Search (GEO). arXiv preprint. https://arxiv.org/abs/2604.07585
- Shi, Q., Zhu, K., & Gu, K. (2026). Answering Without Referring: How AI Search Rewrites the Web’s Economic Bargain. arXiv preprint. https://arxiv.org/abs/2607.07652
- Wang, S. T., Gleason, J., Bart, Y., Wilson, C., & Metaxa, D. (2026). AI in Search Reduces Publisher Referrals Without Improving User Experience: Experimental Evidence. arXiv preprint. https://arxiv.org/abs/2603.14589
- 財團法人台灣網路資訊中心(2025)。2025 台灣網路報告。https://report.twnic.tw/2025/