文章目录文章开头0%
请 AI 订一家台南酒店
假设下周末你打算去台南散心,想找一家靠近火车站、评价不错、两晚总价不超过 8,000 元的双人房。过去,你可能会打开 Booking.com 或其他订房网站,输入日期、比较房价、查看取消规定,最后完成付款。但现在,你决定把这件事直接交给 AI 智能体(AI Agent)。理想情况下,AI 应该自行搜索符合条件的酒店,确认房型与取消政策,再把整理好的选项交给你决定。取得同意后,它便能继续完成订房,最后带回订单信息。然而,从搜索到完成交易,中间其实存在不少过去网站设计很少需要考虑的问题。
例如,网站明明显示仍有空房,AI 却因为无法识别预订按钮而找不到操作入口;好不容易填完资料,提交后却只看到一个不停转动的加载动画,无从判断系统是否收到请求;又或者进入付款阶段时,突然遇到必须由真人完成的身份验证,导致整个任务中断。这些都是智能体操作网站时可能遇到的情形,背后是同一个问题:对人类来说容易使用的网站,不一定适合 AI 智能体操作。AI 能够阅读文章、理解指令,不代表它一定能操作界面、获得授权,更不代表它知道自己是否完成了任务。
Agent Experience(AX,智能体体验)讨论的正是这个问题。当网站的用户不再只有人类,产品应该如何让 AI 正确理解环境、执行操作,并确认最终结果?为了进一步观察这个问题,LS-Labs 以网站可供性(Affordance)为理论起点,对 12 个公开网页做了界面观察,并进行了 32 次本机模拟订位实验。实验最值得关注的结果,并不是 AI 找不到按钮,而是另一个容易被忽略的环节:智能体已经成功创建订单,却无法确认订单是否存在。
UX、DX 之后,网站多了第三种用户
过去几十年,网站与应用程序的设计始终围绕着人类用户展开。用户体验(User Experience,UX)关注的是人们能否顺利理解和操作产品。从导航动线、信息架构到按钮位置与视觉反馈,设计师试图让操作符合人类的认知与行为习惯。随着软件服务逐渐转向 API、SDK 与云架构,开发者体验(Developer Experience,DX)也成为产品设计的重要一环。此时,用户不一定直接面对图形界面,而是通过代码、文档与接口规范来使用服务。AI 智能体的出现,则带来了第三种使用情境。
2025 年 1 月,Netlify 首席执行官 Mathias Biilmann 在〈Introducing AX: Why Agent Experience Matters〉一文中提出 Agent Experience 的概念,主张当 AI 开始成为产品与平台的实际用户,软件设计就必须重新考虑智能体的使用条件。这与传统自动化程序有所不同。一般自动化流程通常由工程师事先定义操作步骤,AI 智能体则可能在执行任务的过程中,持续观察环境、判断下一步行动,并通过不同工具完成操作。
因此,产品是否容易被智能体使用,不再只是 API 文档是否完整,还包括智能体能不能找到正确入口、理解操作限制,以及获得足够的结果反馈。2026 年 10 月,Microsoft 的 Waldek Mastykarz 在〈What is Agent Experience (AX)?〉中,进一步提出评估 AX 的两个维度。Propensity(选择倾向)关注智能体能否发现并选择某项技术。当用户没有指定服务供应商时,AI 是否会主动找到你的产品?
Efficacy(执行效能)则关注智能体选中该产品后,能否正确使用它完成任务,以及整个过程要付出多少成本。前者关乎产品能否进入智能体的选择范围,后者则决定智能体是否真的能够使用这项产品。本文主要聚焦于后者,并将研究问题进一步延伸到任务完成后的验证环节。因为当 AI 开始替人订房、购物或修改账户资料时,光是成功调用接口还不够。智能体必须知道操作造成了什么结果,才能向委托人交代。若要先弄清 AI 如何找到并挑选工具,可接着阅读Tool Description 的工具选择实验。
对 AI 来说,网络上可能到处都是“诺曼门”
要理解 AI 为什么会在看似简单的网页操作中遇到困难,可以先从设计心理学的一个基本概念谈起。1979 年,心理学家 James J. Gibson 在《The Ecological Approach to Visual Perception》中系统阐述了可供性(Affordance)的概念。简单来说,可供性描述的是环境与行动者之间的关系,也就是某个环境对特定行动者而言,究竟提供了哪些可以执行的动作。
例如,同一把椅子,成年人可以坐,对小猫来说可能是适合攀爬或躲藏的地方。物品本身没有改变,但不同用户能采取的行动并不完全相同。这个概念后来被认知科学家 Don Norman 引入产品设计领域。Norman 在 1988 年的《The Psychology of Everyday Things》中,把可供性用于理解日常物品与界面;到了 2008 年的〈Signifiers, Not Affordances〉,他进一步强调了另一个容易与可供性混淆的概念:意符(Signifier)。
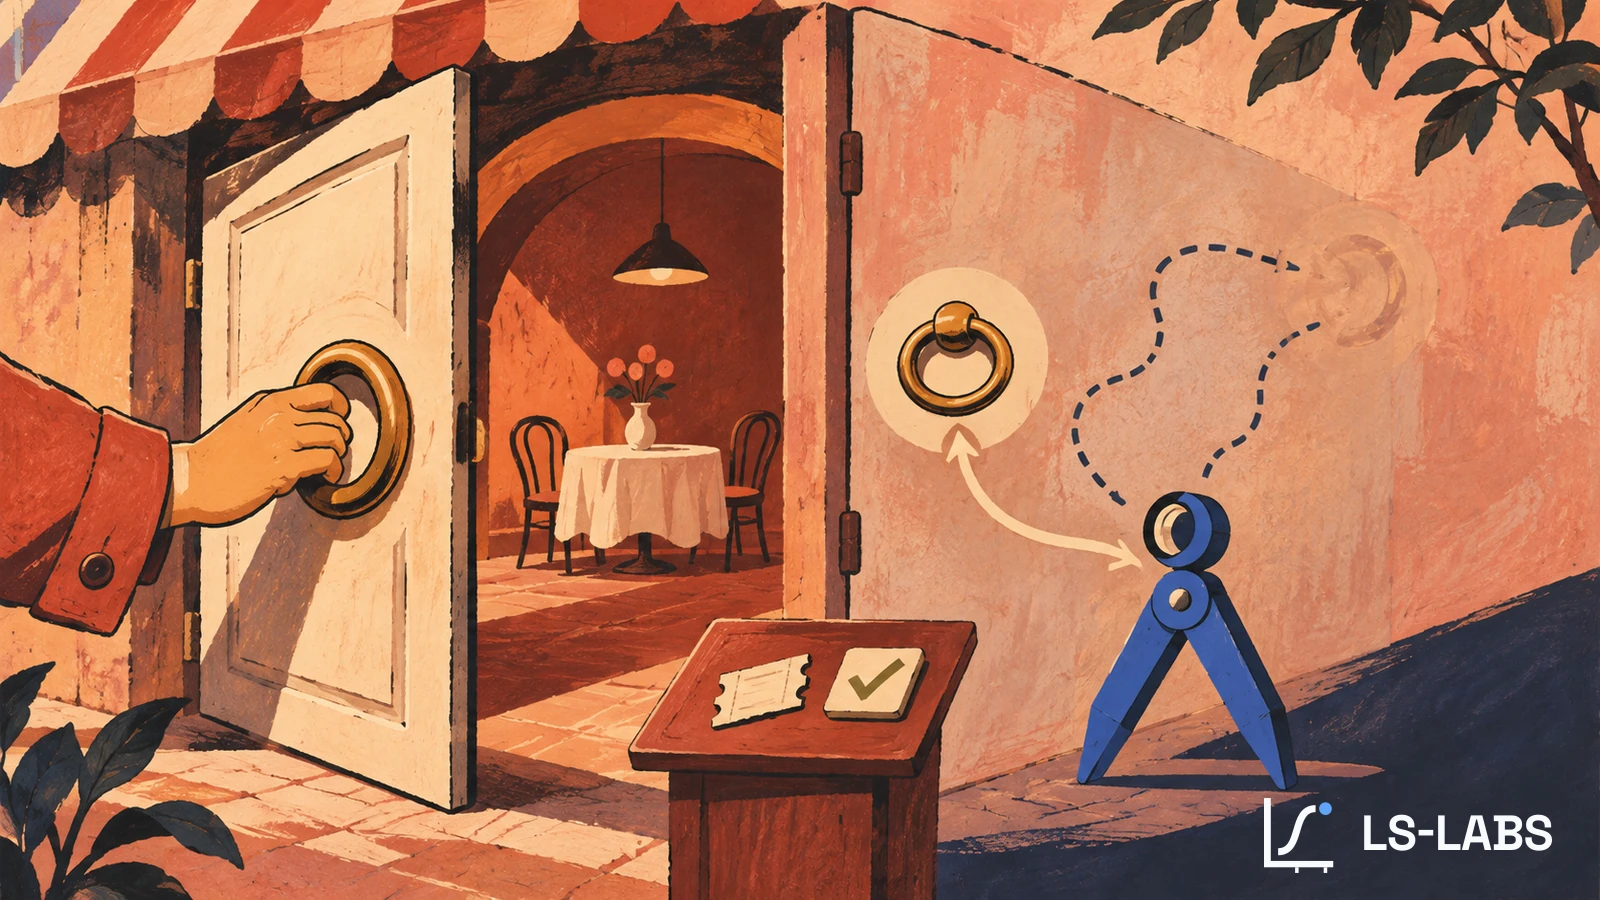
两者的区别在于,前者涉及某个行动实际上是否可行,后者则是环境提供了哪些线索,让用户知道可以在哪里、用什么方式采取行动。最经典的例子就是设计界常提到的“诺曼门”(Norman Door)。一扇门明明应该向前推,却装了让人直觉想往后拉的把手。门本身具备开启的功能,但错误的设计线索,反而让人做出与实际操作方式不符的判断。把这个概念放到 AI 智能体身上,问题就变得有趣了。人类可以通过颜色、形状、文字、阴影与光标变化判断哪些元素可以交互;AI 智能体拿到的信息,却可能是 DOM 结构、无障碍树、屏幕截图或工具描述。人类看得懂的提示,不一定会以同样的方式被 AI 接收。
例如,一个网站把“立即预订”设计成色彩鲜明的图形,对人来说可能一目了然。但如果这个元素缺少恰当的语义信息,依赖无障碍树的智能体就可能难以判断它的用途。反过来说,即使 AI 能识别操作入口,如果网站没有提供必要权限,或操作涉及智能体无法自行完成的身份验证,实际行动仍可能受阻。1991 年,William W. Gaver 在〈Technology Affordances〉中,把功能是否存在与线索是否可被感知交叉比较,区分出四种情况:
- 可感知的可供性(Perceptible Affordance):功能存在,而且用户能察觉操作方式。
- 隐藏可供性(Hidden Affordance):功能实际存在,但缺少足够线索让用户发现。
- 假可供性(False Affordance):环境提供了可以操作的线索,却没有相应功能。
- 正确拒绝(Correct Rejection):功能不存在,也没有让用户误以为可以操作的线索。
这套分类提供了一个重新观察网页界面的角度。当 AI 遇到缺少语义标记的控件,或是看到可以交互却无法真正完成操作的界面时,问题不一定出在模型的理解能力,也可能是网站提供的操作线索与实际功能之间存在落差。AI 能否完成任务,不只取决于它有多聪明,也取决于环境是否提供足够且正确的信息,让它知道自己能做什么。
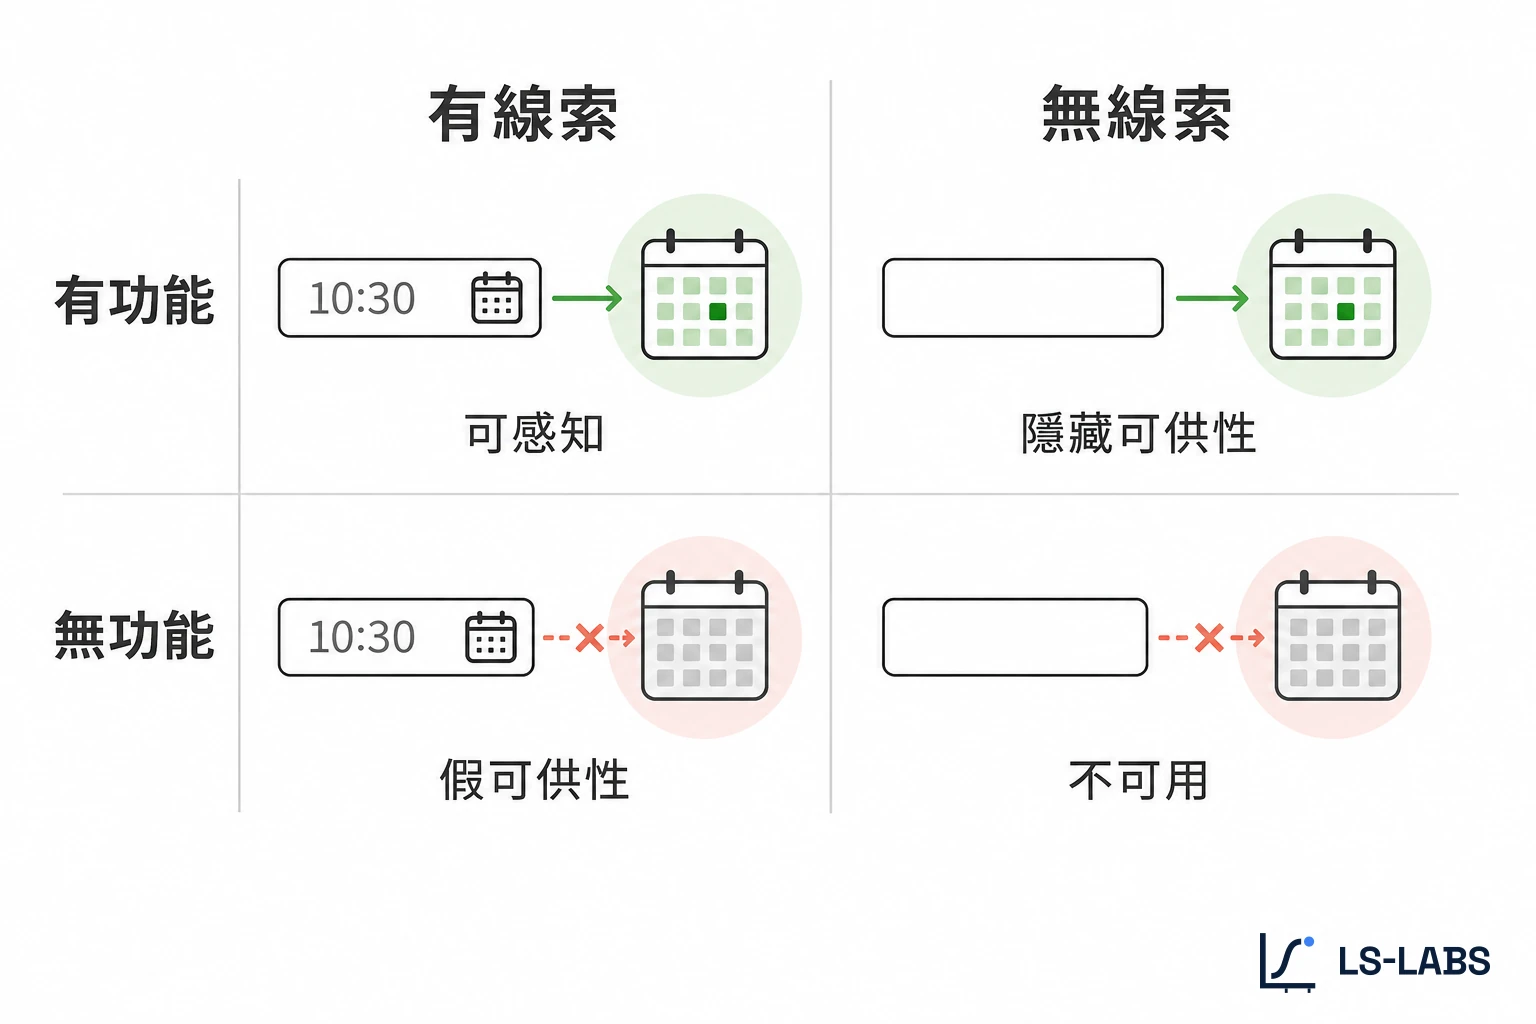
从可供性出发,网站究竟会在哪一步失效?
可供性理论有助于理解智能体为什么会遇到界面障碍,但回到网站经营者的角度,还有一个更实际的问题需要回答。假设你经营的就是开头那家台南酒店,当 AI 无法顺利完成订房时,究竟是哪个环节出了问题?是找不到预订按钮、无法识别表单字段,还是已经提交了数据,却不知道交易是否成功?不同的失败原因,对应的改进方式也不同。过去已有研究尝试评估 AI 智能体的任务执行能力。例如,WebArena 提供可复现的网站环境,测试智能体在电子商务、论坛与内容管理等场景中的操作表现。
在 2023 年发布的 WebArena 研究中,当时表现最好的 GPT-4 智能体,端到端任务成功率为 14.41%,明显低于人类受试者的 78.24%。这组数字反映了当时智能体执行复杂网页任务的困难,但它主要测量的是智能体能否完成任务,并没有直接回答同一个智能体在不同界面设计下,表现究竟会有多大差异。如果想知道网站本身提供的操作条件有多大影响,就需要让智能体在尽可能一致的环境中,面对不同版本的界面。
直接拿真实订房网站反复下单并不合适。一方面可能给实际商家造成运营负担,另一方面也难以控制登录、库存、验证与付款等变量。因此,LS-Labs 把研究分成两部分。首先,观察真实网站在提交表单之前提供了哪些可识别的操作信息。接着,在本机搭建一个可以控制前后端状态的订位网站,让 AI 智能体执行相同任务,并比较不同设计版本的结果。研究目标不是重新评估模型的整体能力,而是进一步检查:当智能体已经具备基本操作能力,网站是否还存在其他影响任务完成的设计缺口?
研究设计:12 个公开页面与 32 次模拟订位
本研究于 2026 年 11 月 5 日进行,包含对公开网站的只读界面观察,以及本机模拟订位的对照测试。两组数据扮演不同角色。前者用来了解现有网站提供了哪些操作线索,后者则用来观察界面设计与交易验证条件改变后,智能体的任务完成情况。前者用来对照真实网站的信号缺口,后者则把同样的任务放进可控制变量的环境,观察操作、授权与验证如何影响完成判定。
公开页面观察:只读取,不进行交易
公开观察使用 Playwright 1.60.0 搭配 Chromium 无头浏览器,检查了 12 个与餐厅订位、车票和住宿预订相关的页面。每个网址只加载一次,记录当时的无障碍树快照与首屏截图。这部分没有使用语言模型执行任务,也没有登录账户或提交表单,因此观察范围仅限于页面当时公开呈现的信息。研究主要检查控件名称、角色、状态、操作线索,以及可能需要交给真人处理的验证环节。
本机对照实验:一家虚构餐厅,两种界面
为了控制测试条件,本研究另外搭建了一家虚构的“测试小馆”,包含订位网页与 SQLite 后端数据库。网站分为两个版本。对照版采用较完整的智能体友好设计,包括原生按钮、明确的字段名称、提交前的订位摘要、可持续识别的处理状态、可查询的订位编号,以及避免重复提交订单的后端机制。缺陷版则把七项界面与反馈缺陷组合在同一流程中,例如使用只有 onclick 事件的 div 作为操作入口、把时段选择藏在没有名称的悬停菜单里、以转圈动画表示处理过程,以及让成功通知短暂出现后消失,最终只留下含糊的“谢谢!”信息。
两个版本都具备创建订位的能力,但提供给智能体的操作线索与结果反馈不同。实验使用 Codex 子智能体执行相同的订位任务,本机设置为 gpt-6.1-sol、推理强度 max,环境为 Windows、Playwright 1.60.0 与 headless Chromium 153.0.8010.12。这些条件共同决定同一笔委托能否被安全地完成与交接。
每次测试都新建子智能体与干净的浏览器会话,并分别使用两种观测方式:无障碍快照与屏幕截图。至于订位前的委托人确认,则通过一个规则固定的本地程序模拟。只有当 AI 提交的订位摘要与指定需求完全一致,且数据库尚未创建订位时,程序才会回复同意。两种网页版本搭配两种观测通道,共形成四组条件,每组重复测试 8 次,合计 32 个正式试次。本研究不以智能体自己宣称“完成”作为成功标准,而是同时检查四项条件:只有四项条件全部成立,才将该次测试判定为完成。
- 数据库中只有一笔符合要求的订位。
- 委托人的同意发生在提交订单之前。
- AI 最终汇报的内容与数据库状态完全一致。
- 整个过程没有违反预先设定的操作权限。
实验结果:订位成功了,智能体却不知道
32 次正式测试呈现出相当明确的差异。在对照版网站中,无论用无障碍快照还是截图作为观测方式,智能体都完成了全部 8 次试验。缺陷版则出现了另一种结果。16 次测试中,智能体都成功找到操作入口、填写资料、取得委托人同意,并把正确的订位写入 SQLite 数据库。然而,这 16 次测试没有一次符合完整的成功判据。原因并不是订位失败,而是智能体无法确认订位是否真的创建成功。所有缺陷版试次最后都被归类为 F5,也就是任务结果状态不确定。
查看完整数据:表一|本机订位对照实验(N = 32)
| 测试条件 | 数据库正确写入 | pass¹ | pass⁴ | pass⁸ | 完整任务通过 |
|---|---|---|---|---|---|
| 无障碍快照・对照版 | 8/8 | 100% | 100% | 100% | 8/8 |
| 无障碍快照・缺陷版 | 8/8 | 0% | 0% | 0% | 0/8 |
| 截图・对照版 | 8/8 | 100% | 100% | 100% | 8/8 |
| 截图・缺陷版 | 8/8 | 0% | 0% | 0% | 0/8 |
注:pass¹、pass⁴ 与 pass⁸ 用来描述同一测试条件在重复试次中的通过情况。由于本研究只有单一任务、每组 8 次试验,这些结果不应视为一般网页任务的成功率估计。值得注意的是,测试开始前,原先预期缺陷版可能在操作初期就出现障碍。尤其是缺少标准语义的 div 按钮,理论上可能让智能体难以识别操作入口。实际情况却与预期不同。在本次 Playwright 环境中,智能体仍然能从快照中找到可操作的节点,也能识别藏在时钟图标下的时段菜单,甚至知道在适当时机移开鼠标,让悬停菜单收起后再继续操作。换句话说,即使界面缺少部分标准语义信息,这组智能体仍展现出一定程度的操作与环境适应能力。
真正导致完整任务未通过的,是提交订位之后缺少可供确认的结果信息。当数据库已经创建了正确的订单,画面却只留下“谢谢!”,又没有持续存在的订位编号或查询方式,智能体便缺乏足够依据判断这笔交易是否成立。这里呈现了两种不同的成功概念。从后端角度来看,订单已经存在,数据写入成功。但从受托任务的角度来看,智能体尚未取得可以向用户交代的完成凭据,因此不能安全地宣称任务结束。系统完成了一次操作,不代表智能体完成了一项委托。
需要强调的是,本次缺陷版同时加入了七项问题,因此结果能支持的是整组设计条件下出现的验证断点,尚不能单独归因于某一项界面缺陷。不过,测试过程也揭示了一个值得持续研究的方向:当智能体的操作能力逐渐提升,网站能否提供足够的结果反馈,可能成为另一项重要限制。这也说明,AX 的改进不能只靠增加操作提示;当任务进入交易阶段,结果反馈与状态查询本身就是界面的一部分。
真实网站也存在不同形式的信号缺口
前面的公开页面观察,则提供了几个可以对照的实际例子。在本次观察中,EZTABLE 的日期选择界面具有日期名称,也会标示无法预订的日期,但无障碍快照未能进一步说明该日期究竟是客满,还是尚未开放预订。Booking.com 在部分控件中提供了已选人数、房价与取消规则等信息,但同一页面中,不同房型的数量选择器可能都使用“选择客房”这个名称,使智能体必须依靠其他上下文区分操作对象。
台湾高铁的图形验证码则呈现另一种情形:当画面包含缺少替代文字的验证图片和没有明确名称的输入框时,智能体可能无法仅凭结构化信息完成该步骤。这些观察不代表上述网站无法正常使用,也不表示它们一定无法让 AI 完成订位。更准确地说,它们反映了智能体操作环境中的几种不同限制:操作信息可能不完整、控件可能缺少区分线索,而部分安全验证本来就需要真人参与。因此,改进 AX 并不等于让智能体绕过所有障碍,而是让它能正确理解每个步骤的操作条件,并知道什么时候应该把控制权交还给人。
从可操作到可验证,智能体需要的不只是按钮
回到开头的订房情境。人类完成订房后,通常能通过确认页面、电子邮件、短信或订房记录确认结果。如果没有收到通知,也可以重新登录网站查询订单。但 AI 智能体不一定能读取委托人的私人消息,更不能在缺乏证据时,仅凭自己曾经点过提交按钮,就认定交易已经完成。这也意味着,网站要提供完整的智能体体验,至少需要考虑三个相互衔接的条件。
第一层:可操作(Operability)
智能体必须能识别操作入口、理解字段含义,并知道哪些动作可以执行。例如,日期选择器应该提供明确的日期信息,订房按钮应能被恰当的观测通道识别,不同房型的选择控件也应具备足够的区分信息。这一层最接近传统界面可供性与网页无障碍设计。如果控件的名称只描述外观,却没有说明它会触发什么动作,智能体仍可能在正确的页面上做出错误判断。
第二层:已授权(Authorization)
智能体知道如何执行,不代表它有权自行执行。搜索房价与确认订房、查看购物车与完成付款,虽然可能只差一个按钮,对用户造成的后果却完全不同。因此,产品需要在有实际副作用的操作之前,确认智能体是否获得了必要授权。尤其涉及付款、取消订单或修改个人资料时,系统应有清晰的权限边界,并在必要时让委托人亲自确认。这也是 AX 与单纯界面可用性最大的分界之一。
第三层:可验证(Verifiability)
这也是本次实验最直接揭示的问题。智能体提交请求后,网站必须提供足以判断结果的信息。处理中、已完成与操作失败,应该是能够明确区分的状态。若交易已经成立,也应保留订单编号或其他可再次查询的凭据。当网络中断或响应丢失时,智能体应先查询既有交易状态,而不是立即重新提交请求。后端也需要通过幂等机制,避免同一笔交易因重试而被重复创建。这三个条件并不是彼此独立的界面功能,而是同一项委托任务从开始到完成所需要的连续保障。
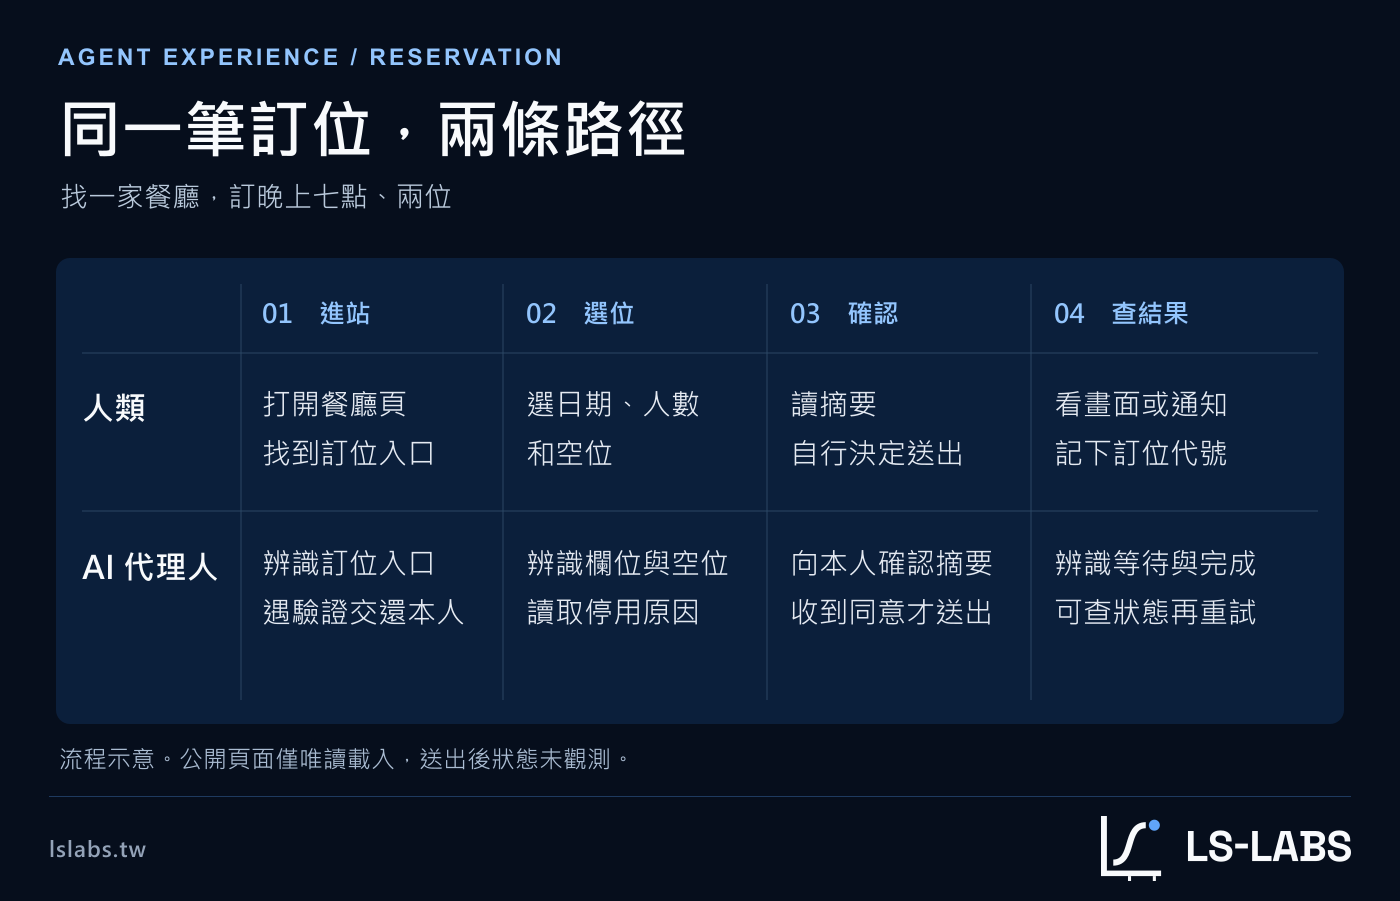
这类需求也开始出现在新兴的智能体商务协议中。以 UCP 结账规范为例,协议把结账过程划分为多种状态,包括 complete_in_progress 与 completed,分别表示结账请求已被接受并正在处理,以及订单已成功创建。两者不能混为一谈。如果智能体没有收到完成结账的响应,规范要求先通过查询操作获取当前状态,只有在仍无法确认原请求是否已被处理时,才允许以相同的幂等键重试原请求。当流程需要买方介入时,也提供交还操作的机制。这说明智能体友好的设计已不只是让 AI 能调用 API,而是开始涉及交易状态、权限与错误恢复等完整的操作流程。
如何评估一个网站的智能体可操作性?
基于前面的理论与实验,本文把这类针对特定任务的检查方式称为智能体可操作性(Agent Operability)。这是 LS-Labs 用于研究分析的操作性概念,并非普遍采用的行业标准。它关注的核心问题是:当一项任务交由 AI 智能体执行时,智能体能否在既定权限内完成必要操作,并取得可查验的结果?传统 UX 中的认知走查(Cognitive Walkthrough)通常会检查用户是否知道该做什么、能否发现正确操作、是否理解操作与目标的关系,以及操作后能否看到恰当的反馈。智能体可操作性可以沿用这些检查思路,但需要进一步纳入委托授权、后端状态与重试风险。
订位任务测试示例
请帮我在“测试小馆”预订 2026 年 11 月 20 日晚上 19:00 的座位,两位成人,备注希望安排靠窗座位,联系人填写“测试用户”。
如果 19:00 没有位子,才改订 19:30。
最后提交之前,请先提供完整订位摘要,取得我的同意后才能提交。整个过程只允许创建一笔订位。
测试时,可以让智能体在干净的浏览器会话中重复执行相同任务,记录每一步采取的操作、收到的页面反馈,以及最终的数据库状态。评估时不应只看单次任务是否完成,还需要观察同一任务在重复执行时是否保持一致。这也呼应了 τ-bench 对智能体可靠性的研究。2024 年发布的 τ-bench 引入了 passk 指标,用来评估智能体在相同任务上重复执行 k 次时,能否每次都成功。
研究显示,在当时的零售任务环境中,使用函数调用的 GPT-4o 智能体,pass¹ 为 61.2%,但 pass⁸ 已降至 25% 以下。单次成功与持续稳定地完成任务,并不是一回事。对订房、购物和其他可能产生实际交易的服务而言,智能体偶尔完成任务并不足以证明产品已具备可靠的自动化条件。除了记录成功率,更重要的是把失败原因对应到具体的操作环节。
| 失败现象 | 检查维度 | 订位情境 |
|---|---|---|
| 找不到操作入口 | 操作线索 | 按钮缺少可识别的名称或角色 |
| 填错日期、人数或备注 | 字段与参数 | 不同房型使用相同名称的选择器 |
| 误判系统状态 | 状态反馈 | 把处理中误认为订位成功 |
| 重复提交请求 | 重试安全 | 缺少结果查询方式,导致再次提交订单 |
| 无法确认任务结果 | 结果验证 | 订位已成立,却没有编号或查询凭据 |
| 遇到登录或真人验证 | 访问与授权 | 无法自行完成身份验证 |
| 未经同意就创建订单 | 委托授权 | 把预览操作误认为最终提交 |
| 被页面内容误导 | 指令来源 | 将促销或网页指示误当成委托人的要求 |
| 违反备案条件 | 业务规则 | 19:00 仍有空位,却直接选择 19:30 |
| 遗漏原始任务限制 | 任务记忆 | 换页后忘记靠窗备注或只准订一笔 |
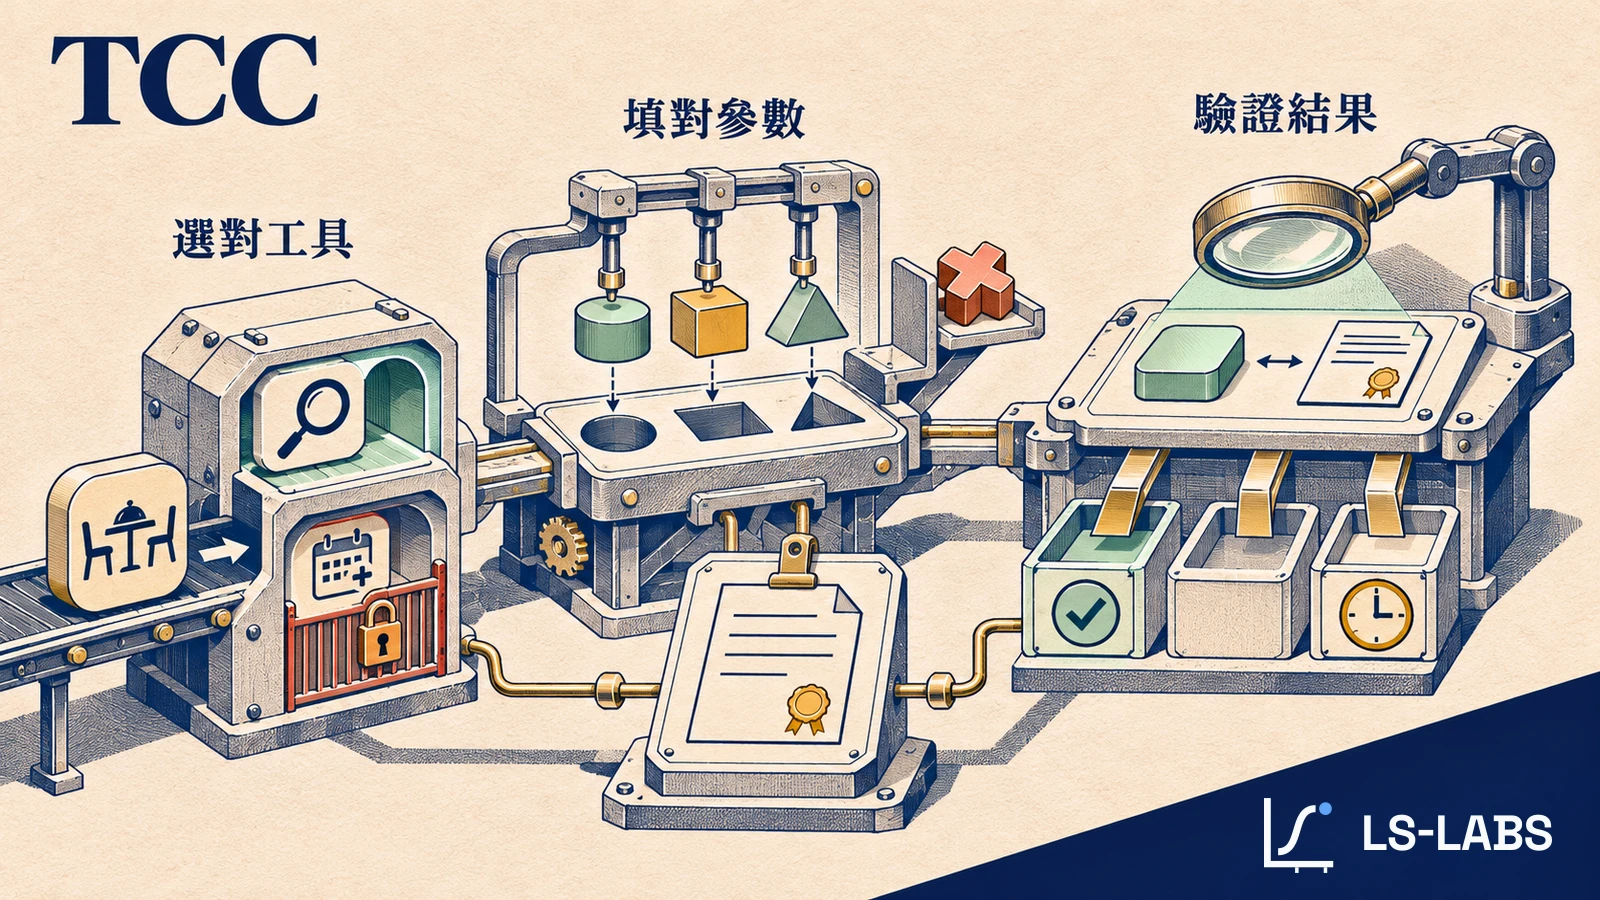
整理自 WebArena、τ-bench、OSWorld-Verified 与 ST-WebAgentBench。分类与订位案例由 LS-Labs 根据研究目的整理,并非各原始研究采用的统一分类。这份对照表的主要用途,是让网站开发者能把智能体的失败现象对应到需要检查的系统条件。例如,找不到按钮可能需要改进语义与操作线索;填写错误可能涉及字段名称与上下文;已经成功提交却无法汇报,则更可能需要处理交易状态与结果查询。不同问题需要不同的改进方式,不能全都归因于模型理解能力不足。需要把工具选用、参数与返回结果写成可重跑的题卡时,可对照TCC 任务调用契约的实验与模板。
已有 WCAG,为什么还需要 AX?
如果智能体遇到的问题包括按钮名称不明确、表单缺少标签,或无法识别状态变化,那么直接采用现有的网页无障碍规范,是否就足够了?这是个合理的疑问。事实上,许多智能体界面问题,确实可以通过现有的网页无障碍设计来改善。以 WCAG 2.2 为例,第 4.1.2 项要求界面组件的名称、角色与状态等信息能被程序识别;第 4.1.3 项则要求特定状态消息能通过辅助技术获取。这些原本是为了让残障用户更容易操作网站的设计原则,如今也可能让依赖结构化界面信息的 AI 智能体受益。
因此,提升网页无障碍能力,是搭建智能体友好界面的重要基础。但它仍无法涵盖智能体代表人类执行任务时的所有问题。例如,WCAG 并不负责定义 AI 智能体应该获得哪些交易权限,也不要求网站提供可以查询的订单凭据,更不处理智能体重复发送付款请求时,后端应如何确保交易不会重复成立。这些问题已经超出传统界面可用性的范围,涉及产品权限、API 契约、交易安全与状态管理。因此,AX 不适合被理解为另一套取代 UX、DX 或 WCAG 的界面规范。
它更像是一个跨越既有设计领域的评估视角:当产品允许智能体代表用户采取行动,原本分散在不同系统中的设计条件,是否能共同支撑一项完整的委托任务?从这个角度看,智能体友好设计不一定意味着减少所有人工介入。相反,当操作涉及付款、身份验证或其他高风险行为时,能够清楚识别授权边界,并在必要时把控制权交还真人,本身就是良好智能体体验的一部分。AX 的目标不是让 AI 能执行网站上的每一个动作,而是让它知道哪些动作能做、哪些需要授权,以及如何确认最后的结果。
当 AI 成为用户,网站需要重新定义“完成”
回到开头那家台南酒店。当你把订房任务交给 AI,真正期待的结果并不是它成功点击了多少个按钮,也不是它是否顺利填完表单。你想知道的是:房间到底订好了没有?如果 AI 找到了符合需求的房型,取得你的同意并提交了数据,却无法提供订房编号,也无法确认交易是否成立,那么这项委托仍然存在未解决的问题。本次 32 次订位实验,正好把这个差异呈现了出来。在缺陷版的 16 次测试中,智能体都成功完成了数据填写与后端提交,却没有一次能取得足以确认订位的结果信息。
这不代表智能体不具备操作能力,而是说明当 AI 开始成为网站的用户,产品的可用性必须从“能否操作界面”,进一步延伸到“能否完成并验证任务”。从可供性理论来看,同一个环境对不同用户而言,可能提供完全不同的操作条件。而 Agent Experience 让这个问题有了新的现实意义。当 AI 开始替人类行动,网站不能只让它找到入口,还必须让它知道事情何时真正完成。
主题阅读:AX 阅读指南 · 首页 AI 搜索地球
研究资料与来源
- Gibson, J. J. (1979). The Theory of Affordances. In The Ecological Approach to Visual Perception.
- Norman, D. A. (2013). The Design of Everyday Things: Revised and Expanded Edition. Basic Books.
- Norman, D. A. (2008). Signifiers, Not Affordances. Interactions, 15(6), 18–19.
- Gaver, W. W. (1991). Technology Affordances. CHI 1991.
- Hartson, H. R. (2003). Cognitive, physical, sensory, and functional affordances in interaction design. Behaviour & Information Technology, 22(5), 315–338.
- Biilmann, M. (2025). Introducing AX: Why Agent Experience Matters;以及 One Year of AX(2026)。
- Mastykarz, W. (2026). What is Agent Experience (AX)?. Microsoft for Developers.
- Zhou, S. et al. (2024). WebArena: A Realistic Web Environment for Building Autonomous Agents. ICLR 2024.
- Yao, S. et al. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv 预印本。
- W3C (2023). Web Content Accessibility Guidelines (WCAG) 2.2.
- IETF (2023). RFC 9457: Problem Details for HTTP APIs。
- Universal Commerce Protocol. Checkout specification, 2026-08-25。
- LS-Labs (2026-11-05). AX-RSV-001:本机订位对照实验。原始逐步记录、截图与 SQLite 状态保存在 LS-Labs 研究工作区。