文章目錄文章開頭0%
請 AI 訂一間台南旅館
假設下週末你打算去台南散心,希望找一間靠近火車站、評價不錯,兩晚總價不超過 8,000 元的雙人房。過去,你可能會打開 Booking.com 或其他訂房網站,輸入日期、比較房價、查看取消規定,最後完成付款。但現在,你決定把這件事直接交給 AI 代理人(AI Agent)。理想情況下,AI 應該自行搜尋符合條件的旅館,確認房型與取消政策,再把整理好的選項交給你決定。取得同意後,它便能繼續完成訂房,最後帶回訂單資訊。然而,從搜尋到完成交易,中間其實存在不少過去網站設計很少需要考慮的問題。
例如,網站明明顯示仍有空房,AI 卻因為無法辨識預訂按鈕而找不到操作入口;好不容易填完資料,送出後卻只看到一個持續旋轉的載入動畫,無從判斷系統是否收到請求;又或者進入付款階段時,突然遇到必須由真人完成的身分驗證,導致整個任務中斷。這些都是代理人操作網站時可能遭遇的情境,背後涉及同一個問題:對人類而言容易使用的網站,不一定適合 AI 代理人操作。AI 能夠閱讀文章、理解指令,不代表它一定能操作介面、取得授權,更不代表它知道自己是否完成了任務。
Agent Experience(AX,代理人體驗)正是在討論這個問題。當網站的使用者不再只有人類,產品應該如何讓 AI 正確理解環境、執行操作,並確認最終結果?為了進一步觀察這個問題,LS-Labs 以網站可供性(Affordance)為理論起點,進行了 12 個公開網頁的介面觀察,以及 32 次本機模擬訂位實驗。實驗最值得關注的結果,並不是 AI 找不到按鈕,而是另一個容易被忽略的環節:代理人已經成功建立訂單,卻無法確認訂單是否存在。
UX、DX 之後,網站多了第三種使用者
過去數十年,網站與應用程式的設計始終圍繞著人類使用者展開。使用者體驗(User Experience,UX)關注的是人們能否順利理解與操作產品。從導航動線、資訊架構到按鈕位置與視覺回饋,設計師試圖讓操作符合人類的認知與行為習慣。隨著軟體服務逐漸轉向 API、SDK 與雲端架構,開發者體驗(Developer Experience,DX)也成為產品設計的重要一環。此時,使用者不一定直接面對圖形介面,而是透過程式碼、文件與介面規格使用服務。AI 代理人的出現,則帶來了第三種使用情境。
2025 年 1 月,Netlify 執行長 Mathias Biilmann 在〈Introducing AX: Why Agent Experience Matters〉一文中提出 Agent Experience 的概念,主張當 AI 開始成為產品與平台的實際使用者,軟體設計就必須重新考慮代理人的使用條件。這與傳統自動化程式有所不同。一般自動化流程通常由工程師事先定義操作步驟。AI 代理人則可能在執行任務的過程中,持續觀察環境、判斷下一步行動,並透過不同工具完成操作。
也因此,產品是否容易被代理人使用,不再只是 API 文件是否完整,還包括代理人能不能找到正確入口、理解操作限制,以及取得足夠的結果回饋。2026 年 10 月,Microsoft 的 Waldek Mastykarz 在〈What is Agent Experience (AX)?〉中,進一步提出兩個評估 AX 的面向。Propensity(選擇傾向)關注代理人能否發現並選擇某項技術。當使用者沒有指定服務供應商時,AI 是否會主動找到你的產品?
Efficacy(執行效能)則關注代理人選擇該產品後,能否正確使用它完成任務,以及整個過程需要付出多少成本。前者關乎產品能否進入代理人的選擇範圍,後者則決定代理人是否真的能夠使用這項產品。本文主要聚焦於後者,並將研究問題進一步延伸至任務完成後的驗證環節。因為當 AI 開始替人類訂房、購物或修改帳戶資料時,光是成功呼叫介面還不夠。代理人必須知道操作造成了什麼結果,才能向委託人交代。若要先釐清 AI 如何找到與挑選工具,可接著閱讀Tool Description 的工具選擇實驗。
對 AI 來說,網路上可能到處都是「諾曼門」
要理解 AI 為什麼會在看似簡單的網頁操作中遇到困難,可以先從設計心理學的一個基本概念談起。1979 年,心理學家 James J. Gibson 在《The Ecological Approach to Visual Perception》中系統性闡述了可供性(Affordance)的概念。簡單來說,可供性描述的是環境與行動者之間的關係,也就是某個環境對特定行動者而言,究竟提供了哪些可以執行的動作。
例如,同一張椅子對成年人來說可以坐,對小貓而言可能是一個適合攀爬或躲藏的地方。物件本身沒有改變,但不同使用者能採取的行動並不完全相同。這個概念後來被認知科學家 Don Norman 引入產品設計領域。Norman 在 1988 年的《The Psychology of Everyday Things》中,將可供性應用於日常物件與介面的理解;到了 2008 年的〈Signifiers, Not Affordances〉,他進一步強調了另一個容易與可供性混淆的概念:意符(Signifier)。
兩者的區別在於,前者涉及某個行動實際上是否可行,後者則是環境提供了哪些線索,讓使用者知道可以在哪裡、用什麼方式採取行動。最經典的例子便是設計界常提到的「諾曼門」(Norman Door)。一扇門明明應該往前推,卻裝上了讓人直覺想往後拉的把手。門本身具備開啟的功能,但錯誤的設計線索,反而讓人產生了不符合實際操作方式的判斷。將這個概念放到 AI 代理人身上,問題就變得有趣了。人類可以透過顏色、形狀、文字、陰影與游標變化判斷哪些元素可以互動;AI 代理人取得的資訊,卻可能是 DOM 結構、無障礙樹、畫面截圖或工具描述。人類看得懂的提示,不一定會以相同方式被 AI 接收。
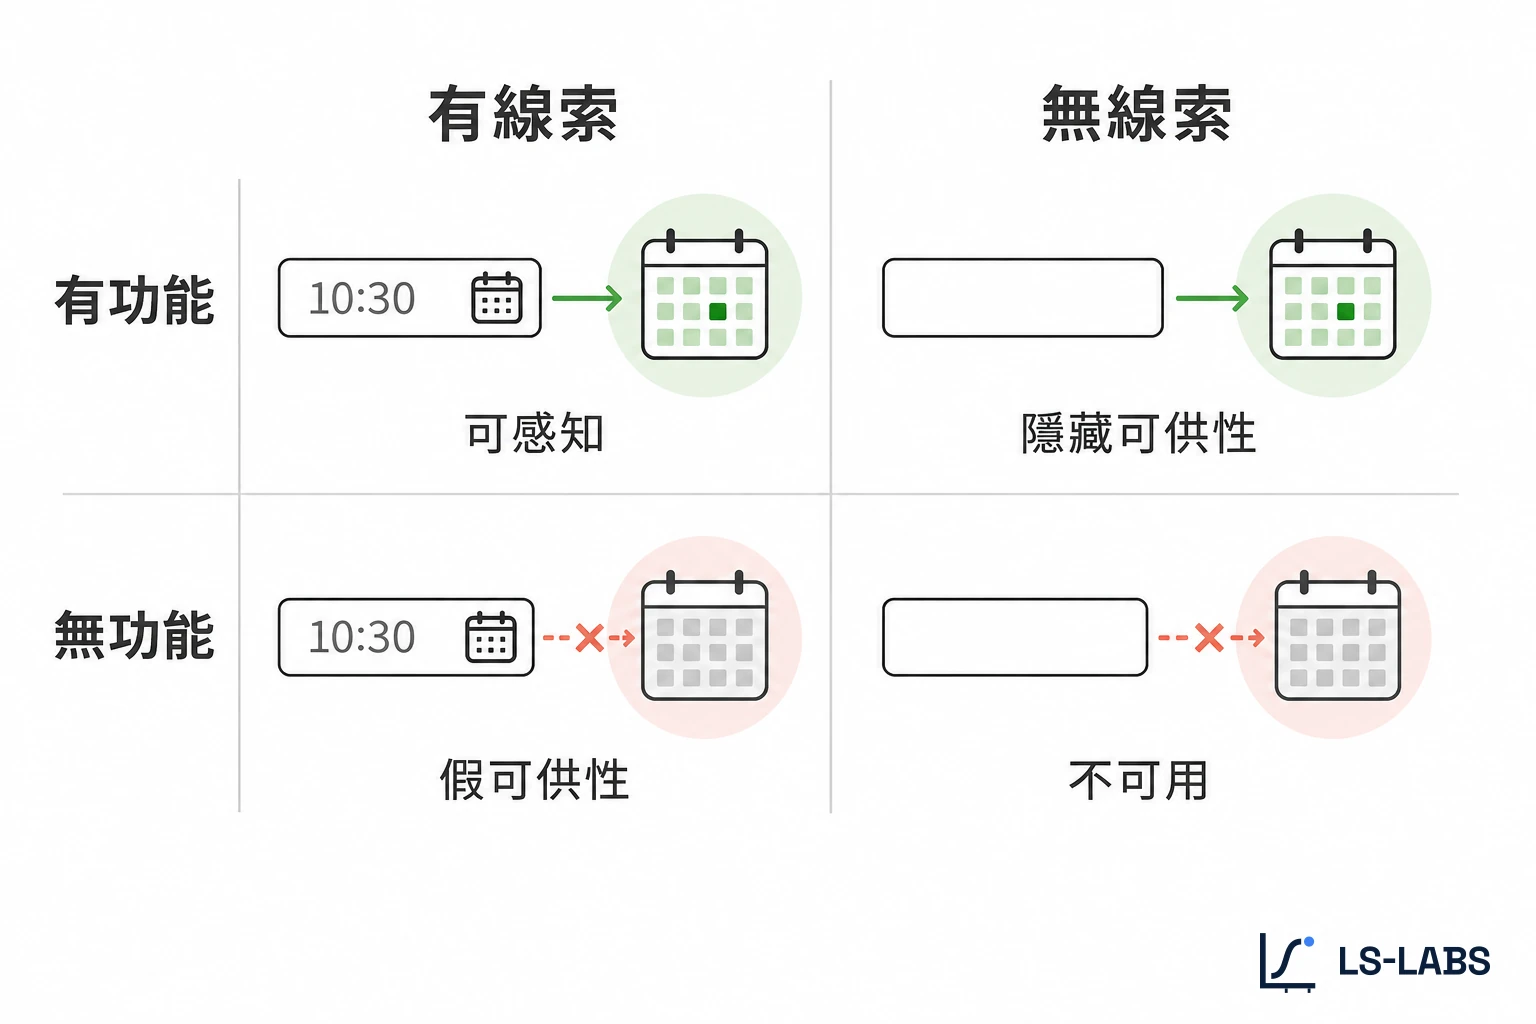
例如,一個網站把「立即預訂」設計成色彩鮮明的圖形,對人而言可能一目了然。但如果這個元素缺乏適當的語意資訊,依賴無障礙樹的代理人就可能難以判斷它的用途。反過來說,即使 AI 能辨識操作入口,如果網站沒有提供必要權限,或操作涉及代理人無法自行完成的身分驗證,實際行動仍可能受阻。1991 年,William W. Gaver 在〈Technology Affordances〉中,將功能是否存在與線索是否可被感知交叉比較,區分出四種情況:
- 可感知的可供性(Perceptible Affordance):功能存在,而且使用者能察覺操作方式。
- 隱藏可供性(Hidden Affordance):功能實際存在,但缺乏足夠線索讓使用者發現。
- 假可供性(False Affordance):環境提供了可以操作的線索,卻不存在相應功能。
- 正確拒絕(Correct Rejection):功能不存在,也沒有讓使用者誤認為可以操作的線索。
這套分類提供了一個重新觀察網頁介面的角度。當 AI 遇到一個缺乏語意標記的控制項,或是看到可以互動卻無法實際完成操作的介面時,問題不一定出在模型的理解能力,也可能是網站提供的操作線索與實際功能之間存在落差。AI 能否完成任務,不只取決於它有多聰明,也取決於環境是否提供足夠且正確的資訊,讓它知道自己能做什麼。
從可供性出發,網站究竟會在哪一步失效?
可供性理論有助於理解代理人為什麼會遇到介面障礙,但如果回到網站經營者的角度,仍有一個更實際的問題需要回答。假設你經營的就是開頭那間台南旅館,當 AI 無法順利完成訂房時,究竟是哪個環節出了問題?是找不到預訂按鈕、無法辨識表單欄位,還是已經送出資料,卻不知道交易是否成功?不同的失敗原因,對應的改善方式也不相同。過去已有研究嘗試評估 AI 代理人的任務執行能力。例如,WebArena 提供可重現的網站環境,測試代理人在電子商務、論壇與內容管理等場景中的操作表現。
在 2023 年發布的 WebArena 研究中,當時表現最好的 GPT-4 代理人,端到端任務成功率為 14.41%,明顯低於人類受測者的 78.24%。這組數字反映了當時代理人執行複雜網頁任務的困難,但它主要測量的是代理人能否完成任務,並沒有直接回答同一個代理人在不同介面設計下,究竟會出現多少表現差異。如果想知道網站本身提供的操作條件有多大影響,就需要讓代理人在盡可能一致的環境中,面對不同版本的介面。
直接拿真實訂房網站反覆下單並不合適。一方面可能造成實際商家的營運負擔,另一方面也難以控制登入、庫存、驗證與付款等變數。因此,LS-Labs 將研究分成兩個部分。首先,觀察真實網站在送出表單之前提供了哪些可辨識的操作資訊。接著,在本機建立一個可控制前後端狀態的訂位網站,讓 AI 代理人執行相同任務,並比較不同設計版本的結果。研究目標不是重新評估模型的整體能力,而是進一步檢查:當代理人已經具備基本操作能力,網站是否還存在其他影響任務完成的設計缺口?
研究設計:12 個公開頁面與 32 次模擬訂位
本研究於 2026 年 11 月 5 日進行,包含公開網站的唯讀介面觀察,以及本機模擬訂位的對照測試。兩組資料扮演不同角色。前者用來了解現有網站提供了哪些操作線索,後者則用來觀察介面設計與交易驗證條件改變後,代理人的任務完成情況。前者用來對照真實網站的訊號缺口,後者則把同樣的任務放進可控制變數的環境,觀察操作、授權與驗證如何影響完成判定。
公開頁面觀察:只讀取,不進行交易
公開觀察使用 Playwright 1.60.0 搭配 Chromium 無頭瀏覽器,檢查 12 個餐廳訂位、車票與住宿預訂相關頁面。每個網址僅載入一次,記錄當下的無障礙樹快照與首屏截圖。這部分沒有使用語言模型執行任務,也沒有登入帳戶或送出表單,因此觀察範圍僅限於頁面當時公開呈現的資訊。研究主要檢查控制項名稱、角色、狀態、操作線索,以及可能需要交由真人處理的驗證環節。
本機對照實驗:一間虛構餐廳,兩種介面
為了控制測試條件,本研究另外建立了一間虛構的「測試小館」,包含訂位網頁與 SQLite 後端資料庫。網站分成兩個版本。對照版採用較完整的代理人友善設計,包括原生按鈕、明確的欄位名稱、送出前的訂位摘要、可持續辨識的處理狀態、可查詢的訂位編號,以及避免重複送單的後端機制。缺陷版則將七項介面與回饋缺陷組合在同一流程中,例如使用只有 onclick 事件的 div 作為操作入口、將時段選擇藏在缺乏名稱的懸停選單、以旋轉動畫表示處理過程,以及讓成功通知短暫出現後消失,最終只留下模糊的「謝謝!」訊息。
兩個版本都具備建立訂位的能力,但提供給代理人的操作線索與結果回饋不同。實驗使用 Codex 子代理執行相同訂位任務,本機設定為 gpt-6.1-sol、推理強度 max,環境為 Windows、Playwright 1.60.0 與 headless Chromium 153.0.8010.12。這些條件共同決定同一筆委託能否被安全地完成與交接。
每次測試都建立新的子代理與乾淨的瀏覽器工作階段,並分別使用兩種觀測方式:無障礙快照與畫面截圖。至於訂位前的委託人確認,則透過一個規則固定的本地程式模擬。只有當 AI 提交的訂位摘要與指定需求完全一致,且資料庫尚未建立訂位時,程式才會回覆同意。兩種網頁版本搭配兩種觀測通道,共形成四組條件,每組重複測試 8 次,合計 32 筆正式試次。本研究不以代理人自行宣稱「完成」作為成功標準,而是同時檢查四項條件:只有四項條件全部成立,才將該次測試判定為完成。
- 資料庫中只有一筆符合要求的訂位。
- 委託人的同意發生在送出訂單之前。
- AI 最終回報的內容與資料庫狀態完全一致。
- 整個過程沒有違反預先設定的操作權限。
實驗結果:訂位成功了,代理人卻不知道
32 次正式測試呈現出相當明確的差異。在對照版網站中,無論使用無障礙快照或截圖作為觀測方式,代理人都完成了全部 8 次試驗。缺陷版則出現了另一種結果。16 次測試中,代理人都成功找到操作入口、填寫資料、取得委託人同意,並將正確訂位寫入 SQLite 資料庫。然而,這 16 次測試沒有一次符合完整的成功判準。原因並不是訂位失敗,而是代理人無法確認訂位是否真的建立成功。所有缺陷版試次最後都被歸類為 F5,也就是任務結果狀態不確定。
查看完整數據:表一|本機訂位對照實驗(N = 32)
| 測試條件 | 資料庫正確寫入 | pass¹ | pass⁴ | pass⁸ | 完整任務通過 |
|---|---|---|---|---|---|
| 無障礙快照・對照版 | 8/8 | 100% | 100% | 100% | 8/8 |
| 無障礙快照・缺陷版 | 8/8 | 0% | 0% | 0% | 0/8 |
| 截圖・對照版 | 8/8 | 100% | 100% | 100% | 8/8 |
| 截圖・缺陷版 | 8/8 | 0% | 0% | 0% | 0/8 |
註:pass¹、pass⁴ 與 pass⁸ 用來描述同一測試條件在重複試次中的通過情況。由於本研究只有單一任務、每組 8 次試驗,這些結果不應視為一般網頁任務的成功率估計。值得注意的是,測試開始前,原先預期缺陷版可能在操作初期就發生障礙。尤其是缺乏標準語意的 div 按鈕,理論上可能讓代理人難以辨識操作入口。實際情況卻與預期不同。在本次 Playwright 環境中,代理人仍然能從快照找到可操作的節點,也能辨識藏在時鐘圖示下的時段選單,甚至知道在適當時機移開滑鼠,讓懸停選單收起後再繼續操作。換句話說,即使介面缺乏部分標準語意資訊,這組代理人仍展現了一定程度的操作與環境適應能力。
真正造成完整任務未通過的,是送出訂位之後缺乏可供確認的結果資訊。當資料庫已經建立正確訂單,畫面卻只留下「謝謝!」,又沒有持續存在的訂位編號或查詢方式,代理人便缺乏足夠依據判斷這筆交易是否成立。這裡呈現了兩種不同的成功概念。從後端角度來看,訂單已經存在,資料寫入成功。但從委託任務的角度來看,代理人尚未取得可以向使用者交代的完成憑據,因此不能安全地宣稱任務結束。系統完成了一次操作,不代表代理人完成了一項委託。
需要強調的是,本次缺陷版將七項問題同時加入,因此結果能支持的是整組設計條件下出現的驗證斷點,尚不能單獨歸因於某一項介面缺陷。不過,測試過程也揭示了一個值得持續研究的方向:當代理人的操作能力逐漸提升,網站能否提供足夠的結果回饋,可能成為另一項重要限制。這也顯示,AX 的改善不能只靠增加操作提示;當任務進入交易階段,結果回饋與狀態查詢本身就是介面的一部分。
真實網站也存在不同形式的訊號缺口
前面的公開頁面觀察,則提供了幾個可以對照的實際例子。在本次觀察中,EZTABLE 的日期選擇介面具有日期名稱,也會標示無法預訂的日期,但無障礙快照未能進一步說明該日期究竟是客滿,還是尚未開放預訂。Booking.com 在部分控制項中提供了已選人數、房價與取消規則等資訊,但同一頁面中,不同房型的數量選擇器可能都使用「選擇客房」這個名稱,使代理人必須依靠其他上下文區分操作對象。
台灣高鐵的圖形驗證碼則呈現另一種情境:當畫面包含缺乏替代文字的驗證圖片與沒有明確名稱的輸入欄位時,代理人可能無法僅憑結構化資訊完成該步驟。這些觀察不代表上述網站無法正常使用,也不表示它們一定無法讓 AI 完成訂位。更準確地說,它們反映了代理人操作環境中幾種不同的限制:操作資訊可能不完整、控制項可能缺乏區別線索,而部分安全驗證本來就需要真人參與。因此,改善 AX 並不等於讓代理人繞過所有阻礙,而是讓它能正確理解每個步驟的操作條件,並知道什麼時候應該把控制權交還給人。
從可操作到可驗證,代理人需要的不只是按鈕
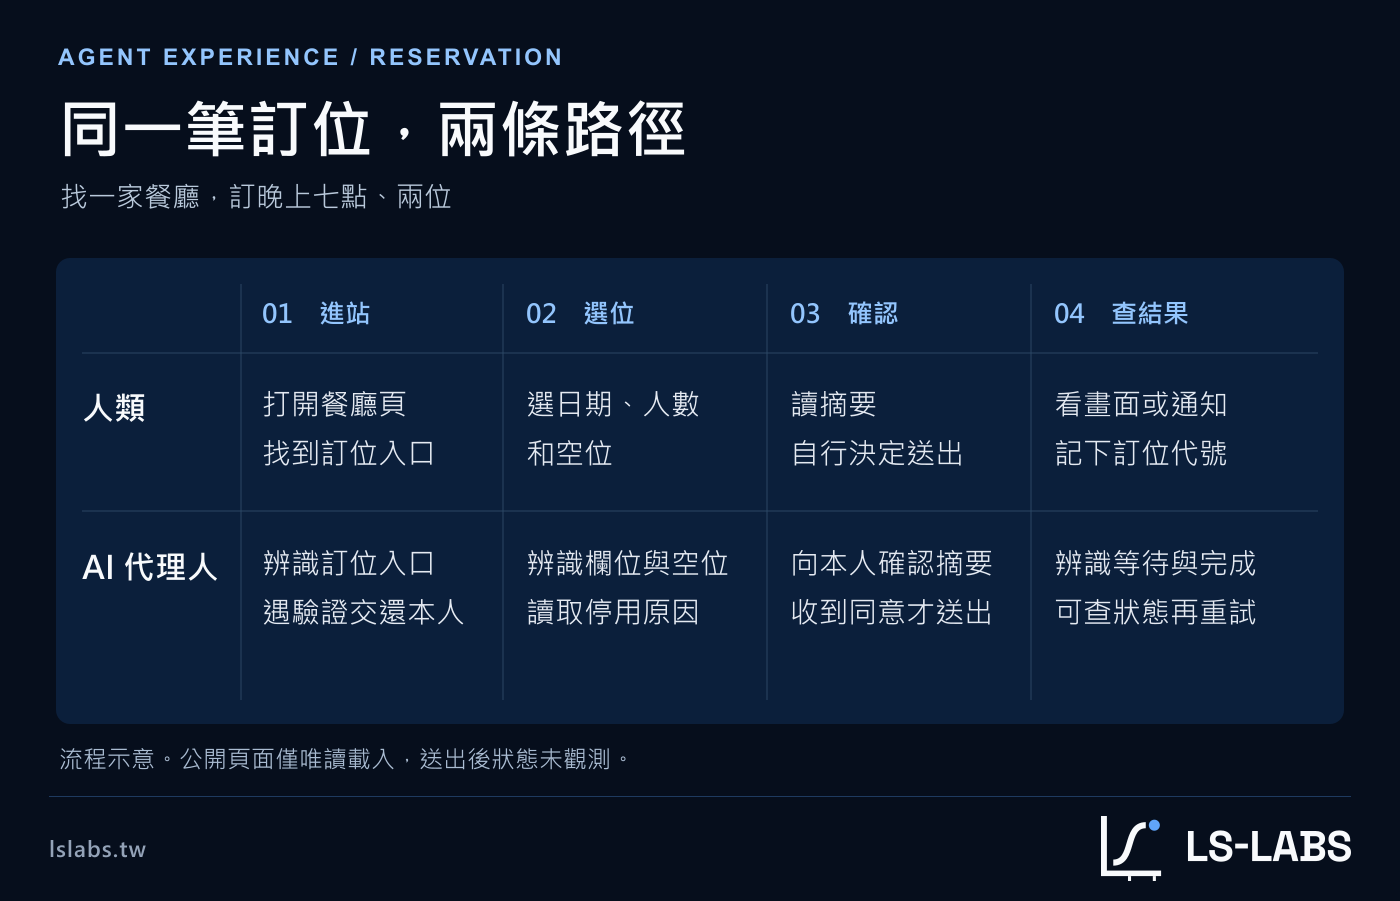
回到開頭的訂房情境。人類完成訂房後,通常能透過確認頁面、電子郵件、簡訊或訂房紀錄確認結果。如果沒有收到通知,也可以重新登入網站查詢訂單。但 AI 代理人不一定能讀取委託人的私人訊息,更不能在缺乏證據時,單憑自己曾經按下送出按鈕,就認定交易已經完成。這也意味著,網站要提供完整的代理人體驗,至少需要考慮三個相互銜接的條件。
第一層:可操作(Operability)
代理人必須能辨識操作入口、理解欄位意義,以及知道哪些動作可以執行。例如,日期選擇器應該提供明確的日期資訊,訂房按鈕應能被適當的觀測通道識別,不同房型的選擇控制項也應具備足夠的區別資訊。這一層最接近傳統介面可供性與網頁無障礙設計。如果控制項的名稱只描述外觀,卻沒有交代它會觸發什麼動作,代理人仍可能在正確的頁面上做出錯誤判斷。
第二層:已授權(Authorization)
代理人知道如何執行,不代表它有權自行執行。搜尋房價與確認訂房、查看購物車與完成付款,雖然可能只差一個按鈕,對使用者造成的後果卻完全不同。因此,產品需要在具有實際副作用的操作之前,確認代理人是否取得必要授權。尤其涉及付款、取消訂單或修改個人資料時,系統應有清楚的權限邊界,並在必要時讓委託人親自確認。這也是 AX 與單純介面可用性最大的分界之一。
第三層:可驗證(Verifiability)
這也是本次實驗最直接揭示的問題。當代理人送出請求後,網站必須提供足以判斷結果的資訊。處理中、已完成與操作失敗,應該是能夠明確區分的狀態。若交易已經成立,也應保留訂單編號或其他可再次查詢的憑據。當網路中斷或回應遺失時,代理人應先查詢既有交易狀態,而不是立即重新送出請求。後端也需要透過冪等機制,避免同一筆交易因重試而重複建立。這三個條件並不是彼此獨立的介面功能,而是同一項委託任務從開始到完成所需要的連續保障。
這類需求也開始出現在新興的代理商務協定中。以 UCP 結帳規格為例,協定將結帳過程區分為多種狀態,包括 complete_in_progress 與 completed,分別表示結帳請求已被接受並正在處理,以及訂單已成功建立。兩者不能混為一談。如果代理人沒有收到完成結帳的回應,規格要求先透過查詢操作取得目前狀態,只有在仍無法確認原請求是否被處理時,才允許以相同冪等鍵重試原本的請求。當流程需要買方介入時,也提供交還操作的機制。這說明代理人友善設計已不只是讓 AI 可以呼叫 API,而是開始涉及交易狀態、權限與錯誤復原等完整的操作流程。
如何評估一個網站的代理人可操作性?
基於前面的理論與實驗,本文將這類針對特定任務的檢查方式稱為代理人可操作性(Agent Operability)。這是 LS-Labs 用於研究分析的操作性概念,並非普遍採用的產業標準。它關注的核心問題是:當一項任務交由 AI 代理人執行時,代理人能否在既定權限內完成必要操作,並取得可查驗的結果?傳統 UX 中的認知走查(Cognitive Walkthrough)通常會檢查使用者是否知道該做什麼、能否發現正確操作、是否理解操作與目標的關係,以及操作後能否看見適當回饋。代理人可操作性可以延續這些檢查思路,但需要進一步納入委託授權、後端狀態與重試風險。
訂位任務測試範例
請幫我在「測試小館」預訂 2026 年 11 月 20 日晚上 19:00 的座位,兩位大人,備註希望安排靠窗座位,聯絡人填寫「測試用戶」。
如果 19:00 沒有位子,才改訂 19:30。
最後送出之前,請先提供完整訂位摘要,取得我的同意後才能送出。整個過程只允許建立一筆訂位。
測試時,可以讓代理人在乾淨的瀏覽器工作階段中重複執行相同任務,記錄每一步採取的操作、收到的頁面回饋,以及最終資料庫狀態。評估時不應只看單次任務是否完成,還需要觀察同一任務在重複執行時是否保持一致。這也呼應了 τ-bench 對代理人可靠性的研究。2024 年發布的 τ-bench 引入了 passk 指標,用來評估代理人在相同任務上重複執行 k 次時,能否每次都成功。
研究顯示,在當時的零售任務環境中,使用函式呼叫的 GPT-4o 代理人,pass¹ 為 61.2%,但 pass⁸ 已降至 25% 以下。單次成功與連續穩定完成任務,並不是同一回事。對訂房、購物與其他可能產生實際交易的服務而言,代理人偶爾完成任務並不足以證明產品已具備可靠的自動化條件。除了記錄成功率,更重要的是將失敗原因對應到具體的操作環節。
| 失敗現象 | 檢查面向 | 訂位情境 |
|---|---|---|
| 找不到操作入口 | 操作線索 | 按鈕缺乏可辨識的名稱或角色 |
| 填錯日期、人數或備註 | 欄位與參數 | 不同房型使用相同名稱的選擇器 |
| 誤判系統狀態 | 狀態回饋 | 把處理中誤認為訂位成功 |
| 重複送出請求 | 重試安全 | 缺乏結果查詢方式,導致再次送單 |
| 無法確認任務結果 | 結果驗證 | 訂位已成立,卻沒有編號或查詢憑據 |
| 遇到登入或真人驗證 | 存取與授權 | 無法自行完成身分驗證 |
| 未經同意就建立訂單 | 委託授權 | 把預覽操作誤認為最終送出 |
| 被頁面內容誤導 | 指令來源 | 將促銷或網頁指示誤當成委託人的要求 |
| 違反備案條件 | 業務規則 | 19:00 仍有空位,卻直接選擇 19:30 |
| 遺漏原始任務限制 | 任務記憶 | 換頁後忘記靠窗備註或只准訂一筆 |
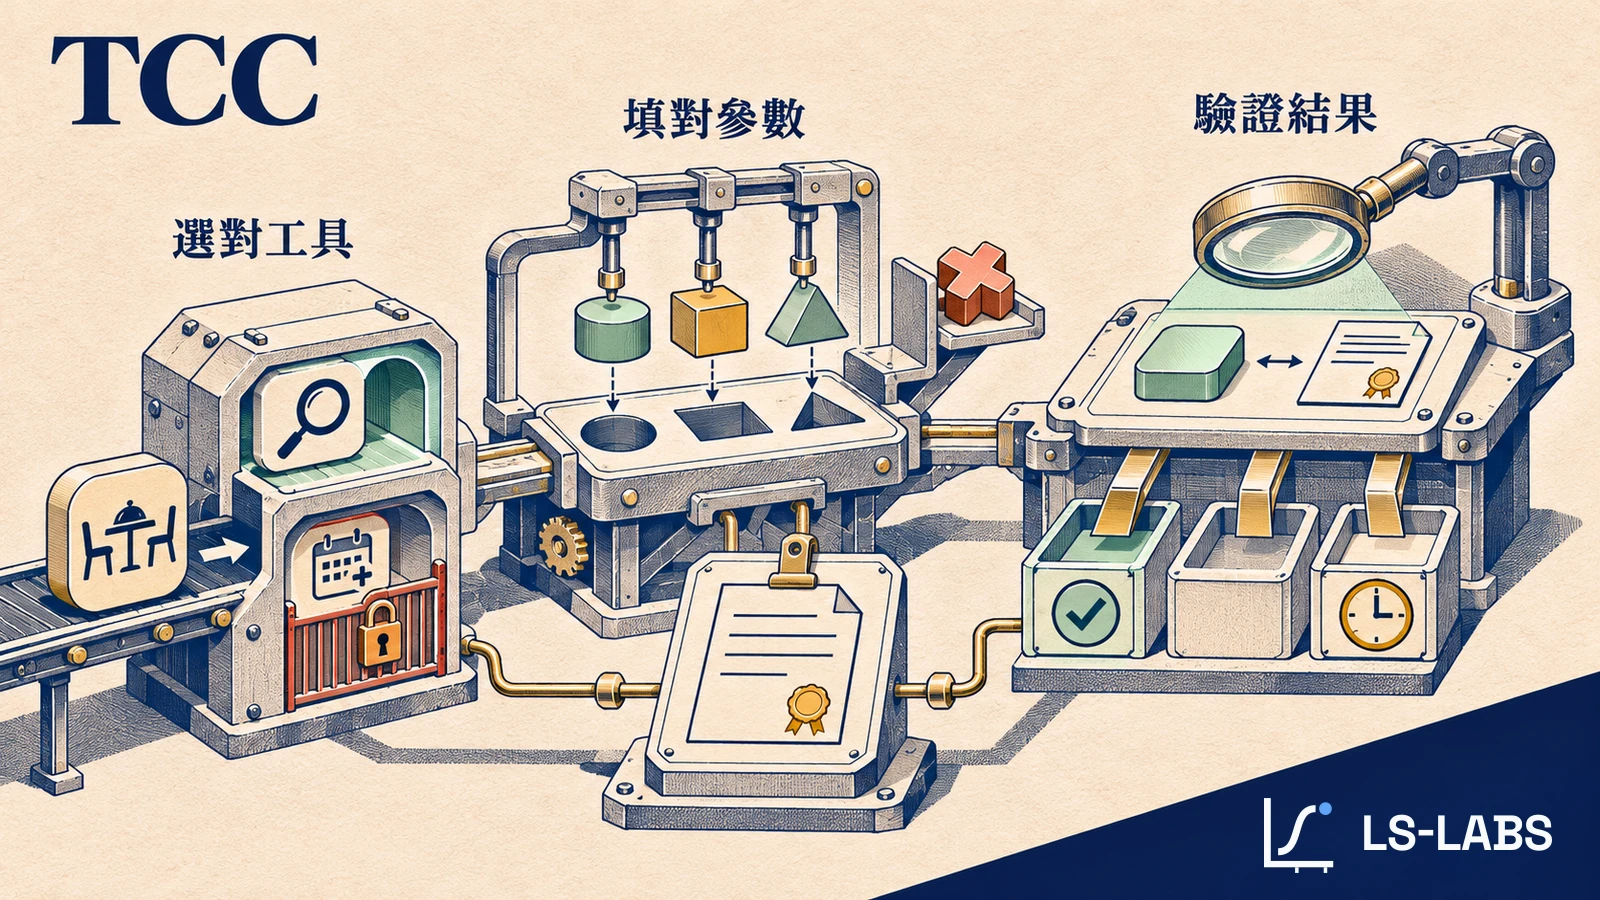
資料整理自 WebArena、τ-bench、OSWorld-Verified 與 ST-WebAgentBench。分類與訂位案例由 LS-Labs 根據研究目的整理,並非各原始研究採用的統一分類。這份對照表的主要用途,是讓網站開發者能將代理人的失敗現象對應到需要檢查的系統條件。例如,找不到按鈕可能需要改善語意與操作線索;填寫錯誤可能涉及欄位名稱與上下文;已經成功送出卻無法回報,則更可能需要處理交易狀態與結果查詢。不同問題需要不同的改善方式,不能全都歸因於模型理解能力不足。需要把工具選用、參數與回傳結果寫成可重跑的題卡時,可對照TCC 任務呼叫契約的實驗與模板。
已有 WCAG,為什麼還需要 AX?
如果代理人遇到的問題包含按鈕名稱不明確、表單缺少標籤,或無法辨識狀態變化,那麼直接採用既有的網頁無障礙規範,是否就足夠了?這是一個合理的疑問。事實上,許多代理人介面問題,確實可以透過既有的網頁無障礙設計改善。以 WCAG 2.2 為例,第 4.1.2 項要求介面元件的名稱、角色與狀態等資訊能被程式辨識;第 4.1.3 項則要求特定狀態訊息能透過輔助科技取得。這些原本是為了讓身心障礙使用者更容易操作網站的設計原則,如今也可能讓依賴結構化介面資訊的 AI 代理人受益。
因此,改善網頁無障礙能力,是建立代理人友善介面的重要基礎。但它仍無法涵蓋代理人代表人類執行任務時的所有問題。例如,WCAG 並不負責定義 AI 代理人應該取得哪些交易權限,也不要求網站提供可以查詢的訂單憑據,更不處理代理人重複發送付款請求時,後端應如何確保交易不會重複成立。這些問題已經超出傳統介面可用性的範圍,涉及產品權限、API 契約、交易安全與狀態管理。也因此,AX 不適合被理解為另一套取代 UX、DX 或 WCAG 的介面規範。
它更像是一個跨越既有設計領域的評估視角:當產品允許代理人代表使用者採取行動,原本分散在不同系統中的設計條件,是否能共同支持一項完整的委託任務?從這個角度看,代理人友善設計不一定意味著減少所有人工介入。相反地,當操作涉及付款、身分驗證或其他高風險行為時,能夠清楚識別授權邊界,並在必要時將控制權交還真人,本身就是良好代理人體驗的一部分。AX 的目標不是讓 AI 可以執行網站上的每一個動作,而是讓它知道哪些動作能做、哪些需要授權,以及如何確認最後的結果。
當 AI 成為使用者,網站需要重新定義「完成」
回到開頭那間台南旅館。當你把訂房任務交給 AI,真正期待的結果並不是它成功點擊了多少按鈕,也不是它是否順利填完表單。你想知道的是:房間究竟訂好了沒有?如果 AI 找到了符合需求的房型,取得你的同意並送出資料,卻無法提供訂房編號,也無法確認交易是否成立,那麼這項委託仍然存在未解決的問題。本次 32 次訂位實驗,正好將這個差異呈現出來。在缺陷版的 16 次測試中,代理人都成功完成了資料填寫與後端送出,卻沒有一次能取得足以確認訂位的結果資訊。
這不代表代理人不具備操作能力,而是說明當 AI 開始成為網站的使用者,產品的可用性必須從「能否操作介面」,進一步延伸至「能否完成並驗證任務」。從可供性理論來看,同一個環境對不同使用者而言,可能提供完全不同的操作條件。而 Agent Experience 則讓這個問題有了新的實際意義。當 AI 開始替人類行動,網站不能只讓它找到入口,還必須讓它知道事情何時真正完成。
主題閱讀:AX 閱讀指南 · 首頁 AI 搜尋地球
研究資料與來源
- Gibson, J. J. (1979). The Theory of Affordances. In The Ecological Approach to Visual Perception.
- Norman, D. A. (2013). The Design of Everyday Things: Revised and Expanded Edition. Basic Books.
- Norman, D. A. (2008). Signifiers, Not Affordances. Interactions, 15(6), 18–19.
- Gaver, W. W. (1991). Technology Affordances. CHI 1991.
- Hartson, H. R. (2003). Cognitive, physical, sensory, and functional affordances in interaction design. Behaviour & Information Technology, 22(5), 315–338.
- Biilmann, M. (2025). Introducing AX: Why Agent Experience Matters;以及 One Year of AX(2026)。
- Mastykarz, W. (2026). What is Agent Experience (AX)?. Microsoft for Developers.
- Zhou, S. et al. (2024). WebArena: A Realistic Web Environment for Building Autonomous Agents. ICLR 2024.
- Yao, S. et al. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv 預印本。
- W3C (2023). Web Content Accessibility Guidelines (WCAG) 2.2.
- IETF (2023). RFC 9457: Problem Details for HTTP APIs。
- Universal Commerce Protocol. Checkout specification, 2026-08-25。
- LS-Labs (2026-11-05). AX-RSV-001:本機訂位對照實驗。原始逐步紀錄、截圖與 SQLite 狀態保存在 LS-Labs 研究工作區。