文章目錄文章開頭0%
AI 為什麼卡在訂房流程?
假設你準備前往台南旅行,希望預訂一間下週末入住、兩晚總價不超過 8,000 元、靠近火車站且評價良好的雙人房。過去,你會打開訂房平台,輸入日期、設定價格篩選器,瀏覽幾張照片後依指示完成結帳;現在,你將這道指令交給 AI 代理人(AI Agent)。
理想狀態下,Agent 應該自主完成搜尋、比價、核對入住條件,並在取得你的授權後完成下單。然而在真實環境中,這條自動化鏈路卻十分脆弱:網站明明有空房,Agent 卻因為按鈕缺乏語義標籤而找不到預訂入口;送出表單後,因為無法判讀非同步載入的狀態變化而誤以為失敗,進而重複下單;又或者在付款跳轉時撞上突如其來的重新登入驗證,最終只能中斷任務。
這類失敗可能同時涉及大型語言模型(LLM)的能力、工具設定與網站設計。同一個網站對人類與 AI 代理人,也可能提供截然不同的操作線索。2024 年發表於 ICLR 的 WebArena 研究揭示了這道鴻溝:在涵蓋電商、論壇、程式協作與內容管理的 812 個多步驟仿真網站任務中,人類使用者的端到端成功率高達 78.24%,而當時表現最佳的 GPT-4 Agent 成功率卻僅有 14.41%。
這組數據點出了「語義理解能力」與「環境操作能力」之間的結構性落差。當 AI 的角色從提供知識解答的搜尋與對話引擎,演進為替人類處理購物、差旅、財務與系統管理的自主執行代理人(Autonomous Agent),數位產品的設計命題也跟著改變:當使用者不再親自點擊螢幕,該如何打造一個讓 AI 代理人也能精準感知、獲得授權、可靠執行並安全收斂的環境?這正是 Agent Experience(AX,代理人體驗)誕生的核心背景。
UX、DX 與 AX:誰在使用網站?
要理解 AX 為何在此時浮上檯面,可以先將它放回數位產品數十年來的體驗演化脈絡中。在早期的軟體與網站時代,產品設計的核心是 User Experience(UX,使用者體驗),解決「人類感官與認知」如何與圖形化介面(GUI)互動的問題,關注版面視覺動線、資訊架構與操作直覺。隨著軟體走向平台化與雲端化,企業開始透過 API、SDK 與命令列工具對外提供服務,Developer Experience(DX,開發者體驗)應運而生;此時的使用者變成了人類工程師,產品好壞取決於技術文件是否清晰、介面規格是否一致、錯誤訊息是否易於除錯,讓工程師能寫出決定論(Deterministic)的程式碼來串接系統。
進入生成式 AI 與代理人時代後,第三類使用者出現了。2025 年 1 月,Netlify 執行長 Mathias Biilmann 在〈Introducing AX: Why Agent Experience Matters〉一文中,正式將體驗設計的邊界推向 Agent Experience(AX)。與人類直接操作介面(UX)或工程師預先寫好串接邏輯(DX)不同,AI Agent 是一個在執行期(Runtime)動態感知環境、自主規劃步驟並呼叫工具的機率性系統。當人類將任務委託給 AI,Agent 能否代表使用者取得授權、讀懂平台規則並完成操作,便直接影響該數位服務在 AI 生態系中的採用率。
2026 年 10 月,Microsoft 首席開發者倡導者 Waldek Mastykarz 在〈What is Agent Experience (AX)?〉中,進一步將 AX 推進至可量化的工程檢驗,提出兩大核心維度:Propensity(選擇傾向),即當使用者未指定工具時,Agent 能否發現並傾向選擇你的服務;以及 Efficacy(執行效能),即當 Agent 選定你的服務後,能否在合理的運算成本與步數內,呼叫正確且未淘汰的介面完成任務。
人類親自操作依賴視覺動線與感官直覺
人類透過顏色對比、按鈕陰影、滑鼠懸停(Hover)狀態與彈出提示理解畫面;遇到異常時能靠常識自行變通。
工程師預先串接依賴技術文件與固定規格
開發者在產品上線前先讀懂 API 規格、取得金鑰並寫成決定論(Deterministic)程式碼,執行期由固定邏輯處理。
AI 代理人動態執行依賴結構化線索與人機交接
Agent 在執行期(Runtime)根據一句目標動態找入口、選工具、填參數並驗證狀態;評估重心分成選擇傾向(Propensity)與執行效能(Efficacy)。
為什麼原本為人類打磨到極致的 UX,到了 Agent 手中卻常導致低落的 Efficacy?這個問題可以回到知覺心理學與設計學的底層理論來找答案。1979 年,心理學家 James J. Gibson 在《The Ecological Approach to Visual Perception》中提出 Affordance(可供性),意指環境相對於特定行動者所提供的行動可能性。一張及膝的椅子對成年人具備「坐下」的可供性,對幼貓而言卻是「躲藏」或「攀爬」的空間。可供性是「行動者能力」與「環境特徵」交織出的關係,而非物體單方面的客觀屬性。
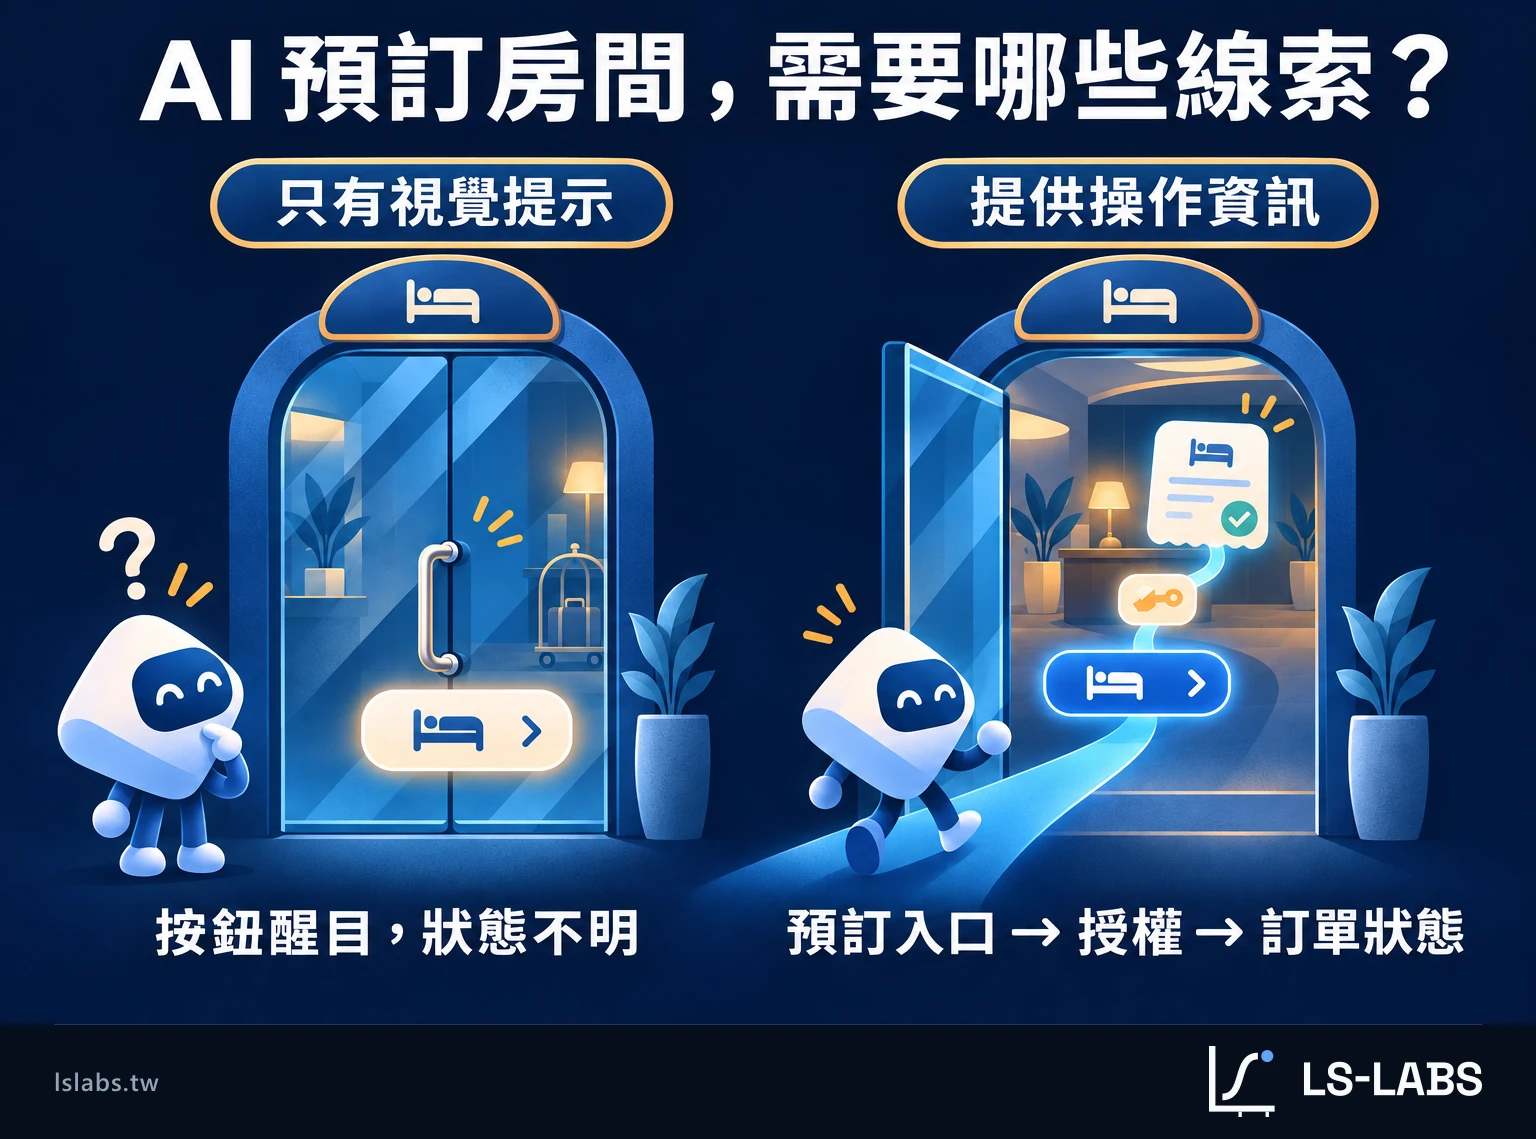
1988 年,認知科學家 Don Norman 將此概念引入設計領域,並在 2008 年〈Signifiers, Not Affordances〉與 2013 年修訂版《設計的心理學》中做出關鍵區分:Affordance 決定哪些行動在物理或系統上是可能的;Signifier(意符)則是環境釋放給行動者、用來提示「操作方式與當前狀態」的線索。一扇門具備被推開的可供性,但若裝上一個讓人想往外拉的握把,錯誤的意符就會導致操作失敗,成為經典的「諾曼門(Norman Door)」。
今天的網際網路,對 AI Agent 而言到處都是諾曼門。人類依賴顏色對比、邊框陰影、滑鼠懸停時出現的手指游標,或是月台上聚集的人群,來判斷「哪裡可以點擊」與「系統現在處於什麼狀態」。一旦行動者從人類換成 AI Agent,感知器官與執行工具徹底改變,原本為人類視覺與認知量身打造的 Signifier 隨即失效;當 Agent 缺乏瀏覽器操作權限或 API 授權時,連最基本的 Affordance(行動可能性)都不存在。AX 的核心任務,就是在行動者轉換為 AI 的前提下,重新對齊數位環境的「可供性」與「意符」。
人類視角的介面線索(UX Signifiers)
<!-- 視覺上有漸層與陰影,但缺乏語義與狀態回饋 -->
<div class="btn-gradient shadow-lg" onclick="submitOrder()">
  立即預訂 →
</div>
<div class="toast-fade">處理中,請稍候...</div>- 操作線索:靠顏色漸層、陰影與游標變化暗示「可點擊」。
- 狀態感知:靠短暫浮現 2 秒的 Toast 彈窗或畫面轉圈動畫判斷進度。
- 權限驗證:結帳中途跳出圖形驗證碼(CAPTCHA)或簡訊 OTP 視窗。
對人類直覺好懂,對 AI 卻是「數位諾曼門」
代理人視角的介面線索(AX Signifiers)
// 結構化語義、明確參數邊界與可查驗的狀態碼
reserve_room({
  hotel_id: "tainan_sta_01",
  check_in: "2026-11-14",
  idempotency_key: "req_9f8a7b"
}) → { status: "PENDING_USER_CONFIRM", order_id: "ORD-8821" }- 操作線索:明確的
role="button"無障礙語義,或結構化的工具 Schema。 - 狀態感知:回傳機器可判讀的
status、order_id與獨立查詢端點。 - 權限驗證:支援分級授權與人機交接(Handoff),在扣款前交回人類確認。
對齊 AI 的感知與執行能力,建立可驗證閉環
AI 操作網站的三種方式
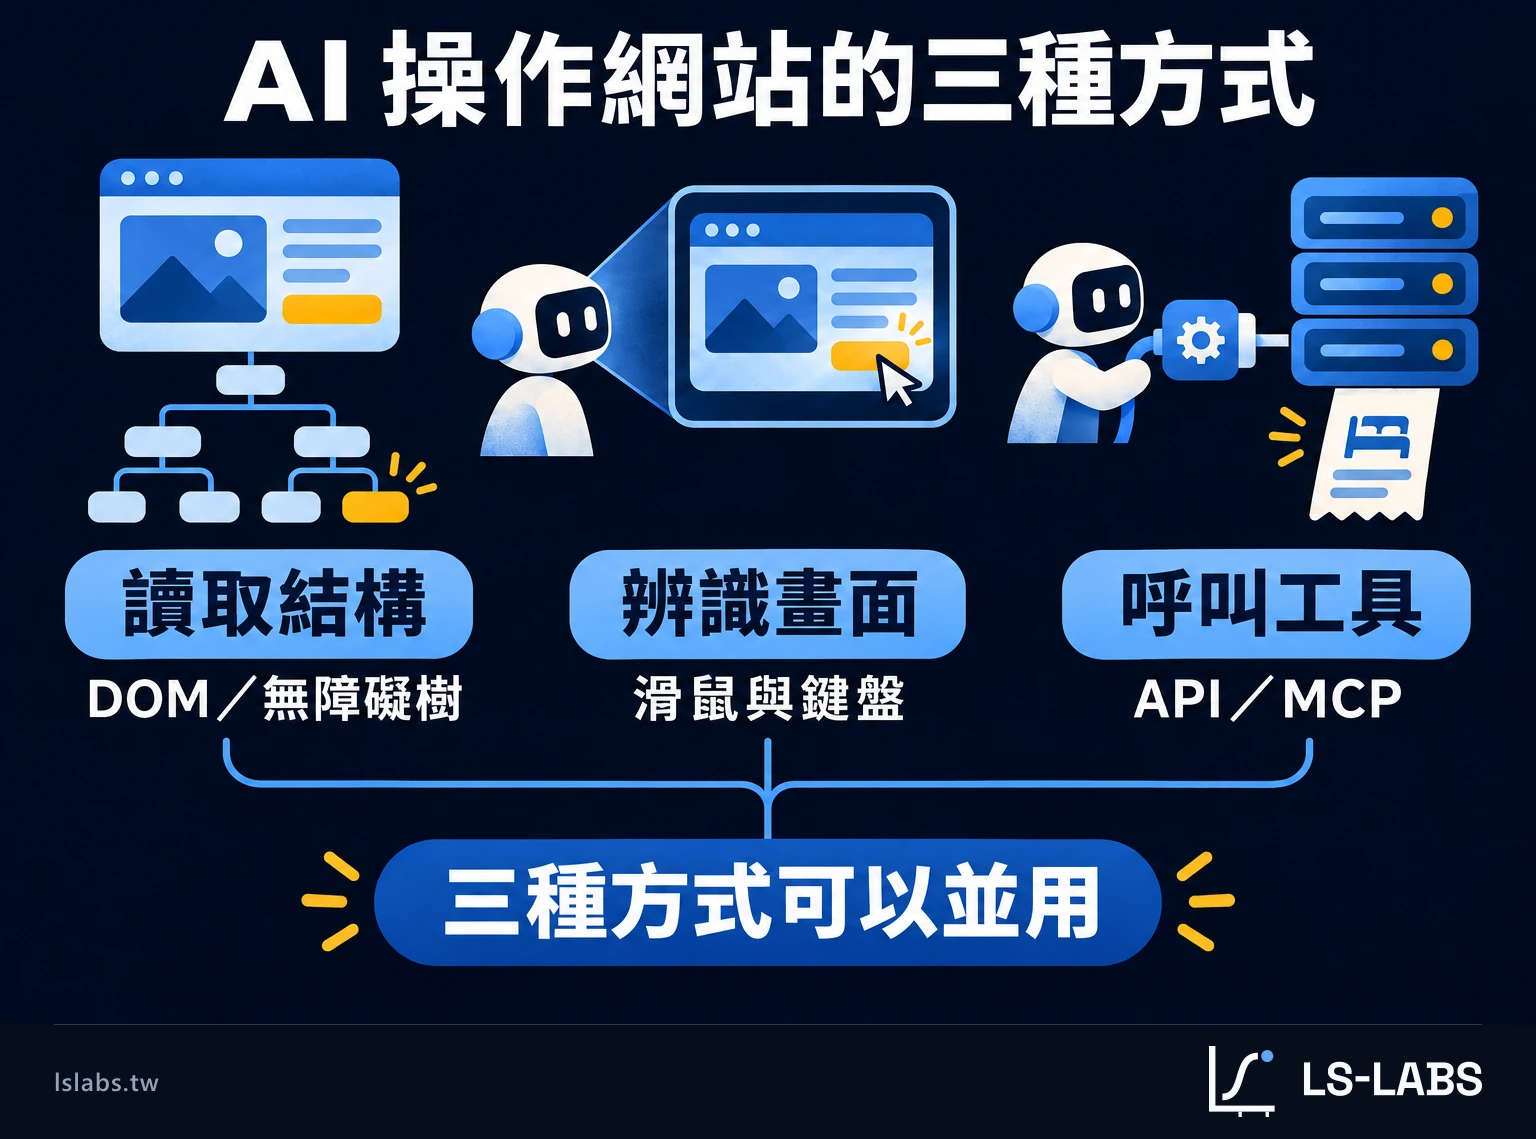
AI Agent 可以讀取網頁結構、辨識畫面,也可以直接呼叫工具。這三種方式可以並用,對網站提供的操作線索各有要求。
第一種是借道人類無障礙設計的「DOM 與無障礙樹(Accessibility Tree)解析」。每個網頁背後都有定義結構層級的 DOM,瀏覽器會依據 W3C 的可存取名稱與描述規範(Accessible Name and Description Computation),將 HTML 語義與 ARIA 屬性轉譯為供螢幕閱讀器使用的無障礙樹。像 WebArena 等早期瀏覽器 Agent,便是將網頁轉化為如 [1582] button "Add to Cart" 的結構化文字節點來決定操作對象。這條路徑運算成本低且精準,但高度依賴前端工程的語義規範;一旦網站用沒有替代文字的圖片或純 <div> 標籤拼湊出視覺按鈕,依賴無障礙樹的 Agent 就會直接「失明」。
第二種是模擬人類感官的「視覺操作(Computer Use/GUI Agent)」。既然網頁最初是畫給人類看的,Anthropic 於 2024 年推出的 Claude Computer Use,以及 OpenAI 於 2025 年推出的 Operator 與 Computer-Using Agent(CUA),便選擇直接擷取螢幕畫面,讓多模態大模型透過視覺辨識顏色、圖示與版面位置,再驅動虛擬滑鼠與鍵盤。2024 年的 WebVoyager 研究顯示,結合視覺截圖的 Agent 在測試環境中可達到 59.1% 的成功率,優於純文字結構設定;OpenAI 在 2025 年 3 月公布的 CUA WebArena 成功率則為 58.1%。這與早期 GPT-4 Agent 的模型和執行設定不同,不能把差距全歸因於視覺操作。不過,座標點擊偏移、動態彈出視窗干擾,以及長流程下的高昂 Token 延遲與誤判,仍讓純視覺路徑難以承擔高風險的商業交易。
第三種是專為代理人打造的「原生工具協定(API、MCP 與 WebMCP)」。與其讓 Agent 在人類介面上猜測按鈕位置,不如直接向 Agent 暴露結構化的功能入口(如 create_booking(hotel_id, check_in, check_out, guests))。從早期的 Function Calling,到 Anthropic 於 2024 年 11 月開源的 Model Context Protocol(MCP),再到 2026 年 W3C 社群群組推進的 WebMCP 規格草案(W3C Draft Community Group Report,尚非 W3C 標準,允許網頁將前端 JavaScript 函式註冊為 Agent 可呼叫的工具),數位產品正從「單一視覺介面」走向「人機雙軌介面」。
| 操作方式 | Agent 依賴的核心意符(Signifier) | 技術代表與標準 | 核心瓶頸與失效風險 |
|---|---|---|---|
| 結構解析(DOM/無障礙樹) | 元件角色(Role)、可存取名稱、DOM 層級與狀態屬性 | W3C ARIA 規範、WebArena 基礎架構 | 前端缺乏語義標籤、動態渲染元素命名不清導致漏判 |
| 視覺模擬(Computer Use) | 按鈕文字、圖示外觀、空間相對位置、畫面視覺變化 | Claude Computer Use、OpenAI CUA、WebVoyager | 座標定位偏移、彈窗遮擋、非同步載入狀態混淆、高延遲成本 |
| 原生工具呼叫(API/MCP) | 工具名稱、語義化功能描述、JSON Schema 參數、回傳結構 | Function Calling、Anthropic MCP、W3C WebMCP 社群群組草案 | 工具描述歧義、跨系統授權斷裂、後端狀態回傳不完整 |
許多企業常有一種期待:「只要未來模型能力繼續變強,或者把所有介面都改成機器格式,AX 問題就會自然消失。」但實證研究與工程測試給出了相反的提醒。
一方面,模型單次成功不代表商業上的可靠。2024 年模擬零售與客服互動的 τ-bench 研究(arXiv 預印本)引入了 passk 指標,用來衡量同一任務連續執行 k 次皆成功的機率。研究發現,當時頂尖模型在零售任務中的單次成功率(pass1)雖接近五成,但連續執行 8 次皆成功的 pass8 卻跌破 25%。在涉及金流與訂單的商業環境中,這種不穩定性足以造成嚴重客訴與帳務損失。
Microsoft 在 2026 年分享的 AX 測試也顯示,看似方便 Agent 的改動未必有用。在該次 CLI 部署測試中,改用 JSON 輸入後,各模型的單次任務成本變成原來的 4~11 倍;Claude Haiku 4.5 的成功次數從 5 次全對降為 2 次。在另一個 SharePoint Framework 升級測試中,明確要求 Agent 使用 CLI,讓通過的設定檢查從 30/80 增至 75/80。團隊隨後修改 Agent 會讀取的 Release Notes,觀察到每次執行都會主動使用 CLI。這是不同介入的結果,且只適用於文中測試的任務與設定。
為什麼「等模型變強」或「硬塞機器格式」無法自動解決 AX?三組實證數據對照
環境操作落差仿真網站多步驟基準(Zhou et al., 2024;OpenAI, 2025)人類使用者端到端成功率達 78.24%,早期 GPT-4 Agent 僅 14.41%。OpenAI 在 2025 年另公布 CUA 的結果為 58.1%;兩次評測的模型與執行設定不同,不能只用介面差異解釋。
多輪執行穩定度零售與客服互動基準(Yao et al., 2024,arXiv 預印本)衡量連續執行
k 次皆成功的 passk 指標顯示:模型在零售場景單次成功率(pass1)雖接近 50%,但連續 8 次皆成功的 pass8 卻低於 25%。偶爾成功不等於生產環境可靠。認知對齊 vs. 拖累CLI 與升級任務實驗(Mastykarz, 2026)✕ 負向拖累(Drag):該次 CLI 測試改用 JSON 輸入後,單次任務成本變成 4~11 倍;Haiku 4.5 的成功次數由 5/5 降為 2/5。
✓ 正向提升(Lift):明確要求使用 CLI 後,設定檢查通過數由 30/80 增至 75/80;後續修改 Release Notes 的觀察是每次都主動選用 CLI。
一次訂房,要確認四件事
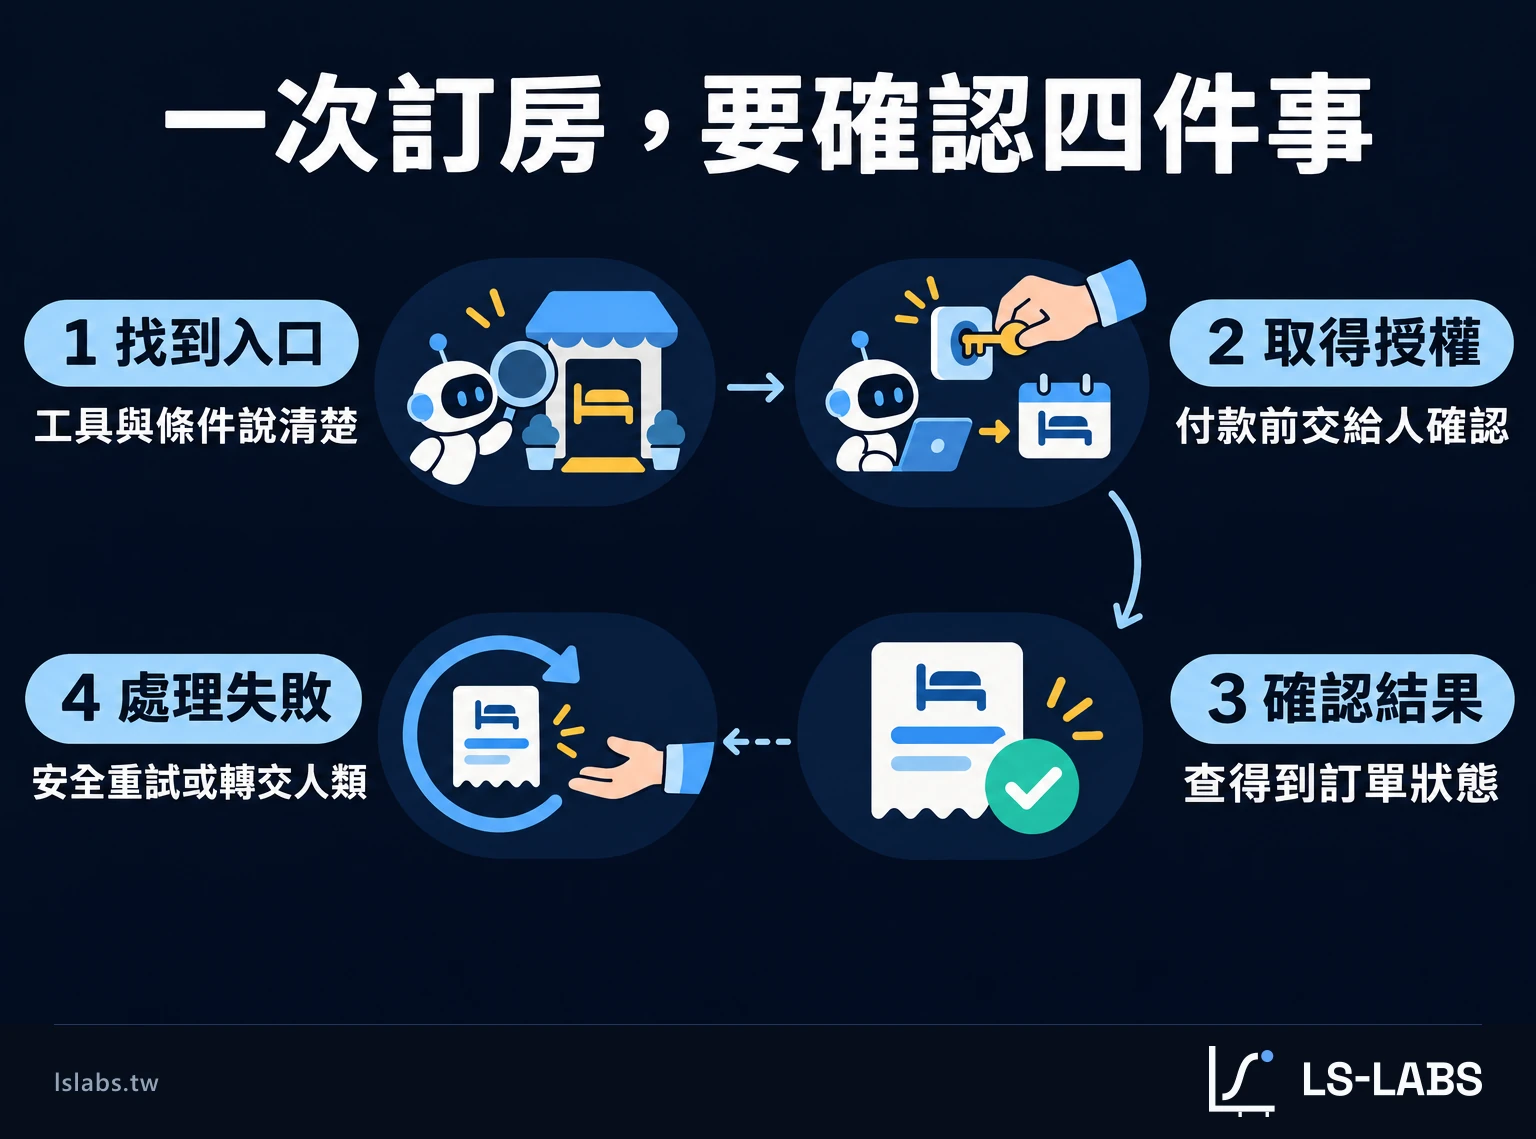
跳出單純的「介面讀取」、從端到端任務執行的視角審視 AX,就會發現「找到按鈕或呼叫 API」只是起點。Don Norman 曾以「火車月台」為例說明狀態意符的重要性:當你衝上月台卻沒看到火車時,你是根據月台上「是否還有大批候車人群」來推斷火車是還沒來、還是已經開走。同理,當 Agent 送出訂房請求後,若系統只回傳一句模糊的「處理完成」,或僅在畫面上閃過一個 Toast 提示,Agent 便無法確認訂單是否真正寫入資料庫。因此,成熟的 AX 需要涵蓋從「感知」到「狀態驗證與異常恢復」的完整生命週期。
結合 Gibson 的可供性理論、Norman 的意符概念與當代 Agent 實證研究,本站在實務檢視時採用的操作定義是:Agent Experience(AX)指當 AI Agent 代表人類執行任務時,數位產品環境能讓其辨識可用功能、在授權邊界內執行操作、驗證真實系統狀態,並在異常發生時安全恢復或轉交人類的閉環程度。本文將這套「AX 任務閉環」拆解為四項核心條件,並直接對應到企業的產品防呆設計與量化評估指標(此四階段閉環為本站整理的操作檢視框架,LS-Labs 目前尚未發布針對 AX 任務完成率的受控實驗數據):
| 閉環階段 | 理論與技術基底 | 實務場景設計(以訂房平台為例) | 企業觀測與評估指標 |
|---|---|---|---|
| 1. 可發現(Discoverable) | Signifier、語義明確性、Propensity(這層與 TSO 工具選擇優化直接銜接) | 清楚定義工具邊界,避免使用模糊的 execute(),改用明確描述參數與前置條件的查詢/預訂介面 | 功能辨識率、正確工具選擇率、無效探索步數 |
| 2. 可執行(Executable) | Affordance、最小權限授權、人機協同 | 支援階層式授權:允許 Agent 自主查價與鎖房,但涉及實際扣款與不可退訂條款時觸發人類確認機制 | 授權後操作成功率、權限阻礙率、單次任務 Token 成本 |
| 3. 可驗證(Verifiable) | 狀態意符(State Feedback)、結果導向驗證 | 明確回傳結構化狀態碼、訂單編號與處理階段(區分「已送出」與「已確認」),並提供獨立的狀態查詢入口供二次核驗 | 結果驗證準確率、狀態誤判率(False Positive/Negative) |
| 4. 可恢復(Recoverable) | 容錯設計、冪等性(Idempotency)、安全停止 | 網路中斷或逾時後,支援帶冪等鍵(Idempotency Key)的安全重試,或回傳可解析的錯誤原因與修復建議以交還人類 | 錯誤恢復率、重複下單率、高風險異常安全停止率 |
對企業而言,這套四階段閉環可以直接轉化為工程團隊的 Baseline 與 Lift/Drag(提升與拖累)測試流程。企業不需要憑空猜測哪種設計對 AI 比較友善,而可以透過四個步驟建立受控的實證迴圈:
怎麼測試 AX 改動有沒有用?
挑出最關鍵的使用者託付場景(例如:查詢指定日期與預算空房、核對取消政策、建立預訂、修改入住人資料),明確定義什麼狀態才算「任務成功收斂」。
固定模型版本、工具配置與初始資料狀態,讓 Agent 重複執行多次。同時記錄單次成功率、連續成功的
passk 穩定度、平均步數、Token 消耗與第一個中斷點。針對基準測試抓出的斷點做單一修改,例如為結帳按鈕補齊 ARIA 語義、在 API 錯誤回傳中加入 RFC 9457 結構化問題明細,或調整工具參數說明。
若任務成功率與
passk 提升、步數與 Token 成本下降,即為正向的 Lift(提升);若像 Microsoft 的 JSON 實驗一樣導致成本暴增或破壞既有流程,即為應捨棄的 Drag(拖累)。透過這種控制變因的實證迴圈,產品與工程團隊才能區分「哪些失敗源於底層模型的能力極限」,以及「哪些失敗是產品自身缺乏清晰意符與狀態回傳所築起的高牆」。
GEO、TSO 與 AX 的分工
當 AI Agent 介入消費者的資訊獲取與交易決策,企業最常問的戰略問題是:「AX 會成為下一個 SEO 或 GEO 嗎?」要回答這個問題,可以把使用者旅程拆解為從「資訊探索」到「工具選用與任務完成」的完整漏斗,釐清各階段的職責分工。
過去幾年備受關注的 GEO(Generative Engine Optimization,生成式引擎優化),核心戰場在於漏斗上半場(Discovery & Citation):當使用者向 AI 詢問「下週末台南火車站附近推薦哪間雙人房?」時,品牌如何透過結構化資料、內容權威度與外部引用來源,讓語言模型在生成答案時將自己納入推薦名單,對應 Microsoft 框架中的前端 Propensity(選擇傾向)。當使用者接著說出「好,幫我查第一間今晚有沒有空房並預訂」時,流程先經過 TSO(工具選擇優化)決定哪個訂房工具或 API 被選中,隨即進入漏斗下半場(Execution & Transaction),由 AX(代理人體驗)接管,解決從授權、執行、驗證到異常恢復的 Efficacy(執行效能)問題。
只有 GEO、缺乏 AX 的「推薦斷頭路」
- 前端表現:品牌內容常被 ChatGPT、Perplexity 或 Google AI 模式引用並推薦(高 Propensity)。
- 執行斷點:使用者要求 Agent 代為預訂時,網站因無語義按鈕、強制前置驗證碼或狀態回傳不明而卡死(低 Efficacy)。
- 長期後果:消費者被迫手動重來,甚至轉向能由 Agent 直接完成預訂的競爭對手平台。
診斷:贏了對話曝光,卻在最後一哩路流失轉換
只有 AX、缺乏 GEO/TSO 的「暗巷好店」
- 後端表現:平台提供完善的 API/MCP 介面、冪等重試機制與清楚的訂位回條(高 Efficacy)。
- 曝光斷點:缺乏公開可檢索的品牌內容、評價錨點與清晰的工具描述,模型在回答與工具檢索階段根本不會想到它(低 Propensity)。
- 長期後果:即使內部交易動線再順暢,也難以進入 AI 代理人的第一輪候選清單。
診斷:具備執行閉環,但缺乏前端發現與路由入口
換句話說,GEO、TSO 與 AX 共同構成了 AI 時代的商業轉換漏斗。只有 GEO 而沒有 AX 的品牌,會成為「AI 經常推薦、卻無法幫忙結帳」的斷頭路;只有 AX 而沒有 GEO 與 TSO 的產品,則像是一間動線順暢卻隱身在暗巷中的商店,連進入 Agent 候選清單的機會都沒有。
不過,擁抱 AX 並不代表企業應該毫無保留地對 AI 敞開大門,也不代表要為了機器而犧牲人類。2025 年開發者 Jim Nielsen 在〈AX, DX, UX〉中提出反思:當企業資源有限時,過度迎合 AI Agent 是否會導致人類使用者的體驗降級?事實上,健康的產品架構不必將 UX 與 AX 視為零和賽局。清晰的元件語義、明確的狀態回饋與結構化的錯誤提示,本身就是優質 UX 與無障礙設計(Accessibility)的基礎,能同時讓視障輔助工具、一般人類與 AI Agent 受益。
真正需要刻意區隔並建立防線的,是商業利益與安全邊界。向外部 Agent 開放高效率的操作通道,伴隨著帳號劫持、自動化濫用與新型態的資安威脅。例如 2026 年 W3C WebMCP 社群群組草案便明確將「提示詞注入(Prompt Injection)」、「工具描述投毒(Tool Poisoning)」與「高風險操作意圖誤判」列為核心安全風險(亦可參見本站在〈摩根大通開始封鎖 AI 代理人?〉與〈你的網站準備好讓 AI 代理人下單了嗎?〉中的討論)。一個遭受惡意網頁提示詞污染的 Agent,可能會在使用者不知情下呼叫已授權平台的轉帳或下單功能。
因此,成熟的 AX 設計追求的從來不是「百分之百無摩擦的全自動」,而是在「可執行」與「可恢復」階段植入明確的治理防線:包含細分操作範圍的 OAuth 授權、交易金額與敏感操作的強制人類確認(Human-in-the-Loop),以及防止 Agent 失控重試的速率限制與冪等保護。
從 1979 年 Gibson 筆下那張因行動者而異的椅子,到 2026 年穿梭於 DOM、視覺畫面與 MCP 協定之間的 AI Agent,介面設計的底層邏輯始終圍繞著「行動者與環境的匹配」。在 UX 的時代,產品團隊追問產品對人類而言是否直覺好用;在 AI 成為人類數位代理人的時代,AX 則向所有產品經營者拋出了一個更務實的商業問題:當你的顧客把任務交給 AI 時,你的產品,能讓它把事情安全、可靠地辦完嗎?
參考文獻
設計理論與學術研究
- Gibson, J. J. (1979). The Ecological Approach to Visual Perception. Houghton Mifflin.
- Norman, D. A. (2008). Signifiers, Not Affordances. Interactions, 15(6), 18–19. doi:10.1145/1409040.1409044
- Norman, D. A. (2013). The Design of Everyday Things: Revised and Expanded Edition. Basic Books.
- Deng, X., Gu, Y., Zheng, B., Chen, S., Stevens, S., Wang, B., Sun, H., & Su, Y. (2023). Mind2Web: Towards a Generalist Agent for the Web. NeurIPS 2023. arXiv:2306.06070
- Zhou, S., Xu, F. F., Zhu, H., Zhou, X., Lo, R., Sridhar, A., Cheng, X., Ou, T., Bisk, Y., Fried, D., Alon, U., & Neubig, G. (2024). WebArena: A Realistic Web Environment for Building Autonomous Agents. ICLR 2024. arXiv:2307.13854
- He, H., Yao, W., Ma, K., Yu, W., Dai, Y., Zhang, H., Lan, Z., & Yu, D. (2024). WebVoyager: Building an End-to-End Web Agent with Large Multimodal Models. ACL 2024. arXiv:2401.13919
- Xie, T., et al. (2024). OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. NeurIPS 2024. arXiv:2404.07972
- Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv 預印本. arXiv:2406.12045
官方技術規範與產業論述
- W3C (2018). Accessible Name and Description Computation 1.1. w3.org
- Anthropic (2024, November 25). Introducing the Model Context Protocol. anthropic.com
- Biilmann, M. (2025, January 28). Introducing AX: Why Agent Experience Matters. biilmann.blog
- Nielsen, J. (2025, March 2). AX, DX, UX. blog.jim-nielsen.com
- OpenAI (2025, March 11). New tools for building agents (Computer-Using Agent). openai.com
- Mastykarz, W. (2026, October 6). What is Agent Experience (AX)? Microsoft for Developers. developer.microsoft.com
- W3C Web Machine Learning Community Group (2026, November 2). WebMCP — Draft Community Group Report(W3C 社群群組草案). webmachinelearning.github.io