文章目录文章开头0%
AI 为什么卡在订房流程?
假设你准备去台南旅行,想预订一间下周末入住、两晚总价不超过 8,000 元、靠近火车站且评价良好的双人房。过去,你会打开订房平台,输入日期、设置价格筛选器,浏览几张照片后按提示完成结账;现在,你把这道指令交给 AI 智能体(AI Agent)。
理想状态下,Agent 应该自主完成搜索、比价、核对入住条件,并在取得你的授权后完成下单。然而在真实环境中,这条自动化链路十分脆弱:网站明明有空房,Agent 却因为按钮缺少语义标签而找不到预订入口;提交表单后,因为无法判读异步加载带来的状态变化而误以为失败,进而重复下单;又或者在跳转付款时撞上突如其来的重新登录验证,最终只能中断任务。
这类失败可能同时涉及大语言模型(LLM)的能力、工具设置与网站设计。同一个网站对人类与 AI 智能体,也可能提供截然不同的操作线索。2024 年发表于 ICLR 的 WebArena 研究揭示了这道鸿沟:在涵盖电商、论坛、代码协作与内容管理的 812 个多步骤仿真网站任务中,人类用户的端到端成功率高达 78.24%,而当时表现最佳的 GPT-4 Agent 成功率仅有 14.41%。
这组数据点出了“语义理解能力”与“环境操作能力”之间的结构性落差。当 AI 的角色从提供知识解答的搜索与对话引擎,演进为替人类处理购物、差旅、财务与系统管理的自主执行智能体(Autonomous Agent),数字产品的设计命题也随之改变:当用户不再亲自点击屏幕,该如何打造一个让 AI 智能体也能精准感知、获得授权、可靠执行并安全收尾的环境?这正是 Agent Experience(AX,智能体体验)诞生的核心背景。
UX、DX 与 AX:谁在使用网站?
要理解 AX 为何在此时浮出水面,可以先把它放回数字产品几十年来的体验演化脉络中。在早期的软件与网站时代,产品设计的核心是 User Experience(UX,用户体验),解决“人类感官与认知”如何与图形化界面(GUI)交互的问题,关注版面视觉动线、信息架构与操作直觉。随着软件走向平台化与云端化,企业开始通过 API、SDK 与命令行工具对外提供服务,Developer Experience(DX,开发者体验)应运而生;此时的用户变成了人类工程师,产品好坏取决于技术文档是否清晰、接口规格是否一致、错误信息是否便于调试,让工程师能写出确定性(Deterministic)的代码来对接系统。
进入生成式 AI 与智能体时代后,第三类用户出现了。2025 年 1 月,Netlify 首席执行官 Mathias Biilmann 在〈Introducing AX: Why Agent Experience Matters〉一文中,正式把体验设计的边界推向 Agent Experience(AX)。与人类直接操作界面(UX)或工程师预先写好对接逻辑(DX)不同,AI Agent 是一个在运行期(Runtime)动态感知环境、自主规划步骤并调用工具的概率性系统。当人类把任务委托给 AI,Agent 能否代表用户取得授权、读懂平台规则并完成操作,便直接影响该数字服务在 AI 生态中的采用率。
2026 年 10 月,Microsoft 首席开发者倡导者 Waldek Mastykarz 在〈What is Agent Experience (AX)?〉中,进一步把 AX 推进到可量化的工程检验,提出两大核心维度:Propensity(选择倾向),即当用户没有指定工具时,Agent 能否发现并倾向选择你的服务;以及 Efficacy(执行效能),即当 Agent 选定你的服务后,能否在合理的计算成本与步数内,调用正确且未淘汰的接口完成任务。
人类亲自操作依赖视觉动线与感官直觉
人类通过颜色对比、按钮阴影、鼠标悬停(Hover)状态与弹出提示理解画面;遇到异常时能凭常识自行变通。
工程师预先对接依赖技术文档与固定规格
开发者在产品上线前先读懂 API 规格、取得密钥并写成确定性(Deterministic)代码,运行期由固定逻辑处理。
AI 智能体动态执行依赖结构化线索与人机交接
Agent 在运行期(Runtime)根据一句目标动态找入口、选工具、填参数并验证状态;评估重心分成选择倾向(Propensity)与执行效能(Efficacy)。
为什么原本为人类打磨到极致的 UX,到了 Agent 手中却常常导致低下的 Efficacy?这个问题可以回到知觉心理学与设计学的底层理论中寻找答案。1979 年,心理学家 James J. Gibson 在《The Ecological Approach to Visual Perception》中提出 Affordance(可供性),意指环境相对于特定行动者所提供的行动可能性。一张及膝高的椅子对成年人具备“坐下”的可供性,对幼猫而言却是“躲藏”或“攀爬”的空间。可供性是“行动者能力”与“环境特征”交织出的关系,而不是物体单方面的客观属性。
1988 年,认知科学家 Don Norman 把这一概念引入设计领域,并在 2008 年〈Signifiers, Not Affordances〉与 2013 年修订版《设计心理学》中做出关键区分:Affordance 决定哪些行动在物理或系统上是可能的;Signifier(意符)则是环境释放给行动者、用来提示“操作方式与当前状态”的线索。一扇门具备被推开的可供性,但如果装上一个让人想往外拉的把手,错误的意符就会导致操作失败,成为经典的“诺曼门(Norman Door)”。
今天的互联网,对 AI Agent 而言到处都是诺曼门。人类依靠颜色对比、边框阴影、鼠标悬停时出现的手指光标,或是站台上聚集的人群,来判断“哪里可以点击”与“系统现在处于什么状态”。一旦行动者从人类换成 AI Agent,感知器官与执行工具彻底改变,原本为人类视觉与认知量身打造的 Signifier 随即失效;当 Agent 缺少浏览器操作权限或 API 授权时,连最基本的 Affordance(行动可能性)都不存在。AX 的核心任务,就是在行动者换成 AI 的前提下,重新对齐数字环境的“可供性”与“意符”。
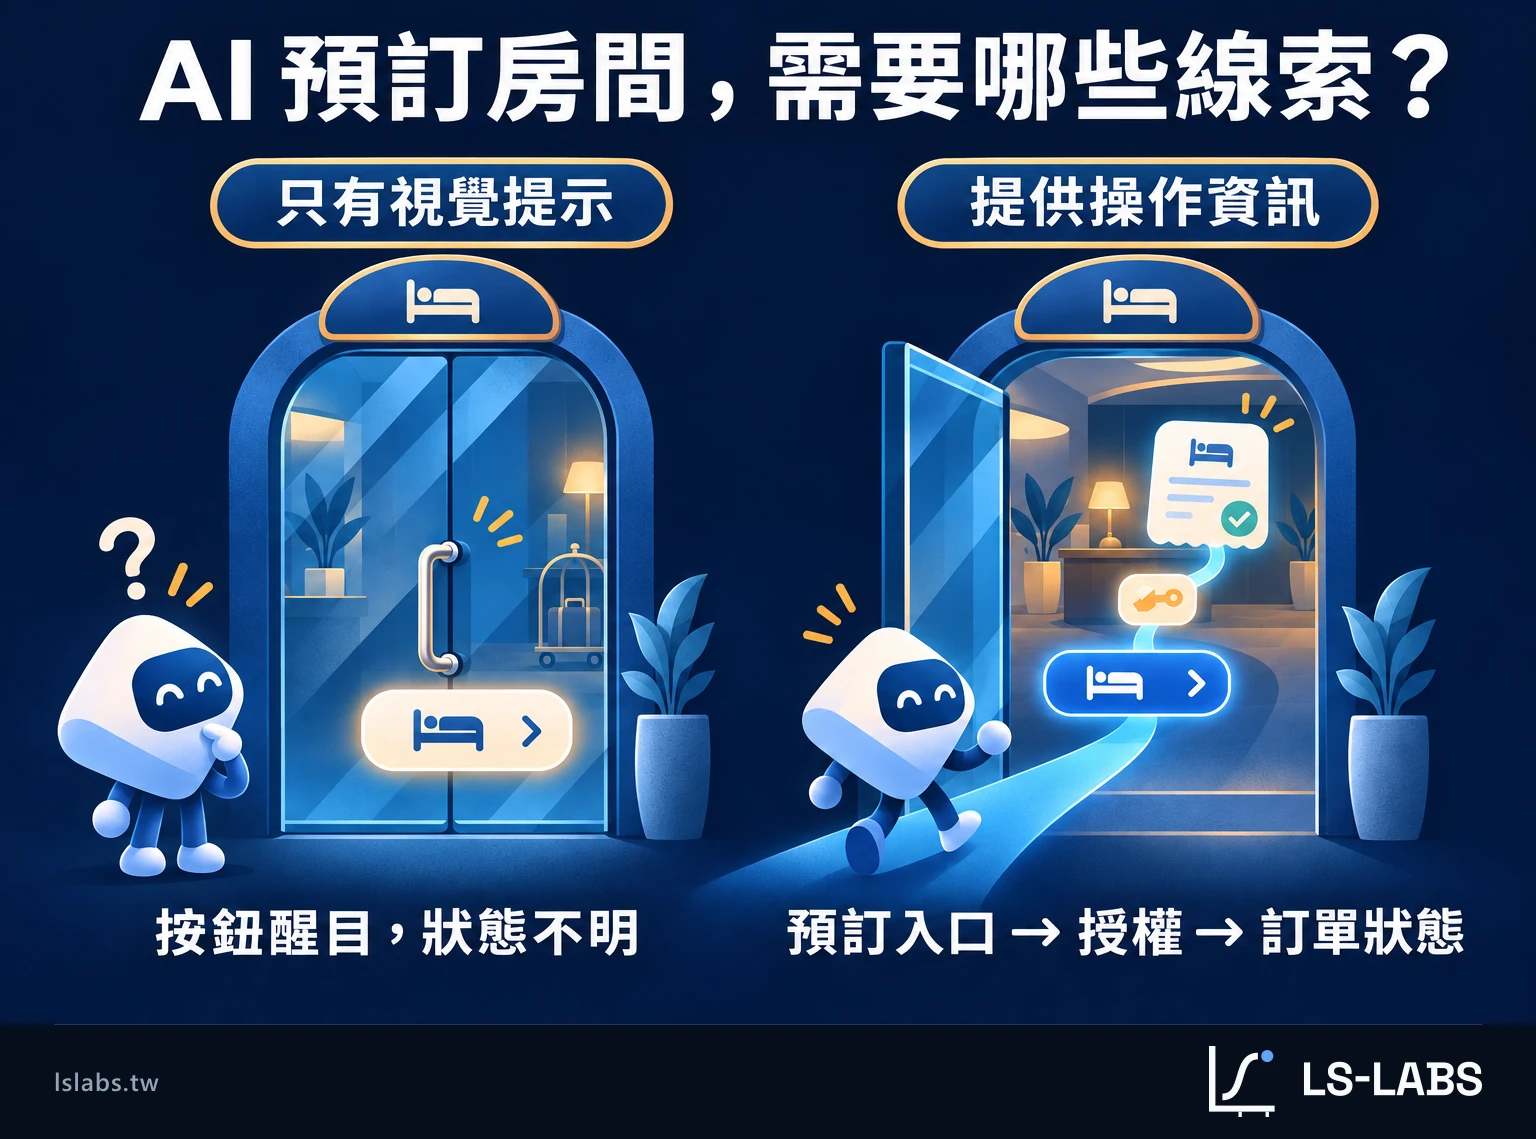
人类视角的界面线索(UX Signifiers)
<!-- 视觉上有渐变与阴影,但缺乏语义与状态反馈 -->
<div class="btn-gradient shadow-lg" onclick="submitOrder()">
  立即预订 →
</div>
<div class="toast-fade">处理中,请稍候...</div>- 操作线索:靠颜色渐变、阴影与光标变化暗示“可点击”。
- 状态感知:靠短暂浮现 2 秒的 Toast 弹窗或画面转圈动画判断进度。
- 权限验证:结账中途跳出图形验证码(CAPTCHA)或短信 OTP 窗口。
人类一眼就懂,对 AI 却是“数字诺曼门”
智能体视角的界面线索(AX Signifiers)
// 结构化语义、明确的参数边界与可查验的状态码
reserve_room({
  hotel_id: "tainan_sta_01",
  check_in: "2026-11-14",
  idempotency_key: "req_9f8a7b"
}) → { status: "PENDING_USER_CONFIRM", order_id: "ORD-8821" }- 操作线索:明确的
role="button"无障碍语义,或结构化的工具 Schema。 - 状态感知:返回机器可判读的
status、order_id与独立的查询端点。 - 权限验证:支持分级授权与人机交接(Handoff),在扣款前交回人类确认。
对齐 AI 的感知与执行能力,建立可验证的闭环
AI 操作网站的三种方式
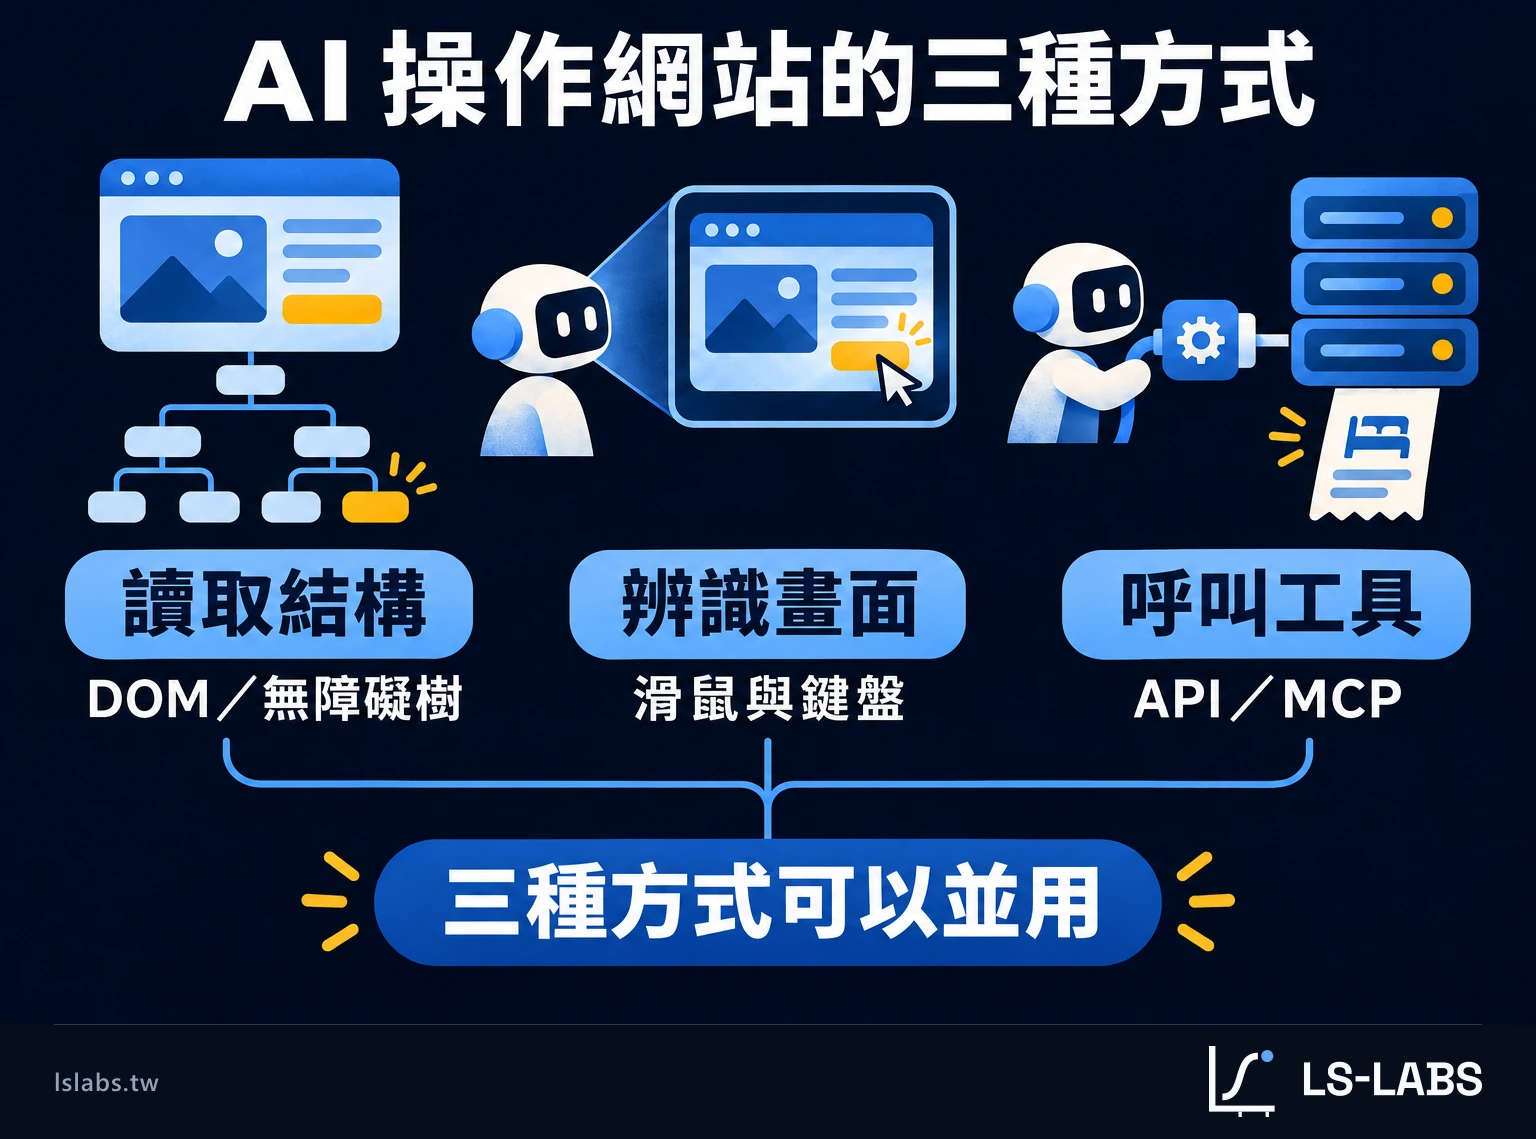
AI Agent 可以读取网页结构、识别画面,也可以直接调用工具。这三种方式可以并用,对网站提供的操作线索各有要求。
第一种是借道人类无障碍设计的“DOM 与无障碍树(Accessibility Tree)解析”。每个网页背后都有定义结构层级的 DOM,浏览器会依据 W3C 的可访问名称与描述规范(Accessible Name and Description Computation),把 HTML 语义与 ARIA 属性转译为供屏幕阅读器使用的无障碍树。像 WebArena 等早期浏览器 Agent,便是把网页转化为如 [1582] button "Add to Cart" 的结构化文本节点来决定操作对象。这条路径计算成本低且精准,但高度依赖前端工程的语义规范;一旦网站用没有替代文本的图片或纯 <div> 标签拼凑出视觉按钮,依赖无障碍树的 Agent 就会直接“失明”。
第二种是模拟人类感官的“视觉操作(Computer Use/GUI Agent)”。既然网页最初是画给人类看的,Anthropic 于 2024 年推出的 Claude Computer Use,以及 OpenAI 于 2025 年推出的 Operator 与 Computer-Using Agent(CUA),便选择直接截取屏幕画面,让多模态大模型通过视觉识别颜色、图标与版面位置,再驱动虚拟鼠标与键盘。2024 年的 WebVoyager 研究显示,结合视觉截图的 Agent 在测试环境中可达到 59.1% 的成功率,优于纯文本结构设置;OpenAI 在 2025 年 3 月公布的 CUA WebArena 成功率则为 58.1%。这与早期 GPT-4 Agent 的模型和执行设置不同,不能把差距全部归因于视觉操作。不过,坐标点击偏移、动态弹出窗口干扰,以及长流程下高昂的 Token 延迟与误判,仍让纯视觉路径难以承担高风险的商业交易。
第三种是专为智能体打造的“原生工具协议(API、MCP 与 WebMCP)”。与其让 Agent 在人类界面上猜按钮位置,不如直接向 Agent 暴露结构化的功能入口(如 create_booking(hotel_id, check_in, check_out, guests))。从早期的 Function Calling,到 Anthropic 于 2024 年 11 月开源的 Model Context Protocol(MCP),再到 2026 年 W3C 社区组推进的 WebMCP 规范草案(W3C Draft Community Group Report,尚非 W3C 标准,允许网页把前端 JavaScript 函数注册为 Agent 可调用的工具),数字产品正从“单一视觉界面”走向“人机双轨界面”。
| 操作方式 | Agent 依赖的核心意符(Signifier) | 技术代表与标准 | 核心瓶颈与失效风险 |
|---|---|---|---|
| 结构解析(DOM/无障碍树) | 组件角色(Role)、可访问名称、DOM 层级与状态属性 | W3C ARIA 规范、WebArena 基础架构 | 前端缺少语义标签、动态渲染元素命名不清导致漏判 |
| 视觉模拟(Computer Use) | 按钮文字、图标外观、空间相对位置、画面视觉变化 | Claude Computer Use、OpenAI CUA、WebVoyager | 坐标定位偏移、弹窗遮挡、异步加载状态混淆、高延迟成本 |
| 原生工具调用(API/MCP) | 工具名称、语义化功能描述、JSON Schema 参数、返回结构 | Function Calling、Anthropic MCP、W3C WebMCP 社区组草案 | 工具描述有歧义、跨系统授权断裂、后端状态返回不完整 |
许多企业常有一种期待:“只要未来模型能力继续变强,或者把所有界面都改成机器格式,AX 问题就会自然消失。”但实证研究与工程测试给出了相反的提醒。
一方面,模型单次成功不代表商业上的可靠。2024 年模拟零售与客服交互的 τ-bench 研究(arXiv 预印本)引入了 passk 指标,用来衡量同一任务连续执行 k 次都成功的概率。研究发现,当时顶尖模型在零售任务中的单次成功率(pass1)虽接近五成,但连续执行 8 次都成功的 pass8 却跌破 25%。在涉及资金流与订单的商业环境中,这种不稳定性足以造成严重投诉与账务损失。
Microsoft 在 2026 年分享的 AX 测试也显示,看似方便 Agent 的改动未必有用。在该次 CLI 部署测试中,改用 JSON 输入后,各模型的单次任务成本变成原来的 4~11 倍;Claude Haiku 4.5 的成功次数从 5 次全对降为 2 次。在另一个 SharePoint Framework 升级测试中,明确要求 Agent 使用 CLI,让通过的配置检查从 30/80 增至 75/80。团队随后修改 Agent 会读取的 Release Notes,观察到每次运行都会主动使用 CLI。这是不同干预的结果,且只适用于文中测试的任务与设置。
为什么“等模型变强”或“硬塞机器格式”无法自动解决 AX?三组实证数据对照
环境操作落差仿真网站多步骤基准(Zhou et al., 2024;OpenAI, 2025)人类用户端到端成功率达 78.24%,早期 GPT-4 Agent 仅 14.41%。OpenAI 在 2025 年另行公布 CUA 的结果为 58.1%;两次评测的模型与执行设置不同,不能只用界面差异来解释。
多轮执行稳定度零售与客服交互基准(Yao et al., 2024,arXiv 预印本)衡量连续执行
k 次都成功的 passk 指标显示:模型在零售场景单次成功率(pass1)虽接近 50%,但连续 8 次都成功的 pass8 却低于 25%。偶尔成功不等于生产环境可靠。认知对齐 vs. 拖累CLI 与升级任务实验(Mastykarz, 2026)✕ 负向拖累(Drag):该次 CLI 测试改用 JSON 输入后,单次任务成本变成 4~11 倍;Haiku 4.5 的成功次数由 5/5 降为 2/5。
✓ 正向提升(Lift):明确要求使用 CLI 后,配置检查通过数由 30/80 增至 75/80;后续修改 Release Notes 的观察结果是每次都主动选用 CLI。
一次订房,要确认四件事
跳出单纯的“界面读取”、从端到端任务执行的视角审视 AX,就会发现“找到按钮或调用 API”只是起点。Don Norman 曾以“火车站台”为例说明状态意符的重要性:当你冲上站台却没看到火车时,你是根据站台上“是否还有大批候车人群”来推断火车是还没来、还是已经开走。同理,当 Agent 提交订房请求后,如果系统只返回一句含糊的“处理完成”,或仅在画面上闪过一个 Toast 提示,Agent 就无法确认订单是否真正写入数据库。因此,成熟的 AX 需要涵盖从“感知”到“状态验证与异常恢复”的完整生命周期。
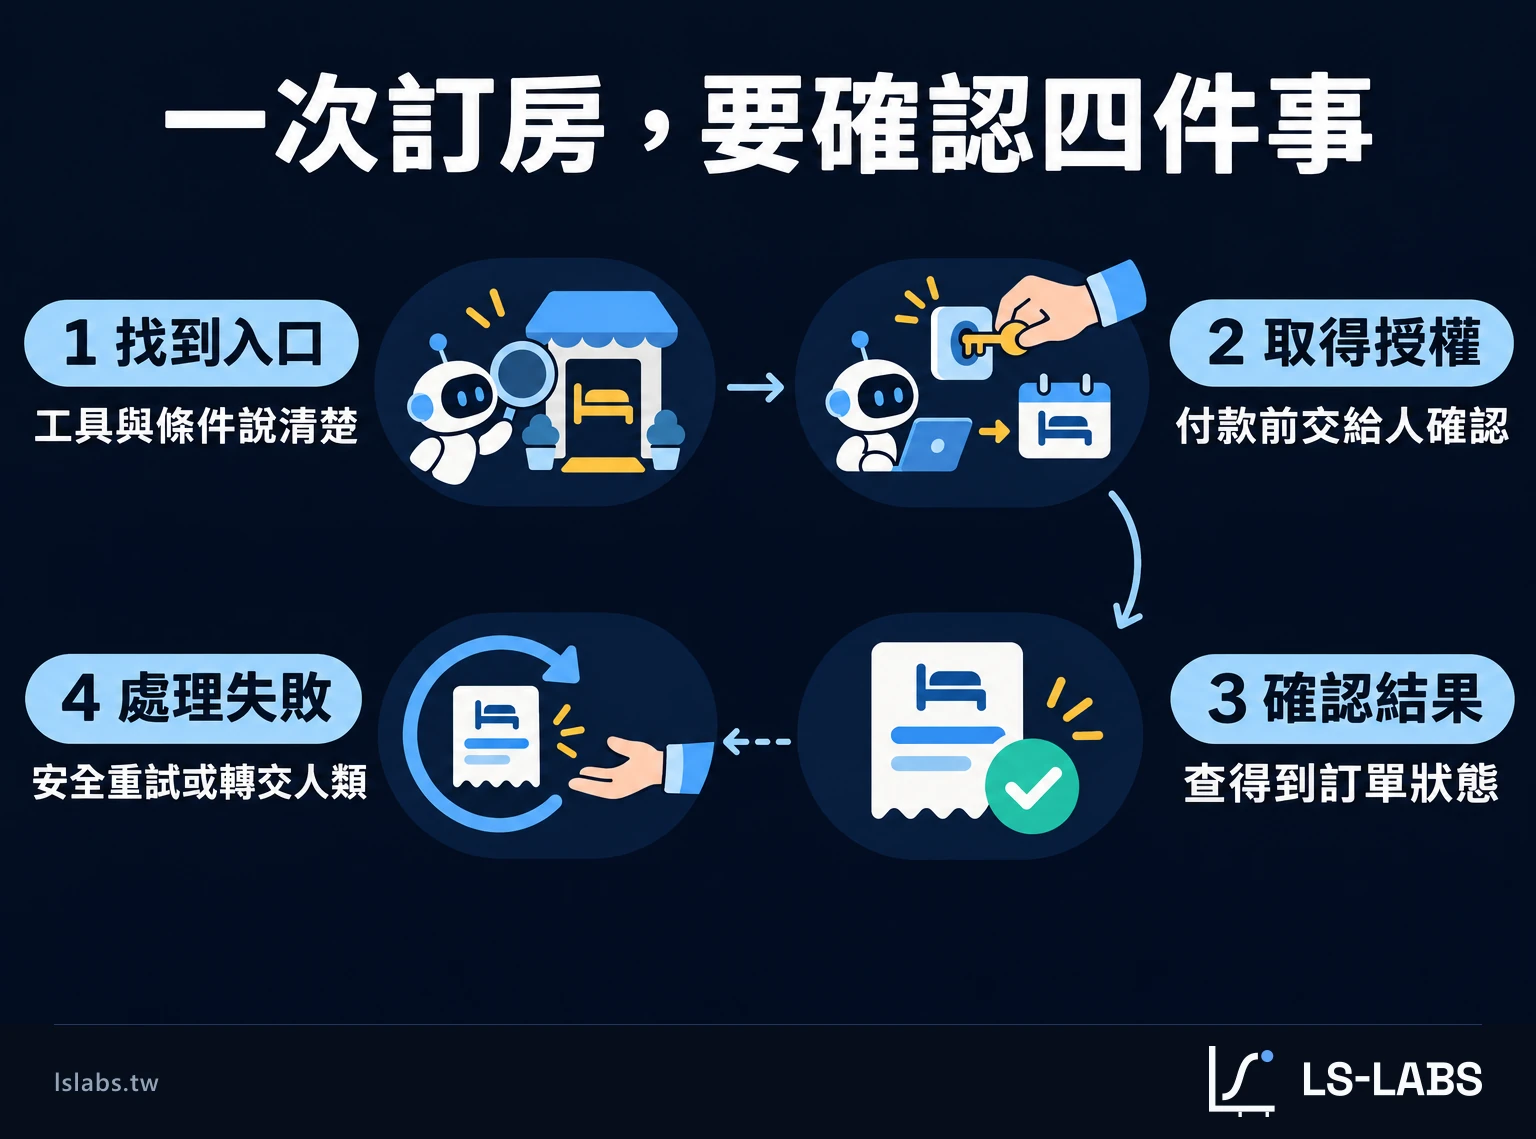
结合 Gibson 的可供性理论、Norman 的意符概念与当代 Agent 实证研究,本站在实务检视时采用的操作定义是:Agent Experience(AX)指当 AI Agent 代表人类执行任务时,数字产品环境能让其识别可用功能、在授权边界内执行操作、验证真实系统状态,并在异常发生时安全恢复或转交人类的闭环程度。本文把这套“AX 任务闭环”拆解为四项核心条件,并直接对应到企业的产品防呆设计与量化评估指标(此四阶段闭环为本站整理的操作检视框架,LS-Labs 目前尚未发布针对 AX 任务完成率的受控实验数据):
| 闭环阶段 | 理论与技术基础 | 实务场景设计(以订房平台为例) | 企业观测与评估指标 |
|---|---|---|---|
| 1. 可发现(Discoverable) | Signifier、语义明确性、Propensity(这一层与 TSO 工具选择优化直接衔接) | 清楚定义工具边界,避免使用含糊的 execute(),改用明确描述参数与前置条件的查询/预订接口 | 功能识别率、正确工具选择率、无效探索步数 |
| 2. 可执行(Executable) | Affordance、最小权限授权、人机协同 | 支持分层授权:允许 Agent 自主查价与锁房,但涉及实际扣款与不可退订条款时触发人类确认机制 | 授权后操作成功率、权限阻碍率、单次任务 Token 成本 |
| 3. 可验证(Verifiable) | 状态意符(State Feedback)、结果导向验证 | 明确返回结构化状态码、订单编号与处理阶段(区分“已提交”与“已确认”),并提供独立的状态查询入口供二次核验 | 结果验证准确率、状态误判率(False Positive/Negative) |
| 4. 可恢复(Recoverable) | 容错设计、幂等性(Idempotency)、安全停止 | 网络中断或超时后,支持带幂等键(Idempotency Key)的安全重试,或返回可解析的错误原因与修复建议以交还人类 | 错误恢复率、重复下单率、高风险异常安全停止率 |
对企业而言,这套四阶段闭环可以直接转化为工程团队的 Baseline 与 Lift/Drag(提升与拖累)测试流程。企业不需要凭空猜测哪种设计对 AI 更友好,而可以通过四个步骤建立受控的实证循环:
怎么测试 AX 改动有没有用?
挑出最关键的用户托付场景(例如:查询指定日期与预算的空房、核对取消政策、创建预订、修改入住人信息),明确定义什么状态才算“任务成功收尾”。
固定模型版本、工具配置与初始数据状态,让 Agent 重复执行多次。同时记录单次成功率、连续成功的
passk 稳定度、平均步数、Token 消耗与第一个中断点。针对基准测试发现的断点做单一修改,例如为结账按钮补齐 ARIA 语义、在 API 错误返回中加入 RFC 9457 结构化问题详情,或调整工具参数说明。
若任务成功率与
passk 提升、步数与 Token 成本下降,即为正向的 Lift(提升);若像 Microsoft 的 JSON 实验一样导致成本暴增或破坏既有流程,即为应舍弃的 Drag(拖累)。通过这种控制变量的实证循环,产品与工程团队才能区分“哪些失败源于底层模型的能力极限”,以及“哪些失败是产品自身缺少清晰意符与状态返回所筑起的高墙”。
GEO、TSO 与 AX 的分工
当 AI Agent 介入消费者的信息获取与交易决策,企业最常问的战略问题是:“AX 会成为下一个 SEO 或 GEO 吗?”要回答这个问题,可以把用户旅程拆解为从“信息探索”到“工具选用与任务完成”的完整漏斗,厘清各阶段的职责分工。
过去几年备受关注的 GEO(Generative Engine Optimization,生成式引擎优化),核心战场在于漏斗上半场(Discovery & Citation):当用户向 AI 询问“下周末台南火车站附近推荐哪间双人房?”时,品牌如何通过结构化数据、内容权威度与外部引用来源,让语言模型在生成答案时把自己纳入推荐名单,对应 Microsoft 框架中的前端 Propensity(选择倾向)。当用户接着说出“好,帮我查第一间今晚有没有空房并预订”时,流程先经过 TSO(工具选择优化)决定哪个订房工具或 API 被选中,随即进入漏斗下半场(Execution & Transaction),由 AX(智能体体验)接管,解决从授权、执行、验证到异常恢复的 Efficacy(执行效能)问题。
只有 GEO、缺乏 AX 的“推荐断头路”
- 前端表现:品牌内容常被 ChatGPT、Perplexity 或 Google AI 模式引用并推荐(高 Propensity)。
- 执行断点:用户要求 Agent 代为预订时,网站因没有语义按钮、强制前置验证码或状态返回不明而卡死(低 Efficacy)。
- 长期后果:消费者被迫手动重来,甚至转向能由 Agent 直接完成预订的竞争对手平台。
诊断:赢了对话曝光,却在最后一公里流失转化
只有 AX、缺乏 GEO/TSO 的“深巷好店”
- 后端表现:平台提供完善的 API/MCP 接口、幂等重试机制与清楚的订位回执(高 Efficacy)。
- 曝光断点:缺乏可公开检索的品牌内容、评价锚点与清晰的工具描述,模型在回答与工具检索阶段根本想不到它(低 Propensity)。
- 长期后果:即使内部交易动线再顺畅,也难以进入 AI 智能体的第一轮候选清单。
诊断:具备执行闭环,但缺乏前端发现与路由入口
换句话说,GEO、TSO 与 AX 共同构成了 AI 时代的商业转化漏斗。只有 GEO 而没有 AX 的品牌,会成为“AI 经常推荐、却无法帮忙结账”的断头路;只有 AX 而没有 GEO 与 TSO 的产品,则像是一家动线顺畅却藏在深巷里的商店,连进入 Agent 候选清单的机会都没有。
不过,拥抱 AX 并不代表企业应该毫无保留地向 AI 敞开大门,也不代表要为了机器而牺牲人类。2025 年开发者 Jim Nielsen 在〈AX, DX, UX〉中提出反思:当企业资源有限时,过度迎合 AI Agent 是否会导致人类用户的体验降级?事实上,健康的产品架构不必把 UX 与 AX 视为零和博弈。清晰的组件语义、明确的状态反馈与结构化的错误提示,本身就是优质 UX 与无障碍设计(Accessibility)的基础,能同时让视障辅助工具、普通人类与 AI Agent 受益。
真正需要刻意区隔并建立防线的,是商业利益与安全边界。向外部 Agent 开放高效率的操作通道,会伴随账号劫持、自动化滥用与新型网络安全威胁。例如 2026 年 W3C WebMCP 社区组草案便明确把“提示词注入(Prompt Injection)”、“工具描述投毒(Tool Poisoning)”与“高风险操作意图误判”列为核心安全风险(亦可参见本站在〈摩根大通开始封锁 AI 智能体?〉与〈你的网站准备好让 AI 智能体下单了吗?〉中的讨论)。一个被恶意网页提示词污染的 Agent,可能会在用户不知情的情况下调用已授权平台的转账或下单功能。
因此,成熟的 AX 设计追求的从来不是“百分之百无摩擦的全自动”,而是在“可执行”与“可恢复”阶段植入明确的治理防线:包括细分操作范围的 OAuth 授权、交易金额与敏感操作的强制人类确认(Human-in-the-Loop),以及防止 Agent 失控重试的速率限制与幂等保护。
从 1979 年 Gibson 笔下那张因行动者而异的椅子,到 2026 年穿梭于 DOM、视觉画面与 MCP 协议之间的 AI Agent,界面设计的底层逻辑始终围绕着“行动者与环境的匹配”。在 UX 的时代,产品团队追问的是产品对人类而言是否直观好用;在 AI 成为人类数字代理的时代,AX 则向所有产品经营者抛出了一个更务实的商业问题:当你的顾客把任务交给 AI 时,你的产品,能让它把事情安全、可靠地办完吗?
参考文献
设计理论与学术研究
- Gibson, J. J. (1979). The Ecological Approach to Visual Perception. Houghton Mifflin.
- Norman, D. A. (2008). Signifiers, Not Affordances. Interactions, 15(6), 18–19. doi:10.1145/1409040.1409044
- Norman, D. A. (2013). The Design of Everyday Things: Revised and Expanded Edition. Basic Books.
- Deng, X., Gu, Y., Zheng, B., Chen, S., Stevens, S., Wang, B., Sun, H., & Su, Y. (2023). Mind2Web: Towards a Generalist Agent for the Web. NeurIPS 2023. arXiv:2306.06070
- Zhou, S., Xu, F. F., Zhu, H., Zhou, X., Lo, R., Sridhar, A., Cheng, X., Ou, T., Bisk, Y., Fried, D., Alon, U., & Neubig, G. (2024). WebArena: A Realistic Web Environment for Building Autonomous Agents. ICLR 2024. arXiv:2307.13854
- He, H., Yao, W., Ma, K., Yu, W., Dai, Y., Zhang, H., Lan, Z., & Yu, D. (2024). WebVoyager: Building an End-to-End Web Agent with Large Multimodal Models. ACL 2024. arXiv:2401.13919
- Xie, T., et al. (2024). OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. NeurIPS 2024. arXiv:2404.07972
- Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv 预印本. arXiv:2406.12045
官方技术规范与行业论述
- W3C (2018). Accessible Name and Description Computation 1.1. w3.org
- Anthropic (2024, November 25). Introducing the Model Context Protocol. anthropic.com
- Biilmann, M. (2025, January 28). Introducing AX: Why Agent Experience Matters. biilmann.blog
- Nielsen, J. (2025, March 2). AX, DX, UX. blog.jim-nielsen.com
- OpenAI (2025, March 11). New tools for building agents (Computer-Using Agent). openai.com
- Mastykarz, W. (2026, October 6). What is Agent Experience (AX)? Microsoft for Developers. developer.microsoft.com
- W3C Web Machine Learning Community Group (2026, November 2). WebMCP — Draft Community Group Report(W3C 社区组草案). webmachinelearning.github.io