文章目录文章开头0%
一、两段没有相同关键词的文字,为什么可能指向同一件事?
假设有人问 ChatGPT:“我要怎么提高网站内容被 AI 回答采用的机会?”
网上有两段文字。第一段写着:“生成式引擎优化(GEO)着重于提升内容在生成答案中的可见度。”第二段则说:“想让聊天机器人在回答问题时引用你的文章,除了让信息容易被检索,也要提供足以支撑答案的证据。”
两段文字几乎没有重复的核心词汇,讨论的却是同一个问题。反过来看,另一篇文章就算密集出现“GEO”“ChatGPT”“AI 搜索”等字眼,内文也可能只是在综述行业规模,完全没有回答网站运营者该从何下手。
这正是理解语义检索(Semantic Retrieval)的起点:一段内容能不能被找出来,除了看它与查询共享多少字面词汇,也看检索系统能否判断两者在语义上是否相关。但这并不代表传统关键词检索已经退场,更不能据此推论所有 AI 搜索都只靠向量运作。
把问题再往后推一步,真正的落差才会浮现。即使一篇文章顺利通过检索、进入候选名单,它也未必会被放进 AI 的最终回答;就算模型真的采用了文章里的信息,回答下方也未必会附上正确的来源链接。本文想拆开的,正是从“语义相近”走到“被引用”之间那段经常被简化的距离。
二、Embedding 如何把文字转成向量?
把文字放进一个可计算方向的坐标系
在数学上,向量可以理解成一组有顺序的数字。文本嵌入模型(Embedding Model)会把句子、段落或整份文档映射成高维向量,让模型在特定训练目标下学到的语义关联,转化为坐标空间里的几何关系。
为了直观理解,可以先将数百至数千维的向量压缩成一张二维平面图:每一段文字都是一支从原点射出的箭头;当某段内容的箭头方向与用户问题越接近,代表在该模型的表征空间里,两者对应的语义关系越紧密。
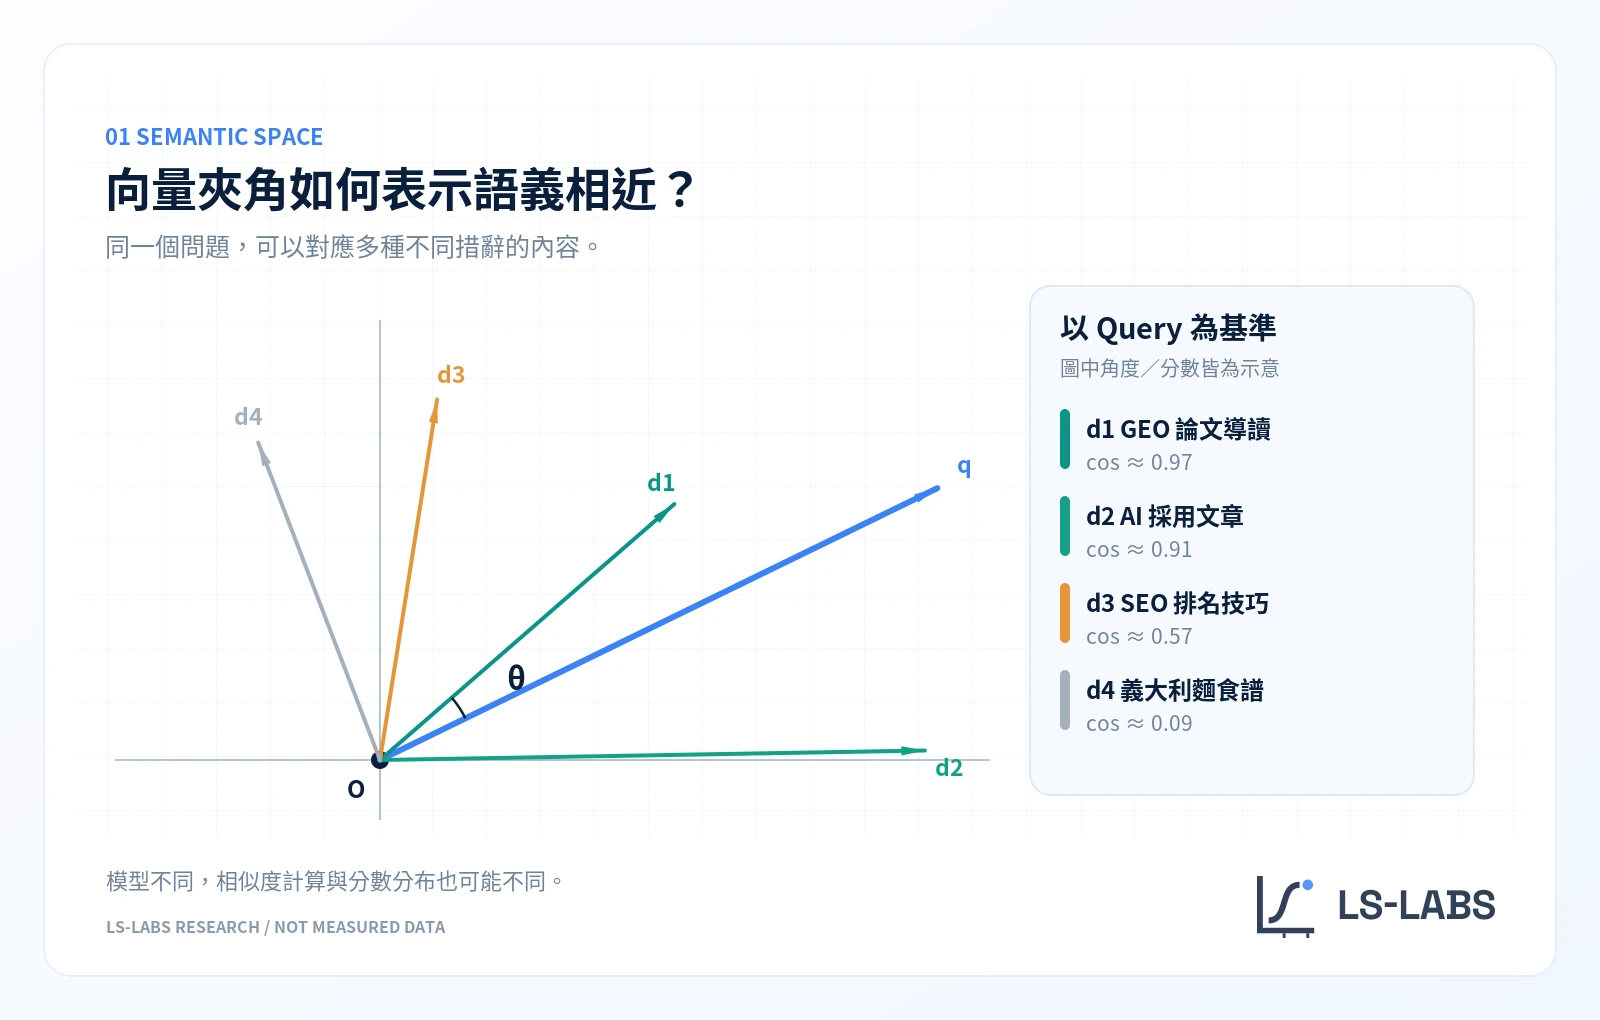
衡量两支向量方向有多接近,最常见的指标是余弦相似度(Cosine Similarity):
余弦相似度公式:cos(θ) = (q · d) / (‖q‖ × ‖d‖)
其中 q 为查询向量,d 为内容向量,分子 q · d 为两向量的内积,分母 ‖q‖ × ‖d‖ 为两向量长度的乘积。夹角 θ 越小,cos(θ) 越接近 1;夹角 90° 时等于 0;方向完全相反(180°)时等于 -1。
阅读这个公式时要格外小心:它是几何定义,不能直接翻译成“1 分代表同义、0 分代表无关、-1 分代表反义”。举例来说,“这家餐厅很好吃”与“这家餐厅很难吃”评价截然相反,却同样围绕餐厅与餐品体验,在许多语义嵌入模型里依然会落在相当接近的位置。语义接近不等于立场一致,更不等于事实正确。
为什么把文字变成数字,不会自动产生“语义”?
让向量之间的距离真正反映句子层级的语义相似,本身就是自然语言处理的重要研究课题。2019 年发表于 EMNLP 的 Sentence-BERT(SBERT)论文发现,若直接把未经句向量微调的原生 BERT 输出拿来取平均或取 [CLS] 向量,在语义相似度基准测试上的表现甚至不如传统的 GloVe 词向量。研究团队因此采用孪生与三元组网络架构重新训练句向量,让两段文字能各自独立编码,再以余弦相似度快速比对(Reimers & Gurevych, 2019)。
该论文提供了一组经典的计算成本对照:在单张 NVIDIA V100 GPU 上,若要从 10,000 个句子中找出最相似的一对,传统逐对送入 BERT cross-encoder 的做法需要执行 49,995,000 次推理,耗时约 65 小时;改用 Sentence-BERT 预先算出句向量并比对余弦相似度,总时间缩短到约 5 秒。正是因为文档向量能够离线预先计算并建立索引,语义比对才得以从昂贵的两两推理,走入可规模化的在线检索。
另一个实践中常被忽略的限制是:向量分数无法跨模型直接比较。不同 Embedding 模型的训练数据、损失函数与维度分布各异;Ethayarajh(2019)针对 BERT、ELMo 与 GPT-2 的分析更指出,这类上下文表征往往挤在高维空间的狭窄锥形区域内,呈现高度各向异性(Anisotropy),导致随机两个无关词汇的余弦相似度也可能远高于 0。因此,市面上偶尔流传“只要段落与问题的 cosine 大于 0.8 就容易被 AI 引用”的说法,在科学上并不存在跨平台通用的门槛。
三、语义相近,如何变成一条搜索结果?
Dense Retrieval 与关键词检索的互补边界
在信息检索(Information Retrieval)领域,稠密检索(Dense Retrieval)会将用户查询与庞大的文档段落库映射到同一个向量空间,再通过近似最近邻搜索(ANN)快速召回最接近的前 K 个候选段落(Top-K)。
2020 年发表于 EMNLP 的 Dense Passage Retrieval(DPR)是这条路线的代表作(Karpukhin et al., 2020)。DPR 使用双编码器分别处理问题与约 2,100 万个 100 字维基百科段落,并以向量内积(dot product)作为默认相关性函数。只有在所有向量都先归一化为单位长度的前提下,内积才会等同于余弦相似度;换言之,夹角图解有助于建立直觉,却不能当成所有检索系统唯一的底层公式。
更值得营销与内容研究者留意的是 DPR 与传统关键词检索 BM25 的正反对照:在由真实搜索提问构成的 Natural Questions 数据集中,前 20 个召回段落包含答案的比例(Top-20 召回率),DPR 达到 78.4%,明显高于 BM25 的 59.1%;然而在提问者高度沿用原文词汇的 SQuAD 数据集上,BM25(68.8%)反而优于未针对该数据集微调的 DPR(63.2%),结合两者的混合检索则进一步拉高整体表现(Karpukhin et al., 2020)。
这组数据直接打破了“有了向量检索就不再需要关键词”的迷思。稠密检索擅长跨越同义改写与口语提问,稀疏关键词检索则在专有名词、品牌名称、产品型号与法规条号上保有精准优势。现代搜索系统普遍结合两者,谈 GEO 并不需要把 SEO 积累至今的词汇与实体基础推翻。
AI 搜索面对的往往是一组展开后的子问题
传统搜索多半直接拿用户输入的字符串去比对索引;生成式搜索则常在检索前多做一步查询改写与拆解。Google Search Central 在说明 AI 概览(AI Overviews)与 AI 模式(AI Mode)时明确提到查询扩展(Query fan-out)机制:系统会将复杂提问拆解并同时发出多个相关子查询,横跨不同子主题与数据来源取回更广泛的网页链接(Google Search Central, n.d.)。OpenAI 对 ChatGPT Search 的技术说明同样指出,模型会依对话上下文将用户问题改写为一个或多个针对性搜索查询。
举例来说,当用户问“如何衡量 GEO 成效?”,背后展开的检索方向可能涵盖“AI 搜索引用率怎么计算”、“品牌提及与来源链接有何差别”、“不同模型回答波动如何重复抽样”。这三个子问题为教学举例,但足以说明一件事:一篇只反复堆砌“GEO 成效”四个字、却未分别解答指标定义与抽样限制的文章,很难在多路子查询中同时提供有效支撑。
Chunking 的迷思:不必为了 AI 把文章切得支离破碎
由于向量数据库实现时常把长文切成固定或语义段落(Chunk)建立索引,坊间一度衍生出“为了做 GEO,每段文字都必须写成短短几句的独立碎片”的教条。这其实把特定开发框架的工程默认设置,误当成了所有商用搜索引擎的写作规定。
Google 在 2026 年发布的官方文档〈针对 Google 搜索的生成式 AI 功能进行网站优化〉中直接澄清:网站运营者不需要为了迎合生成式 AI 而刻意将内容切成细碎片段(chunking),搜索系统本来就能理解同一页面里涵盖的多个相关子题(Google Search Central, 2026)。真正兼顾人类阅读与机器检索的做法,是让每个章节具备清楚的小标题、明确的先行结论与完整的上下文脉络。
四、从提问到引用,中间经过哪五道关卡?
理解了向量与混合检索,只走到一半。2020 年发表于 NeurIPS 的 Retrieval-Augmented Generation(RAG)论文奠定了“先由检索器取回外部文档,再交由生成模型综合产出回答”的经典范式(Lewis et al., 2020)。到了今天的商用 AI 搜索,系统往往还会叠加多轮查询、质量信号筛选与事后引用对齐。下图整理出五道核心概念关卡,帮助定位内容究竟在哪一步流失(各平台的实际工程架构可能合并、反复迭代或省略部分环节):
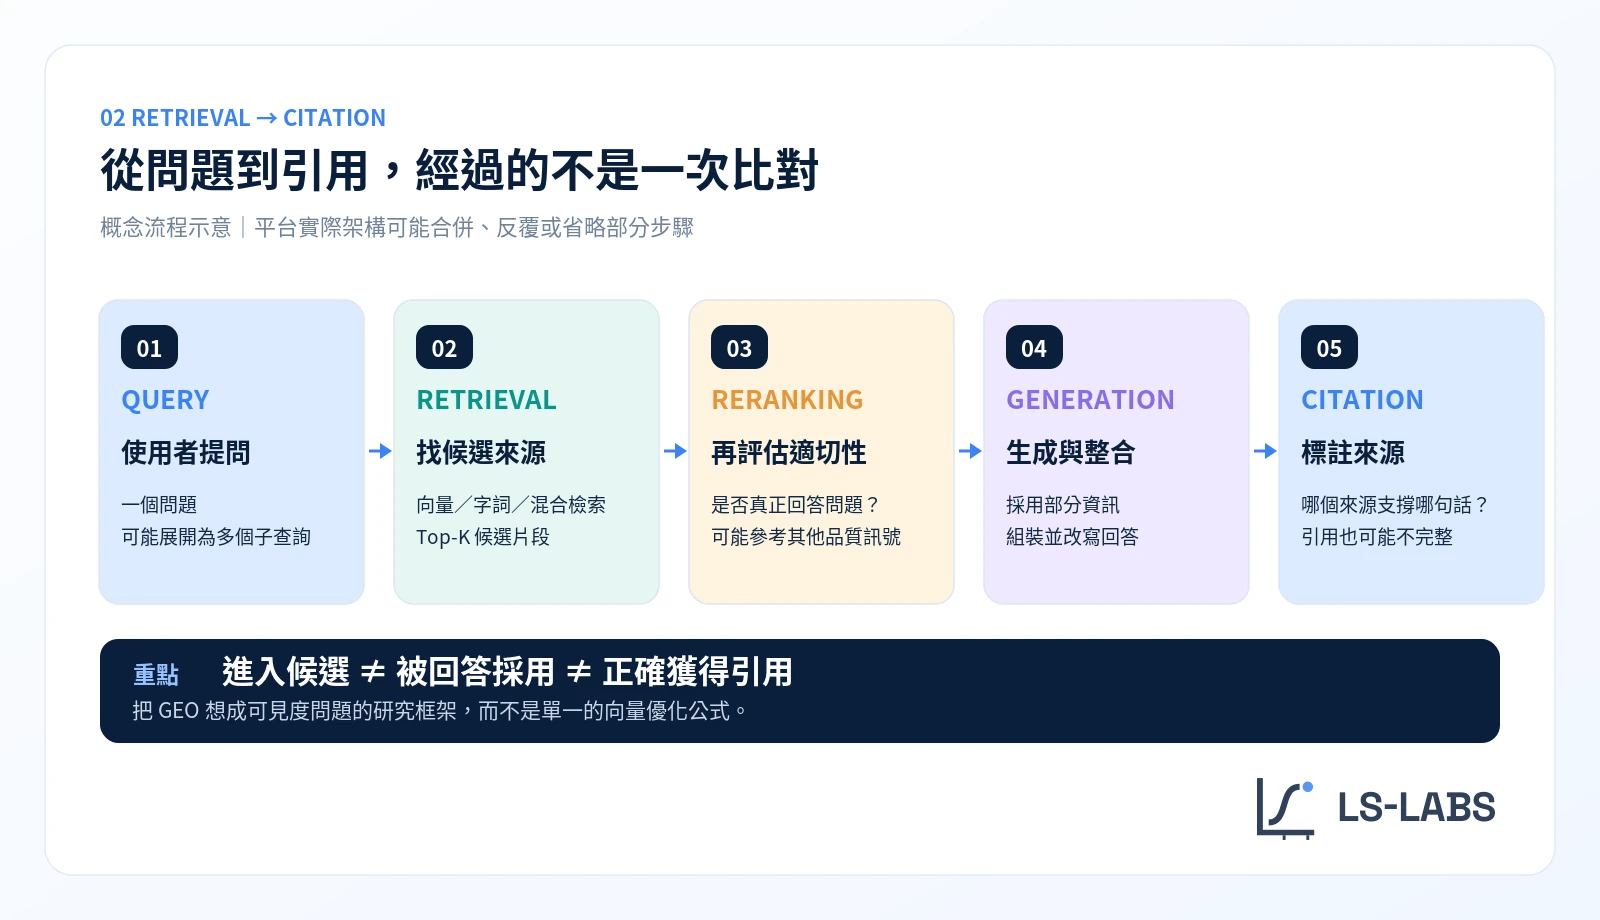
- 查询展开(Query):系统解析对话意图,将口语问题改写或拆解为一个或多个搜索子查询。若提问本身不需外部实时数据,模型甚至可能不触发网页检索,直接依参数记忆作答。
- 候选检索(Retrieval):检索器通过词汇匹配、向量相似度或混合索引,从可访问的网页库召回一批 Top-K 候选片段。页面若遭到封锁、未被编入索引,或内容与所有子查询都缺乏关联,就会在这一关出局。
- 重排序(Re-ranking):第一轮召回追求速度,难免混入“主题擦边但未正面解答”的段落。信息检索系统常在召回后引入精细但计算成本较高的交叉编码器(Cross-encoder),或采用如 ColBERT 这类保留词元层级延迟交互(Late Interaction)的模型重新评分(Khattab & Zaharia, 2020),同时也可能纳入网站权威度与时效性等信号。例如面对“GEO 怎么测量”,一篇详列指标定义与抽样设计的文章,通常比泛谈“GEO 趋势有多重要”的概论更有机会在重排序阶段胜出。
- 生成与整合(Generation):进入模型上下文窗口的数十个段落,并不会被平均采用。大语言模型会挑选能直接支撑论点的事实、数据与定义,将多份来源压缩、改写并组装成一段通顺的回答。
- 标注来源(Citation):系统在回答句尾或来源栏附上链接。值得注意的是,界面显示的引用清单未必与模型生成时实际依赖的段落一一对应;有些句子融合了多处信息却只挂上单一链接,有些链接甚至是在回答生成后才匹配补上。
把这五道关卡摊开,整篇文章最核心的诊断原则便一目了然:进入检索候选、被答案实质采用、以及获得正确的引用标注,是三件必须分开观察的结果。
五、KDD 2024 的 GEO 论文真正证明了什么?
既然进入候选池不保证被采用,修改网页本身的写法,究竟能不能改变它在生成答案里的可见度?
普林斯顿大学、印度理工学院德里分校与 Allen AI 等机构学者于 KDD 2024 发表的开创性论文〈GEO: Generative Engine Optimization〉,首次为这个问题建立了系统化的实验基准(Aggarwal et al., 2024)。研究团队构建包含 10,000 条多元查询的 GEO-bench,先对每道问题固定取回 Google 搜索前五条网页来源,再交由 GPT-3.5-turbo 依据这五份来源生成附带行内引用的回答;实验每次仅对其中一份目标来源施加特定的内容改写策略,借此比较改写前后该来源在回答中的可见度变化。
读懂这项实验设计的边界非常关键:因为五条输入来源已经预先固定,这篇论文测试的是“候选内容在生成与引用阶段被采用的程度”,并没有测试“改写能否让网页在 Google 或检索器里排名上升”,更不能直接类推为今天所有商用模型都按固定比例加分。
论文的主观与客观评估中,最常被引用的是字数与位置加权指标 Position-Adjusted Word Count(综合计算引用句占回答字数的比例,并赋予越靠前的句子越高权重)。图 3 与表 1 整理了论文 arXiv v3 版本表 1 的核心结果:
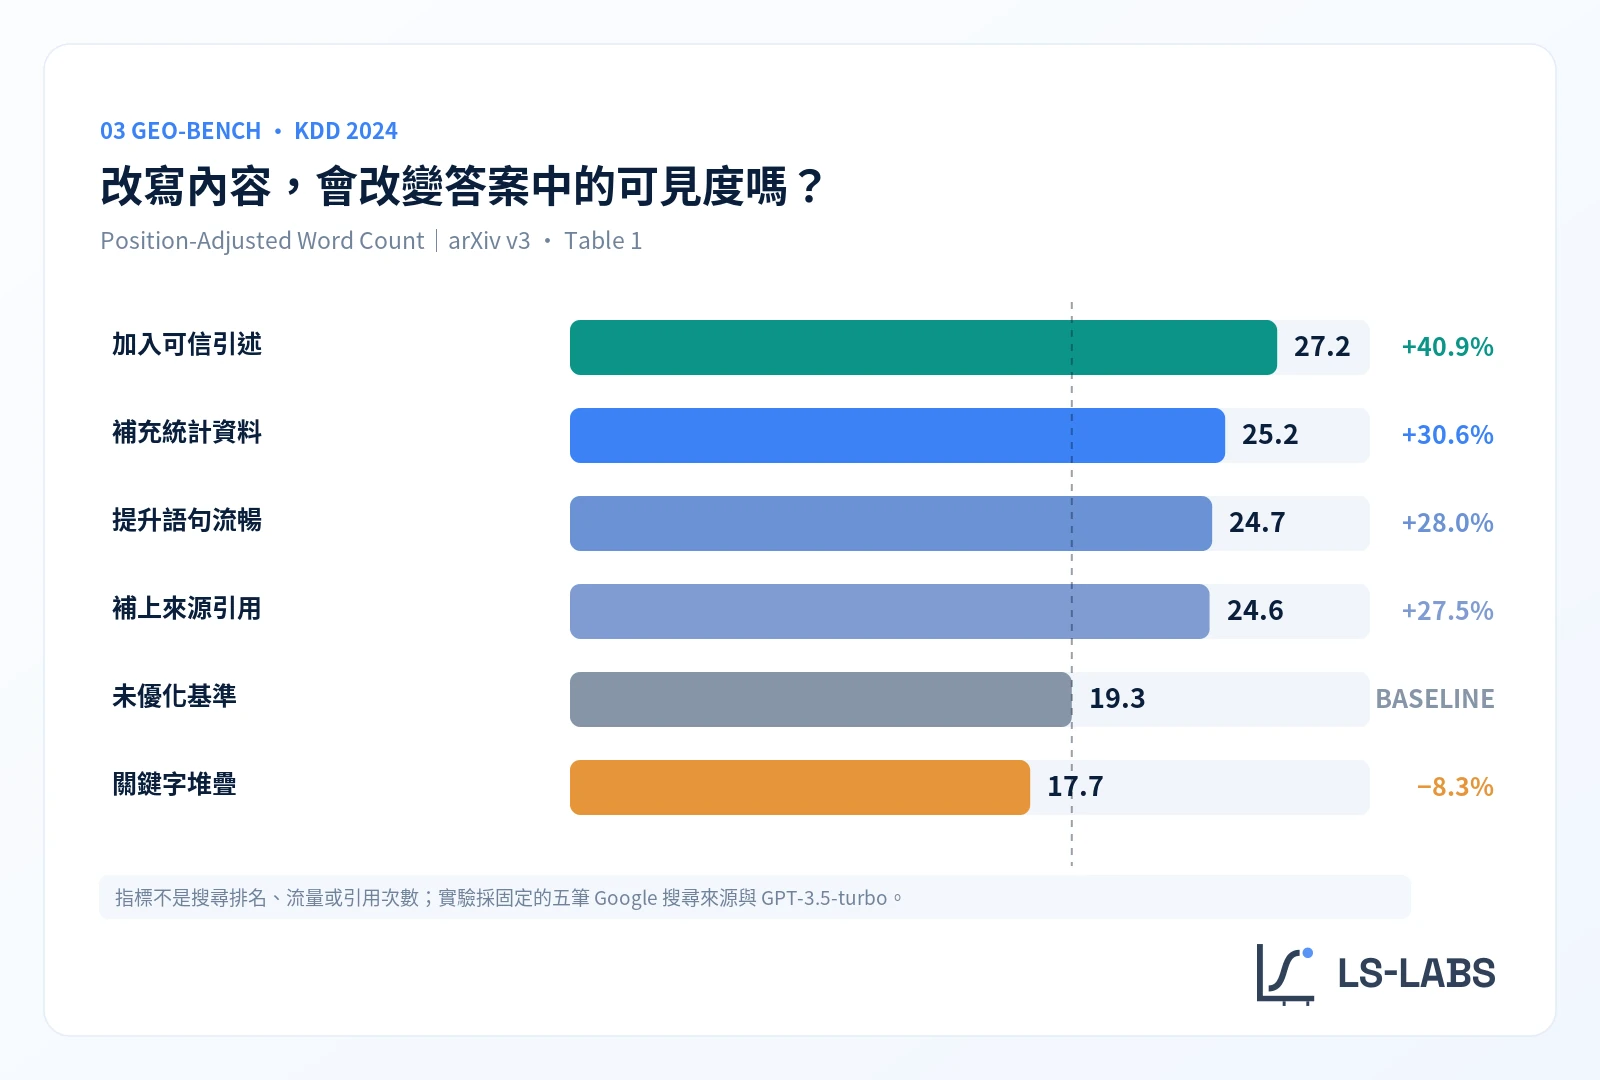
| 内容改写策略 | 做法摘要 | Position-Adjusted Word Count | 相对基准变化 | Subjective Impression(主观印象) |
|---|---|---|---|---|
| Quotation Addition(加入可信引述) | 补充与主题直接相关且具名来源的引述 | 27.2 | +40.9% | 26.9 |
| Statistics Addition(补充统计数据) | 将模糊叙述替换或补上具体定量证据 | 25.2 | +30.6% | 24.0 |
| Fluency Optimization(提升语句流畅) | 改善语法结构与段落可读性 | 24.7 | +28.0% | 24.7 |
| Cite Sources(补上来源引用) | 为文中主张附上可查核的外部出处 | 24.6 | +27.5% | 22.2 |
| Unoptimized(未优化基准) | 维持原始网页抓取内容不变 | 19.3 | 基准线(0.0%) | 19.3 |
| Keyword Stuffing(关键词堆砌) | 比照传统黑帽做法刻意塞入查询词汇 | 17.7 | −8.3% | 20.2 |
综合表 1 与论文后续实验,可以提炼出四点经得起检验的结论与限制:
- 提供具体证据与清晰表达,有助于模型抽取组织答案:在固定候选池中,加入具名引述(27.2)、统计数据(25.2)、流畅化改写(24.7)与标明出处(24.6)均显著优于未优化基准(19.3)。相对地,单纯把语气改得更武断自信(Authoritative)在不同领域表现不一,并未展现同等稳定的提升。
- 关键词堆砌无助于字数位置指标,但评估指标本身会影响结论:Keyword Stuffing 在 Position-Adjusted Word Count 降至 17.7(低于基准 8.3%),在论文另一组 200 题 Perplexity.ai 测试中也从 24.1 跌至 21.9;不过在表 1 由 GPT-4 评分的 Subjective Impression 指标上却微幅升至 20.2。这提醒研究者,单一指标不足以概括所有面向。
- Perplexity 外推实验仍属受控环境:研究团队在 Perplexity.ai 测试时,Quotation Addition 同样将字数位置指标从 24.1 推升至 29.1(约 +20.7%),Cite Sources 在主观印象指标提升最高约 37%。但该实验是以文件上传方式指定系统仅从这五份文字作答,与真实用户在开放网络搜索、由平台自行决定检索池的场景仍有距离。
- 低排名来源在生成阶段有机会翻盘,但前提是先挤进候选池:在多来源同时改写的对抗设定下,原本位居 Google 第 5 名的网页采用 Cite Sources 后,字数位置指标相对暴增 115.1%,而第 1 名来源反而下滑 30.3%。这说明只要能进入前段候选清单,生成模型更看重段落本身的证据密度;同时也要破除坊间常见的误传:诚如本站〈当 AI 开始引用 AI 生成的文章〉所考证,这篇 GEO 论文从头到尾都没有测试“新增 FAQ 区块”,而 Ahrefs 在 2026 年追踪 1,885 个新增 JSON-LD 结构化数据页面的研究,同样未观察到显著的 AI 引用增长。
六、从“相关”到“可用”:拆开四层内容工作
将语义检索机制与 GEO-bench 实验放在一起看,可以把网站面对生成式搜索的工作拆解为四个层次,每一层对应的技术机制与证据强度各有不同:
GEO 内容检视的四个层次
网页必须允许搜索爬虫访问、能被正常渲染与编入索引。若连第一关检索池都进不去,后续任何语义或证据改写都不会生效。
标题、小节与内文需明确交代讨论对象与适用场景。向量检索能容纳同义改写,但精确的专有名词、品牌名与规格描述仍是混合检索的重要锚点。
与其泛谈“企业应重视 GEO”,不如交代观察周期、测试题组设计、提及率与引用率定义及样本限制,让段落本身就具备支撑答案的信息密度。
保留可回溯的原始论文、官方文档链接与核对日期,让模型与人类读者都能分辨哪一句是实证数据、哪一句是合理推论。
在第一层“可被发现”上,网站运营者特别需要区分不同用途的 AI 爬虫。以 OpenAI 官方文档为例,负责为 ChatGPT 搜索建立索引与引用的爬虫是 OAI-SearchBot,而收集模型训练语料的则是 GPTBot;网站可在 robots.txt 独立允许搜索检索并封锁模型训练,但若封锁了 OAI-SearchBot,网页内容就不会作为搜索答案的引用来源出现(OpenAI, n.d.)。各家爬虫的完整权衡可参考本站〈robots.txt 该不该挡 AI?〉。
同时,也必须正面回应针对 GEO 概念最强烈的反方观点。Google 在 2026 年的官方指南直言,从 Google 搜索的运作架构来看,无论外界称之为 AEO 或 GEO,核心依然建立在既有的 SEO 基础与原创内容质量之上;网站不需要追逐长尾问题的每一种问法变体,也不需要为 Google 搜索额外建立 llms.txt(Google Search Central, 2026)。
这份官方立场与“把 GEO 当成取代 SEO 的独门捷径”形成鲜明对比。综合现有证据,最务实的定位是将 GEO 视为观察并改善内容在生成式回答中可见度与归因质量的研究框架:检索入口、重排序权重与最终引用呈现仍由各平台掌控,内容创作者能掌握的则是把可发现性、解题密度与可查证性做好,再通过固定题组反复观测实际变化。
七、即使 AI 附上来源,引用就一定支持那句话吗?
走完前面四层,最后还有一个常被营销报表忽略的盲点:当 AI 回答真的附上你的网址,或者引用了某篇外部报道来介绍你的品牌,那个引用标记真的能支持回答里的那句话吗?
斯坦福大学团队于 EMNLP Findings 2023 发表的〈Evaluating Verifiability in Generative Search Engines〉,曾通过人工逐句核对当时四款生成式搜索引擎(Bing Chat、NeevaAI、Perplexity.ai 与 YouChat)的回答与所附来源(Liu et al., 2023)。研究结果相当警醒:平均只有 51.5% 的生成句子获得所附引用的完整支持(引用召回率),而在系统标出的所有引用链接里,平均也只有 74.5% 确实支持它所挂载的那项叙述(引用精确率)。
这组数字反映的是 2023 年受测系统的历史基准,不能直接套用为 2026 年最新模型的准确率;但它揭示的结构性问题至今依然存在:引用率(Citation Rate)与引用忠实度(Citation Faithfulness)是两把不同的尺。模型可能在整合多篇网页时发生张冠李戴,也可能把来源里带有前提条件的局部数据,改写成毫无保留的普遍断言。
这也是为什么在评估品牌可见度时,单看“品牌被提到几次”很容易失真:模型主动推荐、列为负面警示案例、附上官网链接却写错价格,表面上都算一次曝光,对品牌的实质影响却天差地远。在本站 GEO 主题页与〈AI 搜索时代的检索机制报告〉中,LS-Labs 提出以 MCAC 四项诊断(品牌提及 Mention、来源引用 Citation、信息正确性 Accuracy、行动承接度 Conversion-readiness)分项记录、不混加成单一总分,正是为了把“有没有提到”、“链接到哪一页”、“事实说得对不对”以及“回答有没有给出下一步”拆开检验。
八、结语:从被找到,走向有凭据地被采用
回到文章开头的问题:为什么两篇语义同样贴近问题的文章,最后只有一篇出现在 AI 的回答里?
向量与稠密检索解释了前半段。Embedding 让搜索系统得以跨越字面措辞的差异,在数千万个段落里快速召回意思相近的候选内容;但余弦相似度不会替文章核查事实、不会衡量证据强弱,更无法保证生成模型在改写答案时把功劳归给正确的来源。
如果说传统搜索让内容运营者关心“用户在结果页上看不看得见这个链接”,生成式搜索则多出了一道必须追问的课题:“系统从这个页面取走了哪些信息、说得对不对,又把引用归给了谁?”而当用户的需求从“查信息”再往前跨到“请 AI 智能体直接订位、比价或调用服务”,竞争场域还会进一步延伸到 TSO(工具选择优化)与 AX(智能体体验)。
对网站运营者而言,理解语义检索绝非放弃 SEO 基本功的理由;对研究者而言,也不该把单一向量公式当成跨平台通吃的万灵丹。当提问经过改写展开、候选段落历经混合检索与重排序,最后由语言模型重组为答案,唯有同时具备可检索结构、具体解题密度与一手可查证出处的内容,才更有理由在生成式回答中留下清楚且忠实的引用痕迹。
参考文献与官方资料
学术论文
- Reimers, N., & Gurevych, I. (2019). Sentence-BERT: Sentence embeddings using Siamese BERT-networks. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 3982–3992). Association for Computational Linguistics. https://aclanthology.org/D19-1410/
- Ethayarajh, K. (2019). How contextual are contextualized word representations? Comparing the geometry of BERT, ELMo, and GPT-2 embeddings. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 55–65). Association for Computational Linguistics. https://aclanthology.org/D19-1006/
- Karpukhin, V., Oguz, B., Min, S., Lewis, P., Wu, L., Edunov, S., Chen, D., & Yih, W.-t. (2020). Dense passage retrieval for open-domain question answering. In Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP) (pp. 6769–6781). Association for Computational Linguistics. https://aclanthology.org/2020.emnlp-main.550/
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. In Advances in Neural Information Processing Systems (NeurIPS 2020) (Vol. 33, pp. 9459–9474). https://arxiv.org/abs/2005.11401
- Khattab, O., & Zaharia, M. (2020). ColBERT: Efficient and effective passage search via contextualized late interaction over BERT. In Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '20) (pp. 39–48). ACM. https://doi.org/10.1145/3397271.3401075
- Liu, N. F., Zhang, T., & Liang, P. (2023). Evaluating verifiability in generative search engines. In Findings of the Association for Computational Linguistics: EMNLP 2023 (pp. 7001–7015). Association for Computational Linguistics. https://aclanthology.org/2023.findings-emnlp.467/
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative engine optimization. In Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD '24) (pp. 5–16). ACM. https://doi.org/10.1145/3637528.3671900(本文表 1 与内文数值核对自 arXiv:2311.09735v3 表 1、表 3、表 5 与附录)
官方技术文档与行业研究
- Google Search Central. (n.d.). AI 功能与您的网站. Google Developers. https://developers.google.com/search/docs/appearance/ai-features?hl=zh-tw
- Google Search Central. (2026). 针对 Google 搜索的生成式 AI 功能进行网站优化. Google Developers. https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=zh-tw
- OpenAI. (n.d.). Overview of OpenAI crawlers. OpenAI Developer Platform. https://developers.openai.com/api/docs/bots
- Linehan, L., & Guan, X. (2026, May 11). We tracked 1,885 pages adding schema. AI citations barely moved. Ahrefs. https://ahrefs.com/blog/schema-ai-citations/
本文引用文献与官方文档最后核对日期:2026 年 11 月 4 日。AI 工具用于编程辅助与语言编辑。研究设计、验证、阐释与最终结论由作者审阅。