文章目錄文章開頭0%
過去談到生成式引擎優化(GEO),許多品牌最關心的,是如何讓網站被 ChatGPT 引用,或讓產品出現在 AI 的推薦清單中。
但如果 ChatGPT 一邊推薦產品,一邊提醒使用者「這份排名並未經過獨立驗證」,品牌雖然獲得曝光,使用者又會如何理解這份推薦?
10 月 14 日,Peec AI 的 GEO 研究員 David Konitzny 在 LinkedIn 分享,他們分析了近 300 萬則引用列表文或比較頁的 ChatGPT 對話,發現 GPT-6 成為預設模型後,回答中提醒使用者注意排名可信度、廠商自報數據的情況增加。幾天後,SEO 專家 Lily Ray 也分享了類似觀察。
這是否代表 ChatGPT 改變了對品牌內容的評估方式?對依靠排名文、比較文章及第三方推薦取得 AI 曝光的品牌,又有哪些值得注意的變化?
GPT-6 上線後,ChatGPT 對排名與比較內容的提醒增加
Konitzny 觀察的並非所有 ChatGPT 對話,而是近 300 萬則至少引用一篇列表文或比較頁的對話。他將相關提醒分為兩類,比較 GPT-6 成為預設模型前後的出現比例。
| 提醒類型 | 切換前 | 切換後 | 切換後約為原本的 |
|---|---|---|---|
| 排名或比較未經獨立驗證 | 0.56% | 3.46% | 6.2 倍 |
| 廠商自報數據缺乏獨立驗證 | 1.01% | 2.27% | 2.2 倍 |
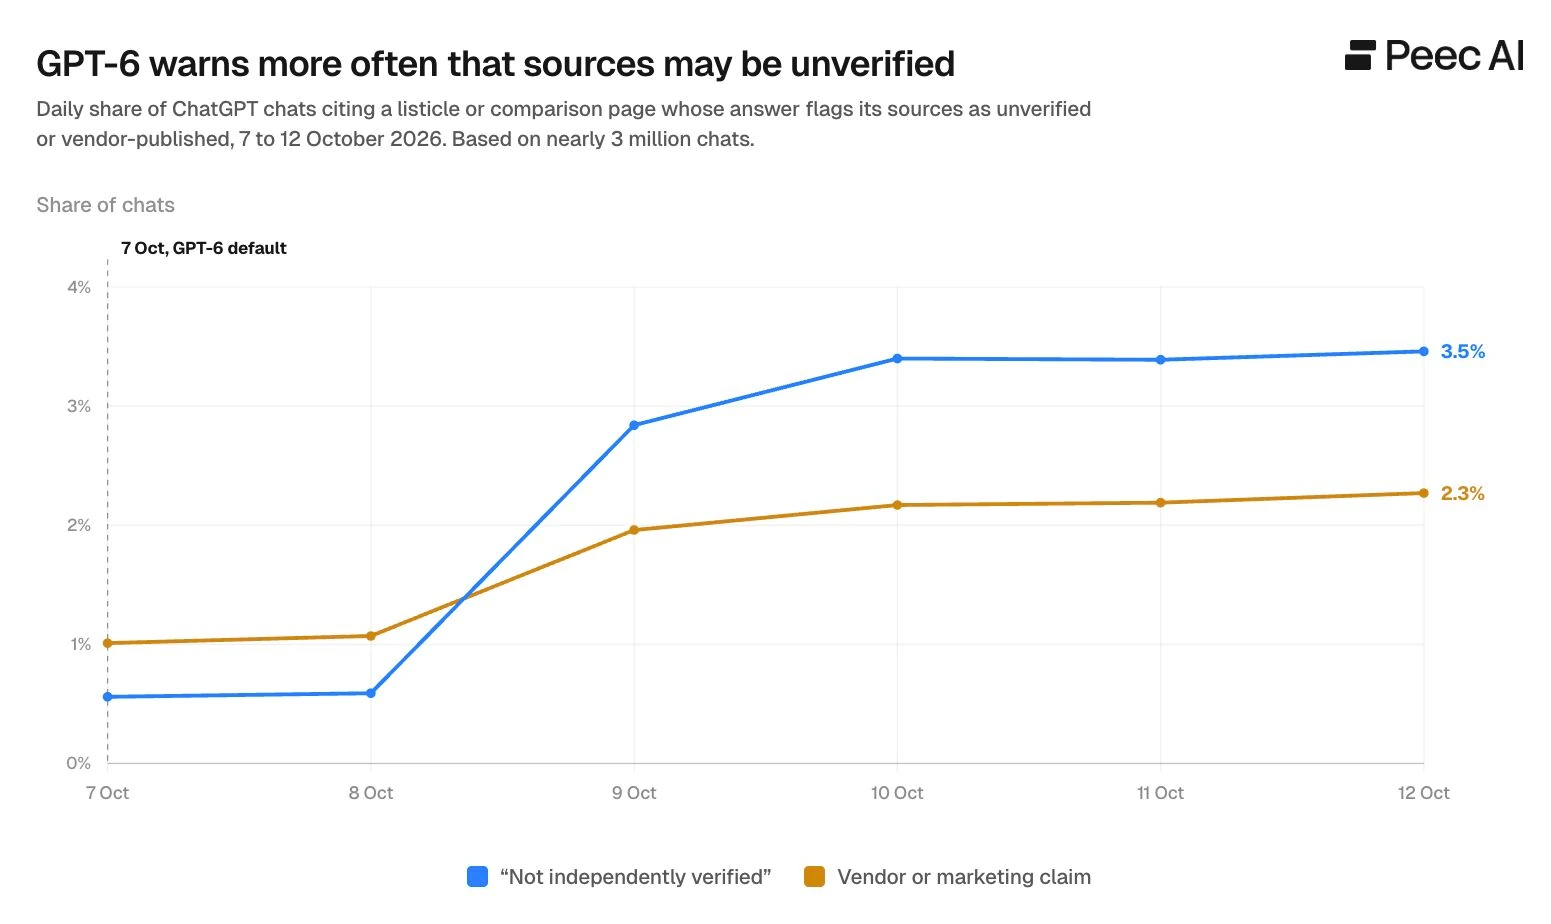
第一類提醒針對排名、推薦清單與產品比較。例如,ChatGPT 引用行銷代理商排行榜時,可能指出排名未經獨立驗證,其中多數資訊來自代理商本身。
第二類關注企業自行公布的準確率、客戶案例或產品效能。如果比較主要依據廠商提供的資料,ChatGPT 可能提醒讀者,這些數據未經第三方測試。
Konitzny 表示,兩類提醒都在模型切換後兩天內增加,之後維持在相近水準。不過,這類提醒並非 GPT-6 才出現,切換前就已有一定比例;近期觀察到的是頻率增加。
提醒增加也不代表列表文失去價值。他在 10 月 9 日的另一份觀察中指出,列表文在 ChatGPT 引用網址中的占比,反而從 6.45% 上升至 9.70%。
這裡的 6.45% 與 9.70% 是引用網址的組成比例,與表格中的提醒對話比例不同。在這些監測樣本裡,ChatGPT 仍會引用列表文,有時則進一步提醒使用者,內容包含尚未驗證的主張。
Lily Ray 的觀察:AI 提醒推薦內容背後的商業關係
10 月 19 日,Lily Ray 在 X 分享,她透過 Peec AI 追蹤一組 B2B 軟體問題,在過去一週約 700 則 ChatGPT 回答中,有 82 則出現不同形式的提醒。其中,19 則特別提醒使用者注意排名與評論內容的撰寫者或來源。
提醒包括廠商在自家比較頁替自己排名、評論網站與被評論品牌存在關係、付費評論與贊助版位,以及某些推薦可能主要為了推廣聯盟行銷連結。部分回答也會說明,ChatGPT 自己的推薦清單未經獨立測試,或提醒使用者留意 Reddit 討論的贊助關係與客觀性。
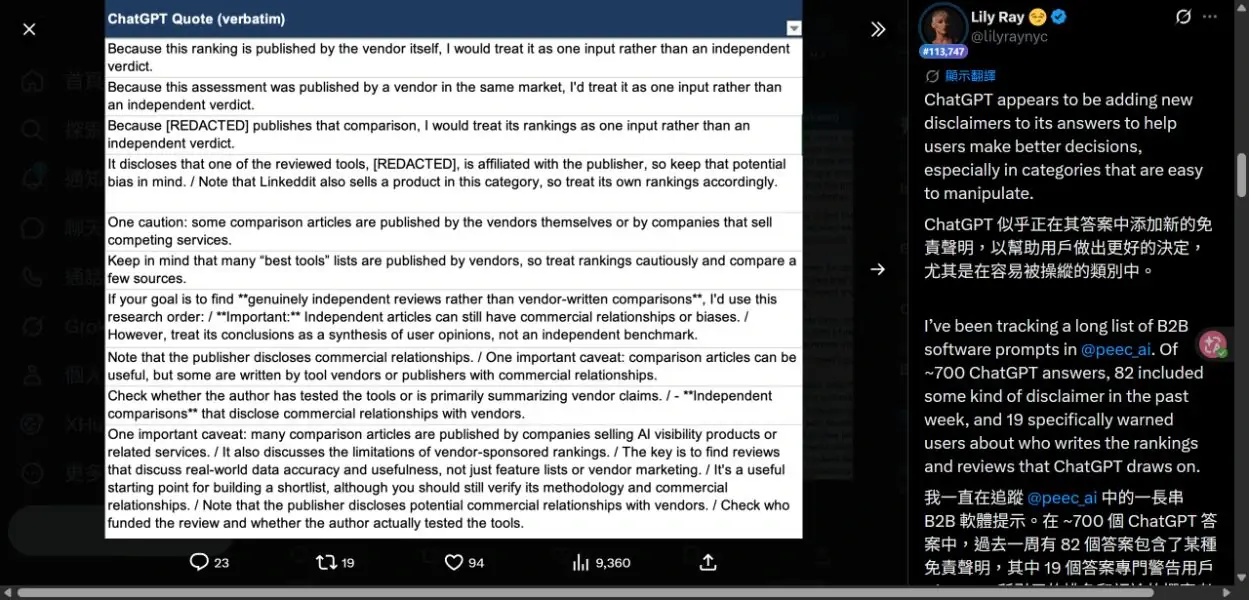
這些並非新問題。Lily Ray 對照傳統搜尋指出,搜尋引擎長期透過排名系統、評論品質評估與垃圾內容政策處理相關內容,而這些判斷通常發生在使用者看不見的地方。
值得觀察的差異是,當 AI 在推薦產品時直接說明來源可能存在的利益關係,這些疑慮便可能成為回答的一部分。
不過,這份觀察集中在 B2B 軟體;82 則包含各種提醒,不全是對廠商比較內容的質疑。貼文也沒有提供模型切換前的同組數據,無法直接推論提醒增加了多少。
此外,Konitzny 是 Peec AI 的研究員,Lily Ray 使用的同樣是 Peec AI。兩份觀察都與這家 GEO 監測工具廠商有關,不能當成完全獨立的交叉驗證。
Lily Ray 表示,提醒往往只占回答的一小部分,可能是推薦清單結尾的一兩句話。她將此視為 AI 平台處理推薦品質問題的暫時措施;這是她的解讀,並非 OpenAI 已確認的產品策略。
這是 OpenAI 刻意調整的結果嗎?
目前還不能下定論。
依照 OpenAI 官方發布紀錄,GPT-6 從 2026 年 10 月 7 日起向 Plus、Pro、Business 與 Enterprise 使用者陸續推出,Free 與 Go 則從 10 月 8 日開始,Enterprise 仍取決於管理員設定。
10 月 7 日的官方公告也提到,第一批 GPT-6 模型在 9 月就已提供給付費客戶。因此,模型首次推出與 ChatGPT 預設模型切換,應視為不同事件。
截至 2026 年 10 月 23 日本文修訂時,在本次核對的 GPT-6 公告、ChatGPT 發布紀錄與系統卡中,未見 OpenAI 將「提高對排名文、比較頁及廠商自報數據的提醒頻率」明列為產品更新。
GPT-6 系統卡雖然談到模型更少對無害請求添加過度或帶有評判性的附註,但該段屬於安全性與模型回應評估,不能直接用來解釋這次的來源提醒。
因此,Konitzny 的數據較適合被理解為模型切換前後的相關現象,還不是模型更新造成變化的因果證據。他的貼文未完整公開提醒分類方法、提示詞組成、前後觀測時間長度,以及不同產業的差異,這些因素都可能影響統計。
對品牌而言,還有一個關鍵限制:現有資料沒有證明,提醒增加會讓消費者降低信任、減少點擊,或改變購買決策。
被 AI 引用,不代表內容一定被採信
品牌常用引用次數、品牌提及率,以及進入推薦清單的頻率衡量 GEO 表現。這些指標衡量的是曝光與出現機會,無法完整呈現 AI 如何描述品牌。
例如,使用者問 ChatGPT:「有哪些值得推薦的 GEO 監測工具?」回答可能列出五款工具,並引用廠商撰寫的比較文章。如果它同時補充,這份比較主要來自業者自行公布的資料、尚未經過獨立測試,使用者接收到的資訊就不只有產品優勢。
這不表示 ChatGPT 已判定產品不可信,但品牌至少應分開觀察三件事:
- 引用來源:AI 引用的是品牌官網、第三方文章,還是評論網站?
- 回答內容:品牌被正面推薦、客觀比較,還是伴隨特定限制與警語?
- 實際成效:使用者是否進一步造訪網站、詢問產品或完成轉換?
Konitzny 的觀察主要涉及前兩者,尚不足以證明第三者受到影響。不過,單看引用率,確實可能漏掉回答內容的重要細節。
學術研究也指出,內容被檢索與被引用是不同階段
10 月 10 日,Mahe Chen 與 Nick Koudas 在 arXiv 提交的研究《What Drives AI Citations?》,從另一個角度分析生成式搜尋的引用機制。
研究使用 ChatGPT、Gemini 與 Perplexity 對商業問題的 API 回答資料,再透過 API 重現部分檢索過程。它研究的是頁面被檢索後,哪些因素與進一步被引用有關。
在控制 ChatGPT 檢索結果排名等因素後,品牌自有頁的被引用勝算比約為 1.71,列表頁為 0.54,比較頁為 0.34。這些是特定研究條件下的相對勝算比,不能直接當成所有網站的引用率。
研究也發現,將比較範圍縮小到同一網站時,FAQ 區塊與 Schema 結構化資料等常見做法,未呈現穩健且顯著的引用優勢。相較之下,內容與使用者問題、模型檢索查詢的語意關聯更值得注意。
但論文沒有研究來源免責提醒,ChatGPT 實驗使用的也是 GPT-5.4-nano API,並非 GPT-6 消費版,不能拿來證明 GPT-6 為何更常添加提醒。
Chen 與 Koudas 關注「哪些頁面被檢索後會得到引用」;Konitzny 關注「已被引用的內容,是否仍伴隨可信度提醒」。兩者處於不同階段,也顯示 GEO 評估可以從網站是否進入參考來源,進一步看最終回答如何呈現品牌。
品牌應該如何檢查自己的 GEO 內容?
現階段不需要因此全面停止製作列表文或比較文章。Konitzny 的另一組數據顯示,列表文仍是 ChatGPT 的引用來源;兩類提醒的比例分別為 3.46% 與 2.27%,也不能放大成普遍規則。
比較務實的做法,是先檢查一個產品或服務類別。以下是依上述觀察提出的編輯與量測建議,並非 OpenAI 公布的優化規則。
1. 用實際購買情境測試 AI 回答
整理 10~20 個潛在客戶可能提出的問題,涵蓋產品推薦、品牌比較、價格差異與適用情境。在 ChatGPT 中使用相同問題多次測試,記錄日期、介面與模型版本、帳號類型、品牌是否出現,以及回答有沒有來源提醒,並保存完整回答與引用網址。
不同模型、時間與對話情境都可能造成差異,單次截圖不足以代表穩定表現;API 監測結果也應與 ChatGPT 網頁或 App 的測試分開記錄。
2. 不只記錄引用率,也檢查 AI 如何描述品牌
針對每則回答,區分品牌是否被提及、是否進入推薦清單,以及引用來自何處。出現提醒時,再記錄它針對未驗證排名、廠商自報數據、贊助關係,還是 AI 自己的推薦限制。
也要確認提醒針對的是品牌、引用網站,還是整份推薦清單,避免把所有警語都當成品牌受到負面評價。若品牌依賴 Reddit 等使用者生成內容(UGC)取得曝光,也可一併檢查相關描述。
3. 檢查比較頁、排行榜與成效主張
官網若有「十大最佳工具」、競品比較或成效案例,應確認資料來源、評比方法與商業關係是否清楚。品牌自行測試的結果,有沒有交代測試時間、樣本數、比較條件與計算方法?排名由誰製作?贊助與聯盟行銷關係是否揭露?
這些資訊能幫助讀者判讀內容,但增加揭露聲明不等於一定能提高 AI 引用或改善推薦結果,目前沒有足夠數據支持這種效果。
4. 持續監測,並搭配網站實際成效
每月用固定問題重測,觀察引用來源、品牌推薦與提醒內容的變化。如果某類比較文章開始頻繁出現特定警語,再檢查是否有資訊不足、過時數據或未揭露的利益關係。
同時可透過 GA4 觀察 ChatGPT 帶來的可識別造訪與轉換。但並非所有造訪都能正確歸因,缺少來源資訊時也可能被歸入 Direct,不能只看 ChatGPT referral 流量判斷全部成效。
GEO 的下一個問題,可能不只是如何增加引用
目前能確認的是,Konitzny 在 GPT-6 預設模型切換前後的監測樣本中,觀察到未驗證排名與廠商自報數據提醒增加;Lily Ray 也在 B2B 軟體類別看到相關提醒。這些資料尚未證明 OpenAI 正式改變來源評估政策,也無法推論所有產業都有相同情況。
品牌投入 AI 搜尋曝光時,引用是一項指標;引用出現在哪種問題、品牌如何被描述,以及回答是否附帶來源限制,同樣會影響對曝光品質的判讀。
品牌需要理解的,不只是自己有沒有出現在 AI 回答中,還有使用者透過這份回答,究竟認識到什麼樣的品牌。
現階段沒有證據顯示這些提醒已系統性改變購買決策。比起立即追逐新的優化技巧,可以先從現有比較頁、產品資料與成效案例開始,確認哪些主張能被外部查證,哪些仍只是品牌自己的說法。
常見問題
GPT-6 會對所有品牌排行榜添加免責提醒嗎?
不會。Konitzny 的監測結果顯示,排名未經獨立驗證的提醒占相關對話約 3.46%,廠商自報數據提醒約 2.27%。分母是至少引用一篇列表文或比較頁的對話;兩類可能重疊,不能相加,也不代表所有 ChatGPT 對話的比例。
ChatGPT 開始質疑比較文,代表 GEO 不應該再做排行榜嗎?
不能這樣解讀。Konitzny 的另一項觀察指出,列表文在 GPT-6 切換後的引用網址占比反而上升。品牌仍可製作有實際比較價值的內容,並清楚交代資料來源、評比方法與商業關係;這些做法是否改善 AI 引用,仍需另外驗證。
ChatGPT 引用率增加,就代表 GEO 成效改善嗎?
不一定。引用率主要衡量來源曝光,還需要搭配品牌是否被推薦、回答內容、網站造訪與實際轉換評估。品牌也可能被提及,卻沒有獲得可追蹤的網站流量。
參考資料
- David Konitzny:GPT-6 is becoming more critical of claims,2026 年 10 月 14 日。
- David Konitzny:ChatGPT has a new default model: GPT-6,2026 年 10 月 9 日。
- Lily Ray:ChatGPT 來源提醒觀察,2026 年 10 月 19 日。
- OpenAI:ChatGPT Release Notes,本次核對 2026 年 10 月 7 日發布紀錄。
- OpenAI:GPT-6 and Intelligent UI for everyone,2026 年 10 月 7 日。
- OpenAI:GPT-6 Sol and GPT-6 Luna: October 2026 update,2026 年 10 月 7 日。
- Chen 與 Koudas:What Drives AI Citations? Content, Retrieval and Model Knowledge in GEO,arXiv 預印本,2026 年 10 月 10 日。